Every Signal:一小时完成公司尽调,每个数字都有来源
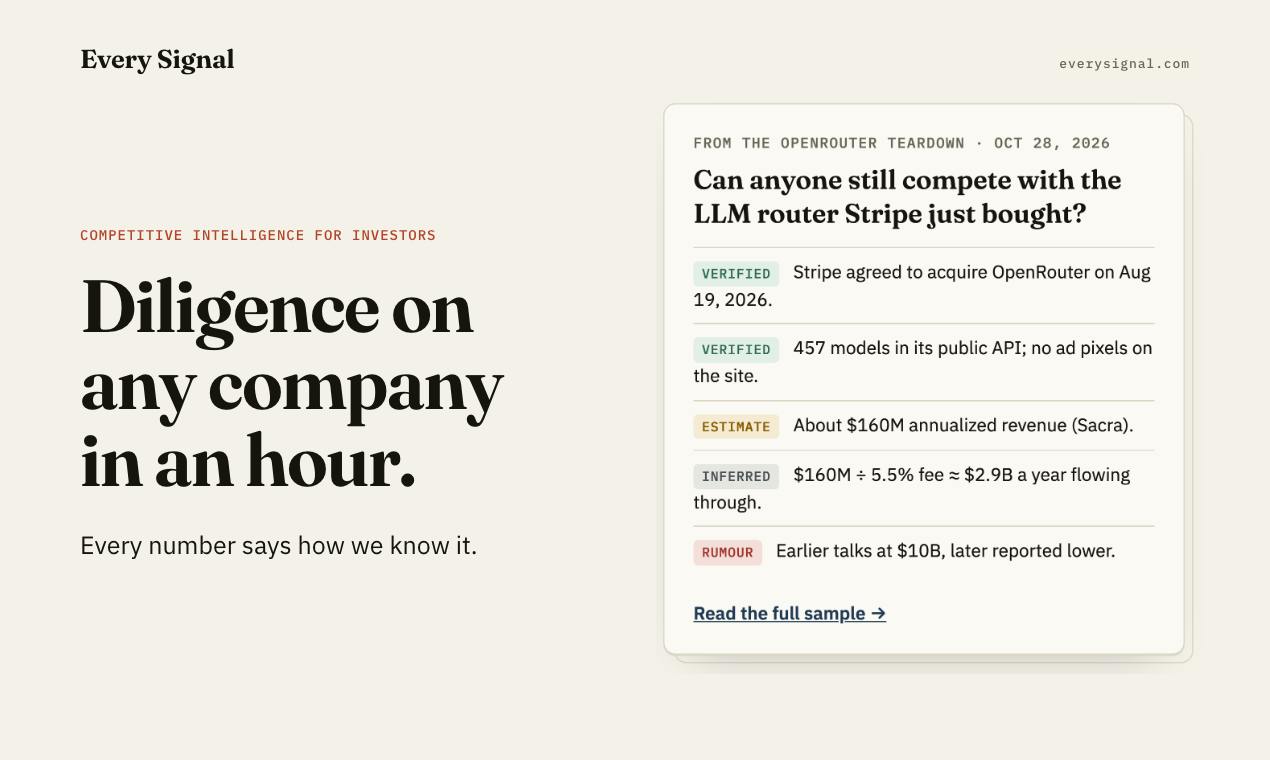
Every Signal 用四档置信度标注和持续监控,把公司尽调压缩到一小时。
Every Signal 是一款基于研究智能体的尽调工具,用户输入公司名和问题后,可在一小时内获得覆盖流量、广告投放、追踪技术栈、定价、收入推算、竞争对手和行业规则的拆解报告。其核心设计是为每个数字标注 verified、estimate、inferred、rumour 四档置信度,解决 AI 报告可信度不透明的问题,并在初始报告后持续监控目标公司变化。该工具主要面向小规模投资团队、独立分析师、增长营销人员和创业者,但收入推算等估算结论受方法论偏差影响,适合作为量级参考而非精确依据。
当尽调从几周压缩到一小时
做投资或竞争分析的人都有过这种体验:为了摸清一家公司的底细,需要打开十几个标签页——流量估算工具、广告情报平台、招聘网站、财报、新闻稿,然后把碎片信息拼成一张图。这个过程动辄数天,而且每个数字的来源可靠性参差不齐。
Product Hunt 上出现的新工具 Every Signal 试图改变这件事。它的主张很直接:输入一家公司和你想了解的问题,研究智能体返回一份带来源的拆解报告,覆盖流量、广告投放、追踪技术栈、定价、收入推算、竞争对手和行业规则。按官方说法,整个过程可以在一小时内完成。
这个产品在 Product Hunt 上获得了 77 票,排名当日第 17 位,有 4 条评论。数据不算爆发式增长,但定位切中了一个真实的高频痛点——投研和商业分析中的信息搜集环节。
核心机制:给每个数字贴上可信度标签
四档置信度分类
Every Signal 最有辨识度的设计,是它对信息来源做了四级标注:verified(已验证)、estimate(估算)、inferred(推断)、rumour(传闻)。
这看起来是个小功能,实际解决的是 AI 研究工具最大的信任障碍。大语言模型生成的分析报告往往语气笃定,读者很难分辨哪句话来自官方披露,哪句话是模型外推的产物。把置信度显式暴露出来,等于把判断权交还给使用者:你可以只信 verified 数据,也可以把 rumour 当作线索去进一步核实。
置信度分级在情报分析领域并非新概念,但将其产品化并嵌入 AI 生成流程中,是近年研究智能体的新尝试。传统投研中,分析师会在报告中用脚注或附录标明数据来源,但这种方式难以量化不确定性。Every Signal 的四档标注借鉴了情报界常用的“可信度评估”框架(如 NATO 的 Admiralty Code,将信息来源可靠性与信息本身可信度分开评级),不过做了简化,更聚焦于“信息如何得出”这一维度。对用户而言,理解四档之间的边界很重要:verified 通常指直接来自官方披露或可公开验证的数据;estimate 是基于模型或假设的推算;inferred 是从间接线索推导出的结论;rumour 则是来自非权威渠道的未证实信息。
覆盖维度与收入推算
从产品描述看,输出覆盖的维度偏向增长与商业化侧:流量结构、广告投放情况、网站追踪栈(能反推对方用了哪些分析或营销工具)、定价体系,以及基于这些数据做的收入推算。竞争对手和监管规则的梳理则补上了市场位置的拼图。
收入推算这类内容天然属于 estimate 档位——它依赖流量和转化假设,不同方法论会得出差异很大的结果。Every Signal 的做法是把这个估算过程标注清楚,而不是伪装成事实。
网站追踪栈(tracking stack)指一家公司网站或产品中嵌入的第三方分析、广告、标签管理等工具,例如 Google Analytics、Meta Pixel、Hotjar 等。通过识别这些脚本,外部观察者可以反推对方使用的营销渠道、数据采集能力和技术偏好。这类信息通常可通过公开网页源代码或浏览器插件获取,属于可验证的间接证据。收入推算则常采用“自下而上”的方法:先估算流量,再结合行业平均转化率、客单价和复购率,推导出收入区间。由于转化率和客单价往往缺乏公开数据,模型需要做出假设,因此这类结论天然带有较大不确定性,不同方法可能得出数量级差异。
持续监控:从一次性报告到动态追踪
产品描述里还有一句容易被忽略的话:"Then it watches for changes"。意思是它在生成初始报告之后,会持续监控目标公司的变化。
这个设计把工具从"一次性尽调"推向"持续情报"。对于跟踪竞争对手或持仓标的的用户来说,静态报告的折旧速度很快——对方改了定价、换了广告渠道、上线了新追踪工具,旧报告就部分失效。自动监控变化相当于给报告加了保鲜机制。
不过官方没有说明监控的触发粒度、通知方式和更新频率,这部分能力目前只能从产品页的描述中推断,实际效果需要上手验证。
谁适合用,边界在哪
目标用户
从功能组合判断,最直接的受益者是小规模投资团队、独立分析师、增长营销人员和创业者。这类用户需要快速建立对一家陌生公司的认知框架,但往往没有预算购买多个专业数据终端。
需要警惕的地方
研究智能体的输出质量高度依赖底层数据源的可及性。流量估算、广告情报这类数据在行业内有几家成熟供应商,不同来源之间的偏差本身就不小。Every Signal 把来源标注出来是正确的一步,但用户仍需自己判断:这个 verified 是基于官方财报,还是基于第三方数据库的抓取。
另外,收入推算涉及的数学假设(客单价、转化率、复购)如果完全由模型自动填充,误差可能相当可观。把它当作量级参考而非精确数字,是更稳妥的用法。
流量估算和广告情报数据在行业内存在多家供应商,如 SimilarWeb、Semrush、Sensor Tower 等,它们各自基于不同的数据面板(panel)、爬虫和合作数据源,估算结果常有 20%-50% 甚至更大的偏差。因此,即便 Every Signal 标注了 verified,用户也需要确认该标签对应的底层来源是官方财报、第三方数据库还是模型推断——官方标注的“已验证”并不等同于“绝对准确”,只是说明信息来源相对可靠。对于收入推算,建议用户要求工具展示关键假设(如转化率、客单价),并自行做敏感性分析,避免将单一估算值当作决策依据。
小结
Every Signal 切入的是 AI 研究工具竞争的下半场:不再是比谁能生成更长的报告,而是比谁的信息更可追溯、更可验证。四档置信度标注和持续监控这两个设计,指向的正是这个方向。
对于需要频繁做轻量级尽调的用户,这类工具能显著压缩信息搜集的时间成本。但它替代的是初级研究员的搜集与整理工作,而非判断本身——哪些数字可信、哪些假设合理,仍然需要人来拍板。
(完)
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。