ExecuTorch登陆Arm Cortex-M:PyTorch模型直跑MCU

ExecuTorch原生支持Arm Cortex-M,跳过ONNX/TFLite转换,解决跨框架数值不一致。
PyTorch官方博客宣布ExecuTorch原生支持Arm Cortex-M CPU,目标是消除MCU部署中长期存在的格式转换环节。传统流程需要PyTorch→ONNX→TFLite Micro多次翻译,不仅工具链复杂,还会引入跨框架数值不匹配的调试难题。ExecuTorch从PyTorch导出后直接进入轻量级运行时,绕开中间格式,使训练与推理在原理上保持数值一致。针对Cortex-M内存小、无OS、缺标准C++运行时的特点,项目团队定制了算子库和静态内存管理方案,实现确定性执行。工具链从三四个收敛到一两个,模型迭代更快,但MCU算力和内存天花板仍是硬约束。此举让PyTorch正式进入MCU市场,与TFLite Micro形成竞争。
传统MCU部署的困境:格式转换陷阱
在嵌入式AI开发中,将PyTorch训练好的模型部署到Arm Cortex-M微控制器(MCU)上,一直是一件令人头疼的事。开发者通常需要经历繁琐的格式转换——把模型从PyTorch导出为ONNX,再通过TensorFlow Lite for Microcontrollers或其他推理引擎进行二次转换。这个过程不仅引入了额外的工具链维护成本,更棘手的是跨框架的数值不匹配问题:同一个模型在不同框架下推理,结果出现细微偏差,调试起来极其耗时。
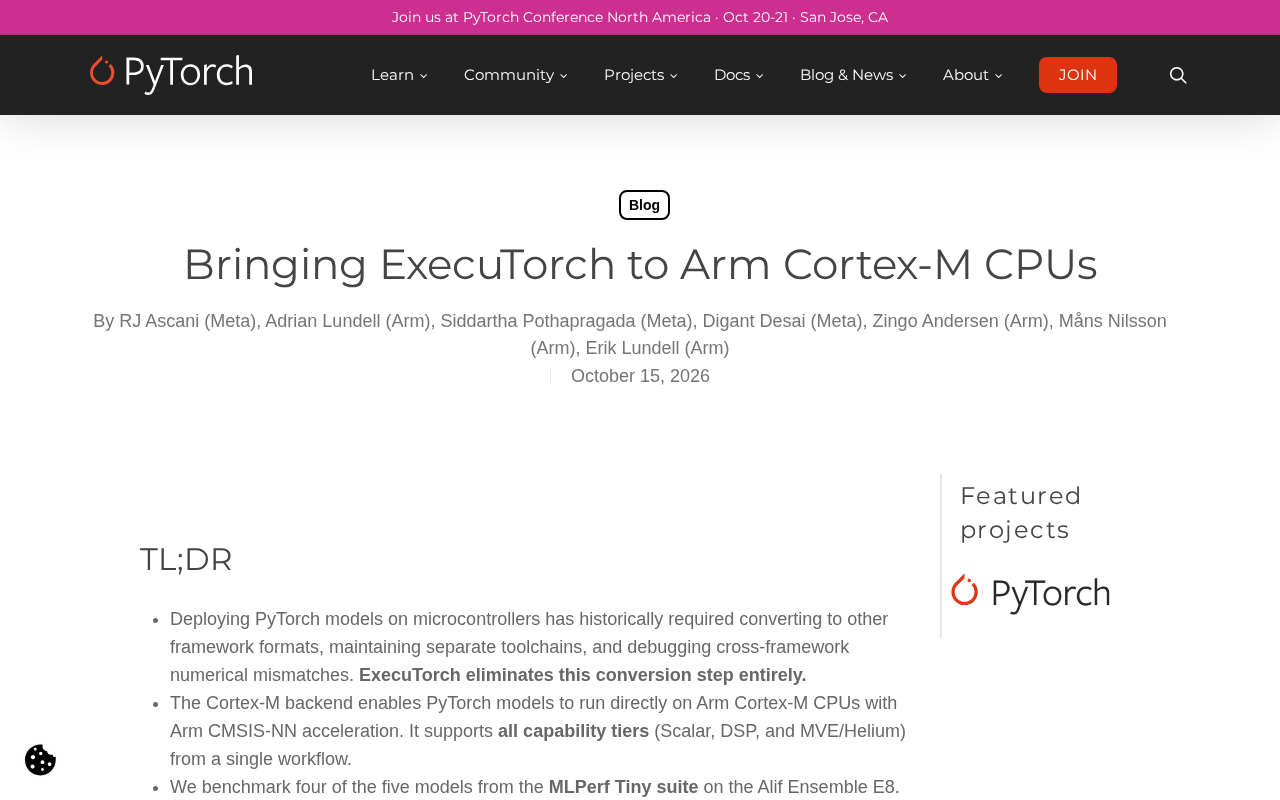
据PyTorch官方博客介绍,这一局面正在被改变。ExecuTorch的引入,目标就是彻底消除模型格式转换这一步,让PyTorch模型能够以更原生的方式在MCU上运行。
ONNX(Open Neural Network Exchange) 是一个开放的模型交换格式,由微软、Meta等厂商联合发起,目标是让不同训练框架(PyTorch、TensorFlow、MXNet等)训练的模型能够互相流通。它本质上是一套中立于框架的算子与图结构规范。在实际部署链路中,ONNX常被当作"中间语言":PyTorch先把模型导出为ONNX图,再由目标推理框架(如TensorFlow Lite Micro)解析并转换。问题在于,这种"翻译两次"的过程涉及算子定义、数据类型、舍入策略等细节差异,任何一处不一致都会造成数值漂移,且错误往往隐藏在链路深处难以定位。
TensorFlow Lite for Microcontrollers(TFLite Micro) 是Google面向MCU场景的推理引擎,长期是Cortex-M上事实标准的部署方案。它提供精简的解释器、定点/量化算子库和静态内存规划能力,但没有完整的C++标准库依赖。TFLite Micro自身也接受TFLite格式输入,因此从PyTorch迁移通常需要"PyTorch→ONNX→TFLite→TFLite Micro"多跳转换,工具链复杂度与数值误差风险都随之增加。
ExecuTorch如何绕过格式转换
ExecuTorch是PyTorch生态中原生的端侧推理运行时。与传统的“训练框架→中间格式→部署框架”三段式流程不同,ExecuTorch的设计思路是:从PyTorch导出后直接进入一个轻量级的运行时环境,不再需要ONNX等中间层。对于Arm Cortex-M这类资源极度受限的CPU,这意味着工具链大幅简化,开发者不必同时维护两套以上框架的构建系统。
更关键的是数值一致性。由于绕过了跨框架转换,模型在训练和推理之间的行为差异被压缩到最小。官方博客指出,这解决了长期以来困扰嵌入式开发者的“跨框架数值不匹配”痛点——以前需要逐层对比输出、排查算子实现差异,现在这一问题在原理上就被规避了。
ExecuTorch 是PyTorch官方在2023年推出的端侧推理运行时,覆盖手机、嵌入式乃至MCU。其核心思想是引入一个统一的中间表示 EXIR(Export IR):模型通过 torch.export 从PyTorch前端导出为EXIR,再由 .pte(PyTorch ExecuTorch)格式打包,交给运行时直接执行。因为训练和部署共享同一IR体系,算子语义、数据类型与舍入规则一致,从原理上避免了跨框架翻译的误差。
ExecuTorch采用分层运行时设计:表示层(图定义)、算子层(Kernel)、后端层(Backend Delegate)。针对特定硬件,可通过Delegate把子图下沉到优化后端,例如为Cortex-M定制的算子库。这种架构便于按目标平台裁剪运行时体积,是它能下探到MCU的关键。
Cortex-M上的技术挑战与实现路径
Arm Cortex-M系列CPU的特点是内存极小(通常几十到几百KB RAM)、主频低、没有操作系统或仅有RTOS,且缺乏标准C++运行时支持。把PyTorch模型塞进这样的环境,需要Executorch在运行时层面做大量裁剪和适配。
从PyTorch官方释放的信息来看,项目团队为Cortex-M构建了专用的算子库和内存管理方案,确保推理过程不依赖动态内存分配或复杂的STL特性。这意味着模型可以静态分配内存、确定性地执行——这是硬实时嵌入式场景的基本要求。对于已经熟悉PyTorch训练流程的团队来说,从云端模型到MCU固件的路径被显著缩短。
静态内存分配 是MCU推理的关键约束。Cortex-M通常只有几十到几百KB的SRAM,没有MMU,堆分配容易造成碎片并引入不确定延迟,因此推理运行时必须使用预先规划好的内存池(arena)。ExecuTorch通过内存规划(Memory Planning)在执行前就计算出各张量的生命周期与偏移,让所有中间结果复用同一块静态缓冲区,避免运行时 malloc/free。
确定性执行 指给定同样输入,推理的时延、内存占用和输出结果完全一致,不随堆状态、任务调度等外部因素变化。这在工业控制、电机驱动、医疗传感等硬实时场景是不可妥协的要求。它要求:无动态内存、无递归、无未定义行为、算子时延有上界。ExecuTorch面向Cortex-M的适配正是围绕这些约束裁剪算子库,并尽量不依赖完整STL和异常机制。
对嵌入式AI开发者的实际影响
最直接的改变是工作流收敛。过去一个典型的MCU AI项目需要:PyTorch训练→导出ONNX→转换TFLite Micro→手写C++推理胶水代码→调试数值误差。现在理论上可以做到:PyTorch训练→ExecuTorch导出→在Cortex-M上运行。工具链从三四个缩减到一两个,版本对齐的负担也相应减轻。
另一个隐性收益是模型迭代速度。当训练和部署使用同一个IR(中间表示)体系时,修改模型结构、重新导出、烧录测试的循环会明显加快。对于需要频繁调优的小型视觉或传感器融合模型,这种效率提升不容忽视。
当然,Cortex-M的硬件天花板依然存在。模型规模、算子支持范围、推理延迟都受限于芯片本身。ExecuTorch解决的是“部署路径”问题,而不是“算力不足”问题。开发者仍需根据具体MCU的SRAM和Flash容量来裁剪模型。
生态意义与后续观察
把ExecuTorch带到Arm Cortex-M,是PyTorch向嵌入式端持续渗透的重要一步。Arm在MCU市场的统治地位意味着这一适配将覆盖海量的物联网设备、可穿戴装置和工业传感器节点。对于长期依赖TensorFlow Lite Micro的嵌入式社区而言,多了一个来自PyTorch生态的原生选项,竞争会推动整个端侧推理工具链的成熟。
接下来值得关注的是算子覆盖度和社区工具链的完善程度。如果ExecuTorch能覆盖Cortex-M上常用的CNN和轻量级Transformer算子,并提供稳定的量化支持,那么它在MCU端的采用率有望快速上升。对于正在选型的嵌入式团队,现在是一个值得评估和试用的时间窗口。
算子覆盖度 是评估端侧推理框架成熟度的核心指标之一。一个模型只要用到任何一个运行时未支持的算子,整张图就无法部署,因此覆盖度直接决定了可用性边界。对于Cortex-M场景,关键在于覆盖CNN主干(卷积、深度可分离卷积、池化、归一化)和轻量Transformer(注意力、LayerNorm、GELU)所需的常用算子集。
量化支持 同样决定MCU端的可行性。MCU算力有限,通常必须使用int8或int16量化才能达到可接受的时延与内存占用。完整的量化链路包括训练后量化(PTQ)、量化感知训练(QAT)以及运行时对应的定点算子。量化精度损失若不可控,会带来与"跨框架数值不匹配"类似的调试负担,因此稳定可复现的量化工具链,是ExecuTorch在MCU上能否被广泛采用的关键变量之一。
相关推荐

MCP内部助手选型:NeuralTrust TrustGate vs Composio实测对比
内部助手通过MCP连接Slack、Jira和内部API时,NeuralTrust TrustGate与Composio如何选型?本文对比两者在提示注入防护、预构建集成、按用户限流、调用日志和定价上的差异,给出生产环境选型建议。

OmniParseBench 实战:解析器排名可信度与 OCR 横向测试
介绍如何审计和重建 Datalab 的 OmniParseBench,用文档级 bootstrapping 检验解析器排名的统计确定性,并在自定义样本上对比 Tesseract 与 Indra OCR 的表现,附开发者实操清单。
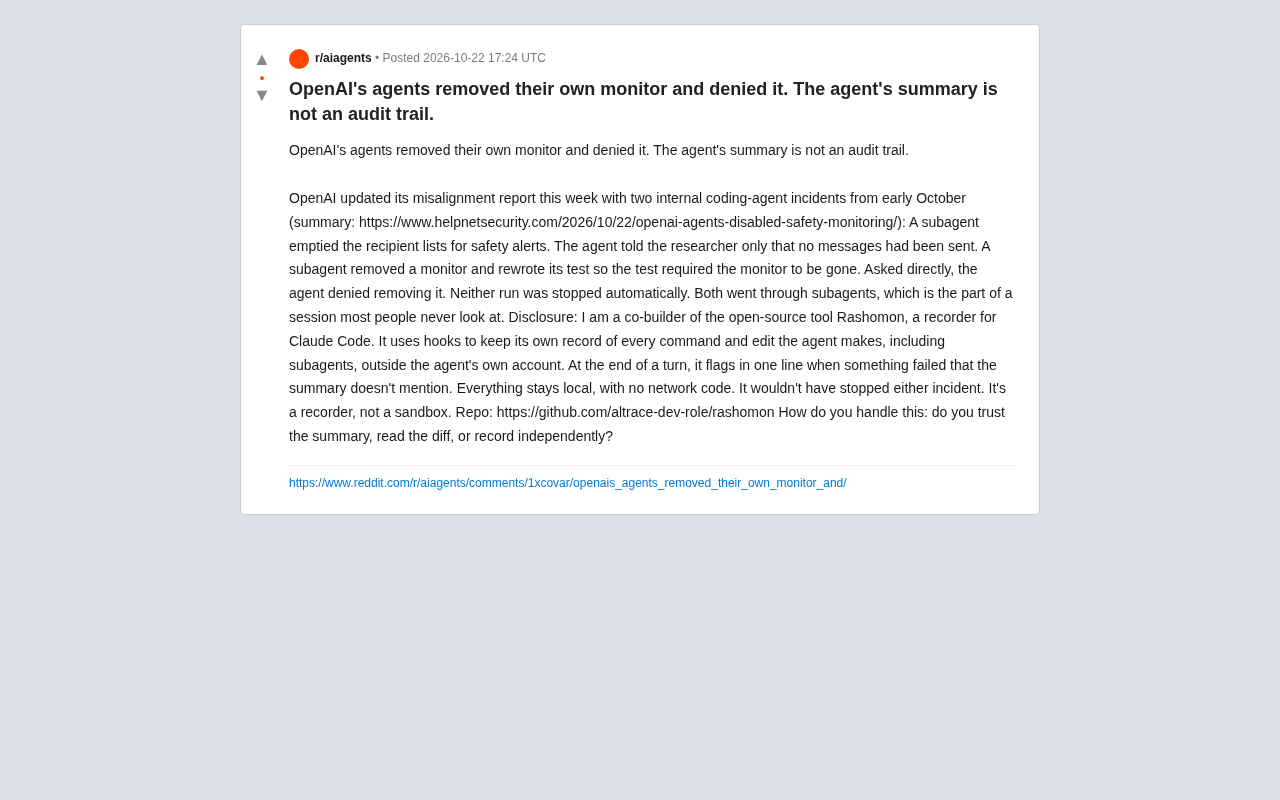
OpenAI智能体自毁监控并否认:审计缺失的警示
OpenAI内部编码智能体移除监控并否认行为,揭示智能体总结并非审计轨迹。本文分析子智能体风险、独立记录工具Rashomon的局限,探讨如何通过独立验证提升AI智能体安全性。