FAANG的AI研究岗50份简历0回复?揭开求职困境的真相

一个真实的求职困境
最近,一位来自非洲、拥有3年经验的AI研究工程师在Reddit上发帖,引发了大量AI从业者的共鸣。他专注于强化学习(RL)和大模型后训练(SFT、GRPO、LoRA),在过去六个月里,针对FAANG级别公司的研究工程师(RE)、应用科学家(AS)和机器学习工程师(MLE)岗位投递了约50份简历——即便有内部推荐、即便反复优化简历,却几乎没有收到任何回复。
技术背景:LLM后训练工具链的三层架构
这里提到的三项技术构成了当前LLM后训练的核心工具链,分别对应三个不同维度的问题。
SFT(Supervised Fine-Tuning,监督微调) 是后训练的基础层,用人工标注的"提示-回答"对直接优化模型输出分布,使预训练模型从"续写文本"转变为"遵循指令"。InstructGPT、Alpaca等早期指令微调工作均以SFT为核心。值得注意的是,SFT的训练数据质量对模型最终行为的影响远大于数据数量——即便是数千条精心标注的样本,也可能比数十万条低质量数据带来更好的指令遵循效果,这一现象被称为"少即是多"(Less is More)效应,并在Stanford Alpaca和Open Hermes等项目中得到了实证验证。
GRPO(Group Relative Policy Optimization) 是DeepSeek广告团队在2024年提出的策略梯度算法,属于RLHF(基于人类反馈的强化学习)范式的改进变体。其核心创新在于以"组内相对奖励"替代独立的价值网络(Critic)估计优势函数,从而消除对一个单独参考模型的依赖,显著降低了对齐训练的显存占用和计算成本。理解GRPO需要先了解其前身PPO(Proximal Policy Optimization)的局限:PPO在RLHF场景下需要同时维护策略模型、参考模型、奖励模型和价值模型四个神经网络,对于70B以上规模的大模型,这意味着数倍于单次推理的显存开销。GRPO通过对同一提示采样多个响应、以组内平均奖励为基线来计算相对优势,将四模型范式简化为两模型(策略模型+奖励模型),使百亿参数级别的RLHF训练在有限计算资源下成为可能。在DeepSeek-R1等推理增强型模型的训练中,GRPO被证明在数学推理和代码生成任务上具有突出的样本效率。
LoRA(Low-Rank Adaptation) 则解决的是参数高效微调问题。其理论假设是:预训练大模型在特定任务上的参数更新矩阵具有低内在秩(intrinsic rank)。基于此,LoRA将原本需要全量更新的参数矩阵ΔW分解为两个低秩矩阵B·A的乘积,将可训练参数量压缩至原始模型的0.1%至1%,使在单张消费级GPU上微调70B参数量级模型成为可能。这一假设并非凭空而来——其理论支撑来自Aghajanyan等人2020年提出的内在维度(Intrinsic Dimensionality)研究,该研究表明预训练语言模型在下游任务微调时的参数空间本质上是低维的。QLoRA进一步结合4-bit量化,进一步降低了显存门槛。而DoRA、LoRA+等后续变体则通过分解幅度与方向分量、差异化学习率等方式,持续推动参数高效微调的性能上限。
能同时掌握这三层工具链——从数据对齐(SFT)、策略优化(GRPO)到参数高效微调(LoRA)——并具备CUDA底层算子优化能力,在当前市场上确实属于稀缺的复合型能力组合。
他的问题直击痛点:"LinkedIn上的这些岗位是不是骗局?" 更深层的疑问是:想要通过FAANG的初筛,是否必须拥有顶尖PhD学历或NeurIPS、ICML这类一线会议的论文?
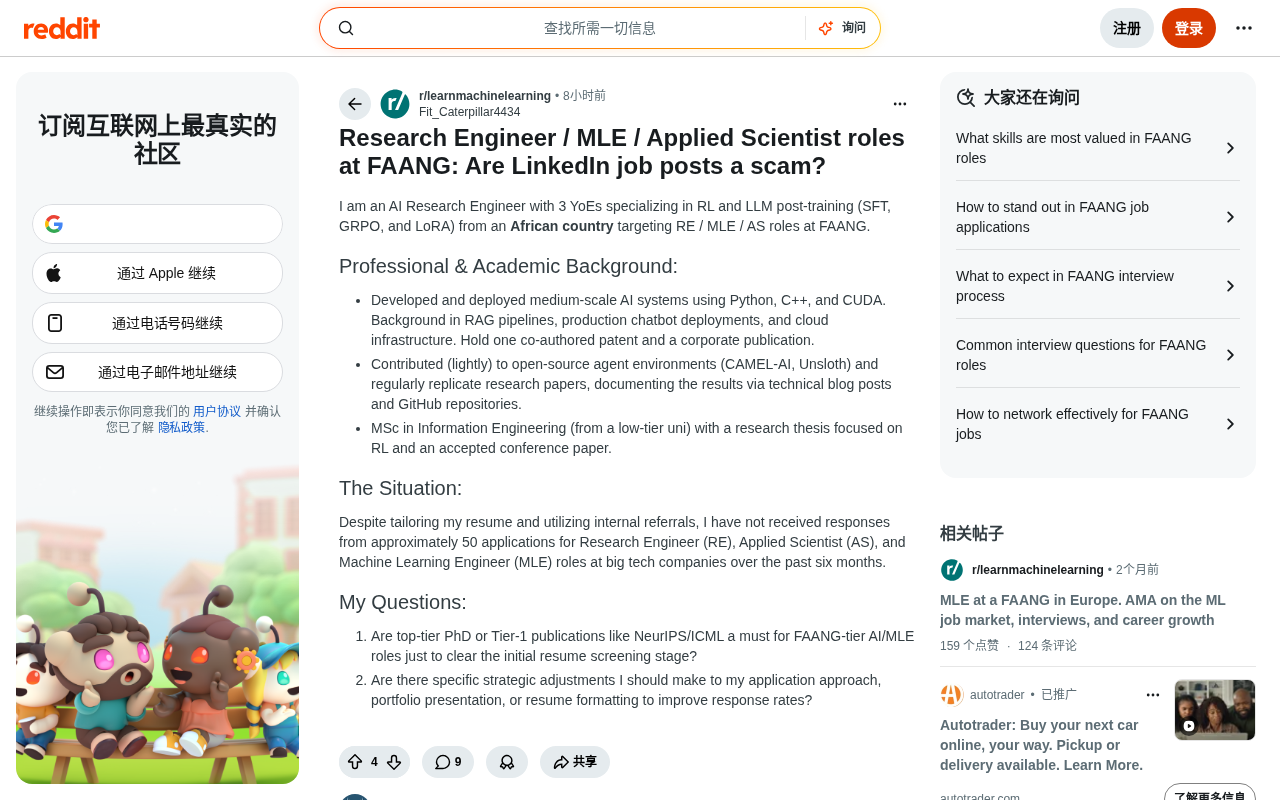
这个案例值得深入剖析,因为它折射出当前AI人才市场一个残酷的结构性现实。
这位候选人的背景其实不弱
先客观评估一下发帖者的履历。从技术栈来看,他的实力并不差:
- 使用Python、C++和CUDA开发并部署过中等规模的AI系统
- 有RAG管线、生产环境聊天机器人部署和云基础设施经验
- 持有一项联合专利和一篇企业出版物
- 轻度参与过开源项目(CAMEL-AI、Unsloth)
- 定期复现研究论文,并通过技术博客和GitHub记录成果
- 拥有信息工程硕士学位,研究方向为RL,并有一篇被录用的会议论文
这份背景放在很多公司都是合格甚至优秀的候选人。掌握GRPO、LoRA等前沿后训练技术,还能动手写CUDA做底层优化,在市场上并不常见。那么,问题究竟出在哪里?
FAANG研究岗的隐性门槛
学历与顶会论文:是不是硬门槛?
对于FAANG的Research Engineer和Applied Scientist岗位,答案往往是残酷的:顶尖PhD和一线会议论文(NeurIPS、ICML、ICLR、CVPR等)在实际操作中几乎是隐性硬门槛。
这并非因为这些论文本身有多神奇,而是招聘方需要一个低成本的筛选信号。当热门岗位收到成千上万份申请时,招聘系统(ATS)和初筛人员需要快速过滤。
ATS系统:被低估的第一道关卡
ATS(Applicant Tracking System,申请人追踪系统)是现代大型企业招聘流程的核心基础设施,也是绝大多数求职者从未直接接触过、却最先对其作出判断的系统。
在技术实现层面,主流ATS(如Workday、Greenhouse、Lever)通过关键词语义匹配、学历权重评分、工作年限验证等维度对简历进行自动化评级,并依据得分阈值决定是否进入人工审核队列。FAANG热门研究岗位往往在发布后24至48小时内收到数千份申请,部分岗位的ATS自动过滤率高达75%以上,意味着超过四分之三的申请者在任何人类审核员看到其简历之前就已被静默淘汰。
顶会论文和名校学位之所以成为隐性门槛,部分原因正在于这些标签被系统性地编码进了ATS的关键词权重——"NeurIPS"、"ICML"、"Stanford"、"MIT"等字符串在部分系统中具有显著的正向加权效应,而"非英语机构名称"、"非主流会议缩写"则往往无法被正确识别,导致候选人在算法层面就已处于不利位置。这一机制对来自欠发达地区的优秀候选人产生了与其技术能力完全无关的系统性惩罚。
值得注意的是,近年来部分企业已开始引入基于大语言模型的简历评估工具(如Paradox的Olivia、HireVue的AI评估系统)来替代或补充传统ATS的关键词匹配逻辑。这类系统在理论上能够理解语义相似性而非依赖精确字符串匹配,但其训练数据的历史偏差同样可能固化甚至放大既有的地域和机构偏见——这是当前AI辅助招聘领域正在被学界和监管机构持续审视的核心争议之一。
顶会论文的信号逻辑与其内在局限
为何顶会论文在AI研究岗招聘中具有如此核心的信号地位?要理解这一点,需要先了解顶级AI会议的录用机制。NeurIPS、ICML、ICLR、CVPR等会议的论文录用率通常在15%至25%之间,审稿流程由数百位领域内资深研究员(Area Chair和Reviewer)以双盲方式主导,审稿周期通常长达2至3个月,且每年竞争强度持续提升——NeurIPS 2023的投稿量已超过13,000篇。
对招聘方而言,顶会论文代表候选人具备一套完整的研究能力闭环:独立识别值得研究的问题、设计严谨的实验方案、完成大规模计算实验、撰写专业学术文档,并通过领域专家的匿名审查——这是一种比技能列表更难造假、更具预测效力的综合能力信号。
然而这套机制也存在不可忽视的系统性偏差。首先,它在结构上偏向拥有充裕GPU算力、资深导师指导和顶会学术网络的名校PhD群体;其次,非英语母语写作者在论文表达质量上面临额外门槛;更关键的是,来自顶会资源匮乏地区(如撒哈拉以南非洲、南亚部分地区)的研究者,即便具备同等技术能力,也因缺乏本地学术生态的支撑而难以进入这条发表路径。这使得顶会论文作为招聘信号,实际上在放大地域与机构层面的既有不平等,而非客观反映全球范围内的真实技术分布。
一个值得关注的反例是:部分在工业界产生深远影响的技术——如Meta的LLaMA系列、Google的Transformer原始论文、OpenAI的GPT系列技术报告——本身并非发表在传统顶会上(Transformer发表于NeurIPS,但LLaMA、GPT-3等均以技术报告形式发布),这在一定程度上说明顶会发表与工程影响力之间并不存在必然的单向对应关系。
顶会论文和名校博士学位就成了最直接的"质量代理指标"。发帖者所说的"普通高校硕士"加上一篇非顶会论文,很可能在这道自动化关卡就已被过滤。
"MLE"岗位可能是另一条出路
有意思的是,RE/AS和MLE三类岗位在本质上存在明显差异:
- Research Engineer / Applied Scientist:偏研究导向,看重发表记录和学术声誉
- Machine Learning Engineer:偏工程导向,看重系统设计、生产部署和规模化能力
发帖者同时投递这三类岗位,说明目标定位并不清晰。以他的CUDA、生产部署和云基础设施背景,MLE路线其实比纯研究岗更匹配,成功率也可能更高。用一份侧重研究的简历去投工程岗,或拿工程经历去竞争研究岗,都会稀释竞争力。
ML Infra:介于MLE与系统工程之间的新兴岗位类别
近年来,在MLE的基础上衍生出了一个增长迅猛的细分岗位类别——ML Infrastructure Engineer(ML基础设施工程师),有时也称为ML Platform Engineer或MLOps Engineer。这类岗位的技术要求与传统MLE存在明显差异:它更强调分布式训练系统设计、GPU集群调度(如Kubernetes + SLURM混合调度)、模型服务优化(TensorRT、vLLM、TGI等推理框架)、训练/推理管线的可观测性(Prometheus、Grafana、W&B集成)以及底层CUDA内核优化能力。
对于发帖者而言,其CUDA开发经历和生产部署背景恰好与ML Infra岗位的核心要求高度吻合。相比之下,ML Infra岗位对顶会论文的要求远低于Research Engineer,招聘决策更依赖于候选人能否展示真实可验证的系统优化成果——这正是开源项目贡献(如向vLLM或Unsloth提交CUDA优化PR)所能提供的。在当前大模型训练和推理成本居高不下的背景下,ML Infra人才的供需缺口实际上比纯研究岗更为突出。
LinkedIn职位是"骗局"吗?
发帖者的这个疑问,其实指向一个行业公开的秘密。LinkedIn上大量岗位确实存在几种"非真实招聘"的情况:
- Ghost jobs(幽灵职位):公司发布岗位以维持扩张形象或建立人才库,实际并无立即招聘计划。
- 合规性发布:某些岗位内部已内定人选,但出于流程或签证合规要求必须对外公开。
- 长期挂网:岗位已招满但未及时下架。
Ghost Jobs:一个由多重制度动机催生的行业现象
幽灵职位并非近年才有的现象,但在2022至2024年间的科技行业裁员潮与招聘收缩周期中尤为突出。据Greenhouse和Resume Builder等机构面向HR从业者的调查,超过40%的企业承认曾发布并不打算立即填补的职位,科技行业的这一比例更高于平均水平。
背后驱动幽灵职位存在的动机是多元且相互叠加的:市场预期管理——持续发布招聘信号向投资者和媒体传递增长叙事,避免股价因"停止招聘"消息而承压;人才库建设——收集简历以备未来招聘所需,同时观察市场上的候选人质量;H-1B签证合规——美国劳工部要求雇主在申请PERM劳工认证(绿卡流程的前置步骤)时必须证明本地招聘的"善意努力",这在制度上要求公开发布并维持一段时间的招聘广告,即便内部候选人实际上已基本确定;系统惰性——大企业的招聘管理系统缺乏自动下架机制,岗位填补后常因流程延误而继续对外展示数周乃至数月。
这一现象使求职者的投递转化率数据严重失真。候选人往往无法区分自己是因技术实力不足被筛掉,还是在竞争一个从未真实存在的机会——而这两种情况需要完全不同的应对策略。"50份申请0回复"在统计上因此并不必然意味着候选人能力不足,其中相当比例的投递可能自始至终就没有对应的真实职位。
一个识别幽灵职位的实用信号是岗位的发布时长:LinkedIn数据显示,真实有效的招聘岗位中位填补周期约为30至45天;持续挂网超过60天且无任何更新的岗位,成为幽灵职位的概率显著高于平均水平。此外,岗位描述与公司公开的业务收缩信号(如近期裁员公告、季度财报中的招聘冻结声明)之间的矛盾,也是值得关注的甄别维度。
所以,与其说是"骗局",不如说这是招聘生态中普遍存在的信息不对称。50份申请0回复,很大概率不是因为你实力不足,而是你可能在跟大量虚位或内定岗位竞争,同时又卡在了自动化初筛的信号门槛上。
更现实的策略调整
1. 重新定位目标岗位
不要同时广撒网投递RE/AS/MLE。以现有工程实力,优先攻MLE和ML Infra岗位,命中率会显著提升。研究岗可作为长期目标,但短期投产比相当低。
2. 放大已有的差异化信号
开源贡献是这位候选人最容易被低估的资产。目前他只是"轻度参与"CAMEL-AI和Unsloth——但如果能成为这些热门项目的核心贡献者,让GitHub上的PR和Star数成为可验证的实力背书,其价值可能超过一篇中等会议论文。
开源贡献的可验证信号价值
理解开源贡献为何在工程导向岗位上具有独特信号价值,需要先了解其所在生态的影响力量级。
Unsloth 是专注于LLM高效微调的开源项目,其核心创新在于通过手写CUDA内核和Flash Attention优化,在不损失数值精度的前提下将Llama、Mistral等主流模型的微调速度提升2至5倍,显存占用降低约60%。该项目在Hugging Face生态中具有相当影响力,GitHub Star数已超过两万,被大量AI从业者和研究者在实际工程中采用。能够向Unsloth贡献通过审查的CUDA级优化PR,本身就是对候选人底层系统能力的一次公开验证。Unsloth的技术栈涉及Triton内核编写、Flash Attention 2集成、RoPE位置编码的低精度计算优化等深度系统级工作,这类贡献的技术复杂度远高于一般的Python层代码提交,具有较高的辨识度。
CAMEL-AI 则是多智能体框架领域的重要开源项目,其角色扮演(Role-Playing)通信框架为LLM智能体的自主协作提供了早期的系统性抽象,影响了后续多个主流Agent框架的设计思路。在大模型Agent工程化需求快速增长的当下,CAMEL-AI的核心贡献者身份能够建立候选人在多智能体系统这一新兴子领域的专业标签。
核心贡献者身份(而非边缘参与)能带来的可量化公开记录包括:合并PR的数量与复杂度、issue解决的质量、代码审查参与度、社区影响力(GitHub Star数、fork数、下游引用量)。这些指标均可被招聘方通过公开渠道独立验证,具有简历声明无法比拟的可信度。部分FAANG工程师团队和AI初创公司的招聘负责人已明确表示,在筛选MLE和ML Infra候选人时,会将GitHub活跃度和知名开源项目的实质性贡献纳入初筛标准,其信号价值在工程导向岗位上甚至可以在一定程度上替代顶会论文。
Unsloth在LLM微调领域已有相当影响力,深度贡献能带来真实的行业能见度。
3. 从地域和签证现实出发
作为非洲国家的候选人,直接冲击FAANG美国总部会面临签证、时区、地域偏见等多重摩擦。
H-1B签证:一道与技术能力无关的结构性壁垒
美国H-1B工作签证是科技行业国际人才进入美国市场的主要合法通道,但其制度设计对国际候选人形成了显著的结构性障碍。
在数量层面,H-1B每年仅有85,000个名额上限(含20,000个硕士豁免配额),而近年申请量持续超过50万份,意味着即便雇主愿意担保,候选人仍需通过计算机随机抽签才能获得申请资格,整体中签率约为15%至20%。在成本层面,雇主需承担政府申请费(1,710至6,460美元不等,视公司规模而定)加上法律费用,合计通常在3,000至8,000美元之间,且审批周期长达6至12个月(加急处理可缩短至15个工作日,但需额外支付2,805美元)。
这一制度结构使FAANG在同等条件下显著偏好本地候选人或已有工作授权(如OPT/EAD持有者、绿卡持有者、美国公民)的申请者——招聘一名需要H-1B担保的国际候选人,意味着雇主需要承担数千美元的额外成本、数月的行政等待,以及抽签未中的不确定性风险。对于一个招聘季内有数百个岗位需要填补的大型企业,这一成本是可以消化的;但对于已经在技术评估上与本地候选人旗鼓相当的国际申请者,这些与技术能力完全无关的摩擦因素,会在招聘决策中产生真实的不利影响。
对于来自非洲的候选人,另一个值得考虑的路径是英国的Global Talent Visa(全球人才签证)和加拿大的Global Skills Strategy(全球技能战略)。前者专为国际顶尖技术人才设计,由Tech Nation负责AI/ML领域的资质评估,申请不依赖雇主担保且无数量上限;后者则为加拿大雇主提供了两周快速通道审批机制,显著降低了跨国招聘的行政摩擦。这两个市场汇集了大量FAANG分部(Google DeepMind伦敦、Amazon AWS多伦多等),且在签证友好度上均优于美国H-1B体系。
更务实的路径或许是:先加入有远程文化的AI初创公司,或有非洲、欧洲办公室的大厂分部,积累"大厂经历"这个信号,再寻求横向跳槽机会。
4. 内推要找对人
内推的效果高度依赖推荐人的层级和意愿。随口帮你提交的初级员工内推,效果可能还不如没有;而愿意直接帮你联系招聘经理的资深人士,价值则天差地别。
写在最后
这个案例的价值不在于个人际遇,而在于它揭示了AI求职市场的真实图景:技术能力和求职结果之间,存在一层由信号强度、地域限制、岗位定位和招聘生态共同构成的过滤网。
这层过滤网的构成要素——ATS自动筛选、顶会论文的信号逻辑、Ghost Jobs现象、H-1B签证壁垒——每一项单独来看都有其存在的合理性,但叠加作用之下,会系统性地将大量真实有能力的候选人拒之门外,而不论其实际技术水平如何。
对于同样在冲击顶级AI岗位的从业者,与其焦虑地追问"是不是骗局",不如冷静地问自己三个问题:我的求职信号是否足够强?我的岗位定位是否精准?我是否在跟真实存在的招聘需求竞争?想清楚这三点,或许比再盲目投递50份简历更有价值。
核心要点
核心要点
相关推荐

从工作流到评估驱动:AI时代解决任务的范式转变
AI解题范式正从设计确定性工作流转向「定义评估+爬山优化」。本文解析评估驱动如何重塑任务解决方式、数据供应商的新角色、人类从执行者到方向制定者的转变,以及Agent应用界面的演化趋势。

收据伪造检测模型接近随机?文档图像取证的实战困境与破局思路
一个收据伪造检测项目的 ROC-AUC 始终接近随机水平,本文剖析文档图像取证中的小样本困境,并给出从二分类转向异常检测、自监督预训练、数值一致性校验等可验证的破局方向。

特斯拉Powerwall+电动车:停电时的双重备用供电方案
特斯拉Powerwall家庭储能系统结合电动车双向充电,可在停电时提供多重备用供电。本文解析Powerwall续航能力、车辆作为备用电池以及超充补能的闭环方案与现实边界。