Fack’d:在YouTube视频播放时实时事实核查
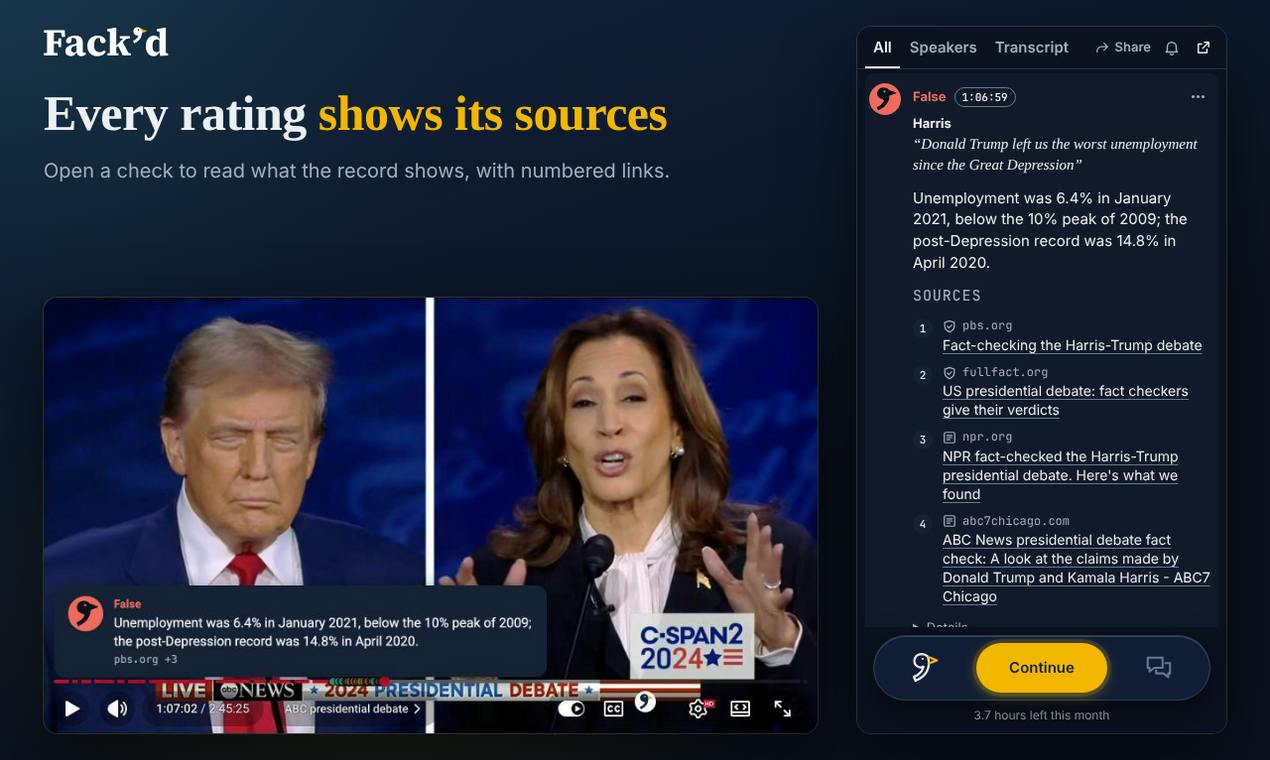
Fack’d 是一款在 YouTube 播放时实时核查演讲者言论并附时间戳、评级和来源的 Chrome 扩展。
Fack’d 是一款 Chrome 扩展,旨在解决 YouTube 访谈、辩论和新闻视频中未经证实说法难以即时核实的问题。它在视频播放时捕捉演讲者的关键言论,显示原话、时间戳、评级(如真实、误导、虚假)以及可读的来源链接,让用户边看边查而无需中断观看。产品采用免费观看已核查视频与登录后获得 10 次免费核查额度的混合模式,由开发者 Philip Loyd 打造,技术栈涉及 AI 和 Google Cloud Run,暗示其依赖云端弹性算力进行自动转录、声明提取和来源检索。在 Product Hunt 上获得 84 票和 8 条评论,排名第 13,显示早期关注但社区尚小。实时核查面临准确性依赖来源质量与 AI 理解力、处理速度需匹配播放节奏、非英语和专业领域覆盖有限等挑战,工具仅应作为辅助而非替代人工判断。
在信息爆炸的时代,YouTube上的访谈、辩论和新闻视频常常充斥着未经证实的说法。人工核查不仅耗时,而且往往滞后。一款名为Fack’d的Chrome扩展试图改变这一局面:它能在你观看视频的同时,对演讲者的言论进行实时事实核查,并附上时间戳、评级和可读的来源。
实时核查如何运作
Fack’d的设计思路很直接:在YouTube视频旁边打开扩展,随着视频播放,扩展会捕捉演讲者的关键言论,并显示对应的核查结果。每条核查结果都包含三个核心要素:演讲者的原话、一个时间戳(方便你定位到视频中的具体位置),以及一个评级(例如真实、误导、虚假等)。更重要的是,每条核查都附有可读的来源链接,让你可以自行验证。
这种“边看边查”的体验,尤其适合政治辩论、访谈节目或深度报道。你不再需要暂停视频、打开新标签页搜索,而是可以保持观看节奏,同时获得即时的背景信息。
事实核查中的评级体系通常并非简单的“真/假”二分,而是采用多级光谱,例如 PolitiFact 的 Truth-O-Meter 从“真实”到“ pants-on-fire ”共六档,FactCheck.org 则多用“准确/不准确/误导”等描述性标签。Fack’d 提到的“真实、误导、虚假”属于常见的三到五级简化框架。这类评级本质上是对陈述与证据之间匹配程度的判断,而非对陈述动机的评判。不同机构对“误导”的定义差异较大:有的指技术上正确但暗示了错误结论,有的则指关键上下文缺失。因此,跨平台比较评级时需注意其背后的评判标准是否一致。
免费与付费模式
Fack’d提供了两种使用方式。你可以免费观看那些已经被其他人核查过的视频——这意味着社区或系统已经对部分视频完成了核查工作,你可以直接受益。如果你想要对自己选择的视频进行核查,则需要登录账号,登录后可获得10次免费核查额度。这种模式既鼓励了共享,也为重度用户设置了合理的门槛。
从产品设计角度看,这种“免费观看已有核查+付费/配额发起新核查”的机制,有助于平衡服务器成本和用户增长。不过,具体定价和配额细节尚未在公开信息中明确。
技术背景与开发者
Fack’d由开发者Philip Loyd打造,产品分类涉及Chrome扩展、新闻、人工智能和Google Cloud Run。这表明其背后可能依赖云端AI能力来加速核查过程,例如自动转录、声明提取和来源检索。Google Cloud Run的使用也暗示了其架构具备弹性伸缩能力,能够应对突发流量。
在Product Hunt上,Fack’d获得了84票和8条评论,排名第13。这个成绩对于一款工具类产品来说不算突出,但也反映出一定程度的早期关注。评论数较少可能意味着产品仍处于早期阶段,用户社区尚未完全建立。
Google Cloud Run 是谷歌云提供的一种全托管无服务器容器运行环境。开发者将应用打包为容器镜像后,Cloud Run 会根据请求量自动伸缩实例——从零扩展到数百个并发实例,并按实际使用的 CPU 和内存计费。对于 Fack’d 这类核查工具而言,视频播放时可能突发大量核查请求(如热门辩论直播),Cloud Run 的弹性伸缩能力可以避免因流量尖峰导致服务不可用,同时在没有请求时将实例缩容到零以控制成本。这种架构选择暗示 Fack’d 的后端核查逻辑(如语音转文字、声明提取、来源检索)很可能以容器化微服务形式部署,而非运行在固定服务器上。
潜在挑战与局限
实时事实核查并非易事。首先,核查的准确性高度依赖来源的质量和AI模型的理解能力。如果来源本身有偏见或过时,核查结果也可能失真。其次,实时性要求处理速度足够快,否则核查结果可能滞后于视频播放,影响体验。此外,对于非英语内容或专业领域(如科学、法律),核查难度会显著增加。
Fack’d目前似乎主要面向英语内容,且核查范围可能受限于已经建立的事实核查数据库或可信来源列表。用户需要意识到,任何自动核查工具都只是辅助,不能完全替代人工判断。
自动事实核查的技术流水线通常包含三个关键环节:语音识别(将视频音频转为文本)、声明检测与提取(从连续话语中识别出可核查的事实性断言,过滤掉观点、反问和修辞)、以及证据检索与验证(在可信来源库中查找支持或反驳该断言的证据)。每个环节都有误差累积风险:语音识别对口音、背景噪音和专业术语的准确率下降会直接导致后续核查对象错误;声明检测若将观点误判为事实,会产生无意义的核查;证据检索则受限于来源库的覆盖范围和更新频率。实时场景下,这三个环节还必须在数秒内完成,对模型推理速度和检索效率提出了远高于离线核查的要求。
总结
Fack’d尝试将事实核查嵌入观看体验,减少信息验证的摩擦。它的实时性、来源透明度和免费观看模式是其亮点,但准确性、覆盖范围和可持续性仍需时间检验。对于经常观看访谈、辩论类内容的观众来说,这款工具值得一试。随着AI能力的提升和来源网络的扩展,实时核查有望成为视频消费的标配功能。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
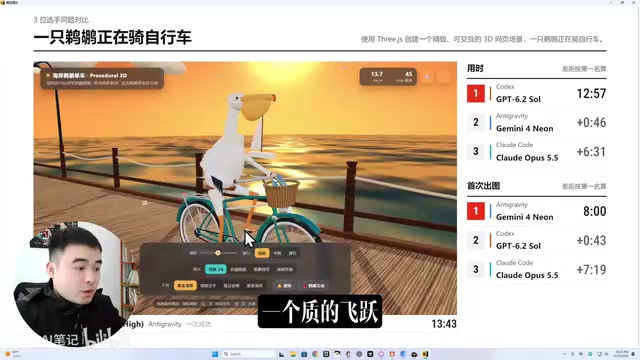
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
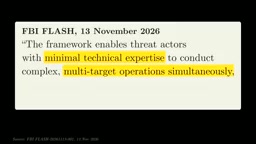
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。