FailTrace:用URL本地复现GitHub Actions失败

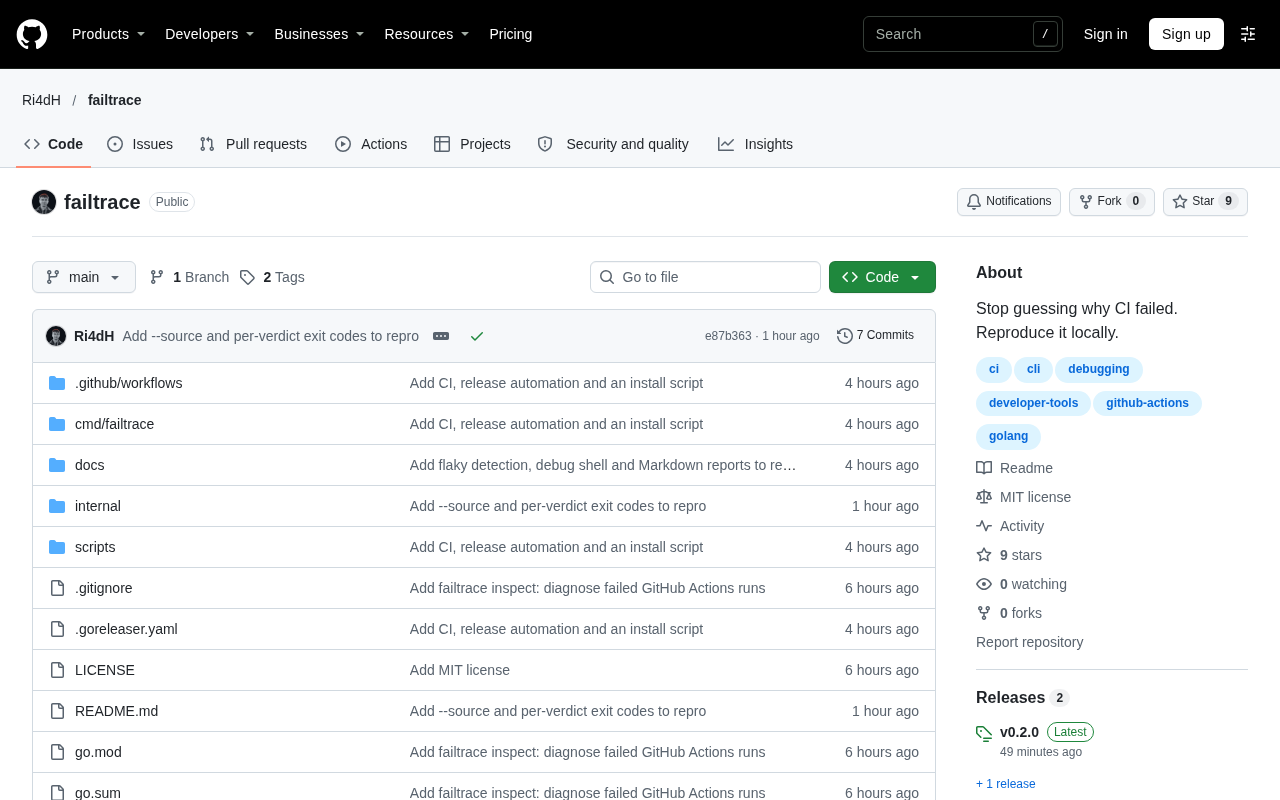
FailTrace 以失败的 GitHub Actions 运行 URL 为输入,在本地重建环境复现 CI 失败。
FailTrace 是一款针对 GitHub Actions 调试痛点的工具,开发者只需提供一次失败运行的 URL,它便能自动拉取该次运行的元数据,在本地构建接近的容器环境以复现失败,从而避免手动配置环境和反复推送空提交的低效操作。文章分析了其核心价值:以失败现场为起点,降低复现门槛,与 act 等正向执行工作流的工具形成差异化。同时指出其面临的技术挑战,包括环境还原粒度(secrets、矩阵构建、runner 镜像版本)、私有仓库鉴权与安全模型、以及跟随 GitHub runner 更新带来的维护成本。作者认为该工具代表了从运行记录反向还原调试上下文的新思路,其实用性取决于还原精度与易用性的平衡,值得关注但采用前需在非敏感仓库中验证。
引言:当CI失败,调试不该这么难
每个开发者都经历过这样的场景:GitHub Actions 流水线突然变红,日志里只有一行模糊的错误,想本地复现却需要手动配置环境、安装依赖、模拟 secrets……整个过程耗时且极易出错。FailTrace 试图解决这个痛点——只需提供一次失败的 GitHub Actions 运行 URL,它就能在本地复现相同的执行环境,让你像调试本地代码一样调试 CI 失败。
该项目在 Hacker News 上获得关注,虽然讨论热度不高(4 分、暂无评论),但其定位精准切中了持续集成调试中的真实摩擦点。本文基于项目描述和原始讨论,分析 FailTrace 的价值、潜在局限以及它代表的 CI 调试新思路。
核心功能:从 URL 到本地复现
它解决了什么问题
GitHub Actions 的运行环境是托管且短暂的。失败发生后,日志可能不完整,或者错误只在特定 runner 镜像、特定环境变量组合下出现。开发者通常的应对方式是:在本地 Docker 中手动重建环境、猜测缺失的依赖,或者反复推送空提交来触发流水线——效率极低。
FailTrace 的思路是以运行 URL 为输入,自动拉取该次运行的元数据(包括工作流定义、环境配置、依赖锁文件等),在本地构建一个尽可能接近的容器环境,从而复现失败。这相当于把一次性的云端执行变成了可反复调试的本地会话。
GitHub Actions 的 runner 镜像是 GitHub 托管执行环境的底层基础,分为 GitHub 托管的官方镜像(如 ubuntu-latest、windows-latest、macos-latest)和自托管 runner。官方镜像预装了操作系统、常用语言运行时(Node.js、Python、Java 等)、构建工具(Docker、Git、npm 等)以及大量系统库,并会定期滚动更新。由于镜像版本随日期变化,同一条工作流在不同时间运行可能因预装软件版本不同而出现“时好时坏”的失败,这也是 CI 调试中难以在本地复现的常见原因之一。FailTrace 若要准确复现,就需要锁定或近似对应时间点的 runner 镜像版本,而不是简单使用最新镜像。
使用流程与预期体验
根据项目描述,使用流程大致为:复制失败运行的 URL → 执行 FailTrace 命令 → 工具解析运行信息并启动本地环境。它瞄准的是那些依赖 GitHub 托管环境特性的失败场景,比如特定 runner 版本导致的兼容性问题、环境变量缺失、缓存未命中等。
目前项目公开信息有限,没有透露具体的环境还原粒度(是完整 runner 镜像还是部分配置)以及是否支持私有仓库的鉴权。这些细节将直接影响它的实用性。
技术实现的想象空间与挑战
从技术角度看,复现 GitHub Actions 运行并非易事。一次运行涉及多层信息:工作流 YAML、action 的版本解析、secrets 与变量、runner 操作系统与预装软件、甚至网络环境和缓存状态。FailTrace 需要决定还原到哪一层。
一种合理的设计是基于容器快照 + 依赖清单重建:利用公开的 runner 镜像作为基础,叠加工作流中声明的步骤和锁文件,在本地启动容器执行。这样能覆盖大部分依赖相关和环境相关的失败,但对 secrets 和网络依赖无能为力——这些恰恰是 CI 失败的高发区。
另一个挑战是私有仓库的权限。要读取运行信息,FailTrace 需要 GitHub Token 或 OAuth 授权,这意味着用户需要信任该工具对仓库元数据的访问。项目需要清晰的安全模型说明才能获得更广泛的采用。
矩阵构建(matrix strategy) 是 GitHub Actions 中用于并行测试多组配置的机制,通过在 job 中定义 strategy.matrix(如不同操作系统、语言版本、依赖版本组合),GitHub 会为每个组合生成一个独立的 job 实例并行执行。一次失败运行可能只对应矩阵中的某一个组合,而其他组合成功。FailTrace 若要复现,需要从运行元数据中识别出具体失败的矩阵坐标(如 os: ubuntu-latest, node: 18),并只重建该组合的环境,否则会浪费资源或引入无关变量。矩阵构建的支持程度直接决定了工具在多环境项目中的可用性。
同类思路与生态位
CI 调试工具并非全新领域。act 是一个知名项目,允许在本地运行 GitHub Actions 工作流,但它需要手动提供事件文件,且不直接以一次失败运行为输入。FailTrace 的差异化在于以失败运行 URL 为起点,降低了复现的操作门槛——用户不需要理解工作流触发条件,只需指向出问题的运行。
这种“从运行记录反向还原环境”的模式,与近年来可观测性工具的思路一致:先有失败的现场数据,再重建上下文。如果 FailTrace 能在环境还原的准确性和易用性上取得平衡,它有望成为 CI 调试工作流中的常用环节。
act 是一个由 nektos 社区维护的开源命令行工具,它通过解析仓库中的 .github/workflows/*.yml 文件,借助 Docker 在本地运行 GitHub Actions 的工作流步骤。使用 act 时,开发者需要自行指定触发事件(如 act push 或提供 event JSON 文件),并手动准备 .env、secrets 等环境变量,工具会拉取近似 runner 的镜像(如 catthehacker/ubuntu:act-latest)来执行 job。它的优势是离线可用、支持自定义镜像映射,但缺点是需要用户理解工作流触发逻辑,且默认镜像与 GitHub 官方 runner 存在软件版本差异。与 FailTrace 相比,act 是“从工作流定义正向执行”,而 FailTrace 是“从失败运行记录反向还原”,两者在输入和还原粒度上形成互补。
局限与待验证的问题
由于项目公开信息有限,几个关键问题尚待验证:
- 还原精度:能否处理依赖 secrets 的步骤?对矩阵构建(matrix)的支持程度如何?
- 私有仓库支持:鉴权方式与数据访问范围是否透明?
- 维护成本:GitHub 的 runner 镜像持续更新,工具需要跟进适配,否则复现环境会与云端产生偏差。
这些问题决定了 FailTrace 是成为日常工具还是概念验证。对开发者而言,在采用前建议先在非敏感仓库中试用,评估其还原效果。
结语
FailTrace 代表了一种务实的 CI 调试方向:不追求完美的环境模拟,而是以失败现场为线索,尽可能缩短“发现问题”到“本地可调试”之间的距离。在 GitHub Actions 成为主流 CI 平台的当下,这类工具的价值会随着流水线复杂度上升而放大。值得保持关注。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。