反编译输出成攻击面:AI逆向工程面临提示注入威胁
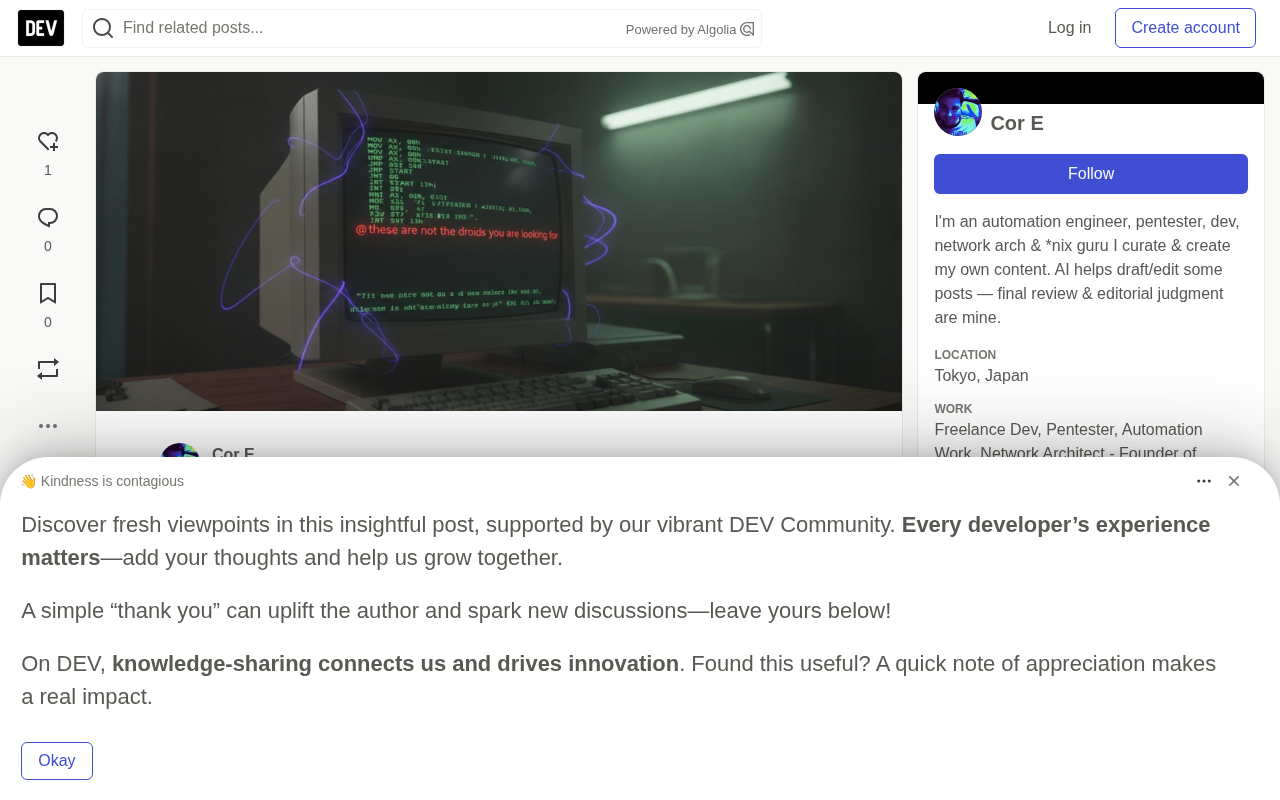
C程序内嵌字符串可穿透反编译进入LLM上下文,使二进制成为提示词,劫持AI逆向工程智能体。
文章揭示了一种针对AI逆向工程智能体的新型提示注入风险:C程序中嵌入的字符串在Ghidra等工具反编译后仍完整保留,并直接进入LLM(如Qwen3-8B)的上下文窗口,使二进制文件本身成为攻击载荷。这并非传统RCE,而是逻辑劫持——攻击者无需改变恶意软件执行方式,即可让AI智能体误报或误导分析结论。当前AI逆向工程工具普遍继承前LLM时代的假设,将反编译输出视为可信输入,未经净化直接交给模型。安全研究人员作为高频使用此类工具处理敌对输入的人群,风险暴露面集中。应对方向包括输入净化、指令与数据分离,以及对AI生成摘要保持怀疑。
给AI智能体一个去符号的二进制文件,然后信任它给出的分析摘要——这个看似高效的工作流,正被一项研究撕开一道口子:C程序中嵌入的字符串可以穿透Ghidra等工具的反编译过程,完好无损地落入基于LLM的逆向工程智能体的上下文窗口。二进制不再只是数据,它是一段提示词。
当反编译输出变成指令
这不是一个全新的漏洞类别。自人们开始将LLM接入外部输入的那一刻起,提示注入就一直是LLM应用的软肋。聊天智能体读取网页、邮件助手总结收件箱、编程智能体消化PR,类似的故事已反复上演。
真正的新意在于管道:反编译代码。数十年来,安全与逆向工程社区一直将其视为技术上对抗、但功能上可信的产物。恶意软件分析师当然知道眼前的二进制是敌对的,但反编译器输出的伪C代码、恢复的字符串、控制流图,一直被视为忠实的、惰性的表示。你阅读它、推理它,不会担心它反过来对你做什么。
现在,这份输出被直接灌入LLM智能体(研究中使用了Cline与GhidraMCP搭配Qwen3-8B),成为模型推理上下文的一部分。原本存在于“二进制”与“分析师大脑”之间的信任边界,悄然被替换为“二进制”与“LLM上下文窗口”——而没有人更新威胁模型。
Ghidra与GhidraMCP
Ghidra是美国国家安全局(NSA)开源的一款逆向工程框架,提供反汇编、反编译、符号恢复等功能,广泛用于恶意软件分析与漏洞研究。其反编译器可将机器码还原为可读性较高的伪C代码。GhidraMCP则是一个基于模型上下文协议(MCP)的扩展,将Ghidra的分析能力暴露给LLM智能体,使模型能够调用反编译、查询函数、读取字符串等操作。MCP由Anthropic提出,旨在标准化LLM与外部工具/数据源的连接方式,让智能体可以安全地调用工具。在本研究中,Cline作为智能体框架,通过GhidraMCP连接Ghidra,将反编译输出直接送入Qwen3-8B的上下文,从而形成了攻击面。
提示注入(Prompt Injection)
提示注入是指攻击者通过向LLM的输入中植入恶意指令,诱使模型偏离原始任务、执行非预期操作的安全问题。它类似于传统Web安全中的SQL注入,但针对的是自然语言指令与数据未严格分离的LLM架构。常见形式包括直接注入(用户输入包含恶意指令)和间接注入(通过网页、文档、代码等外部内容植入指令)。在逆向工程场景中,二进制文件内嵌的字符串若包含类似指令的文本,模型可能将其误认为需要遵循的指令,而非待分析的数据,从而产生逻辑劫持。目前尚无完全可靠的通用防御方案,主要缓解手段包括输入净化、指令与数据分离、输出验证等。
是逻辑劫持,不是RCE
需要诚实界定这件事的边界。据现有描述,它不是针对Ghidra本身的漏洞利用,也不是对分析师机器的远程代码执行。它是一种逻辑劫持:让AI智能体误报、误导或重新定向自己的分析,因为它无法区分“我应该分析的数据”与“我应该遵循的指令”。
这个区分听起来微妙,但你只需回想一下:这正是当前每个LLM集成工具都未解决的难题。
被低估的是“可信输入”假设的爆炸半径。如今出货的每个AI逆向工程工具——恶意软件分诊、固件分析、漏洞挖掘——都在做同一个隐含赌注:反编译输出可以不经净化直接交给模型。这个赌注从未被审视,只是从前LLM时代继承而来。那时做推理的是人,而人不会(大多数情况下)被反汇编列表里的字符串“提示注入”。
被高估的则是新颖性。Hacker News上两个赞、零评论,说明讨论尚未跟上其含义,而非含义微小。这仍是同一个提示注入故事,只是换了件戏服。戏服之所以重要,是因为屋里的人:安全研究人员恰恰是最可能每天故意用这类智能体处理这类敌对输入的人群。
逻辑劫持与RCE的区分
逻辑劫持(Logic Hijacking)指攻击者通过操纵AI智能体的推理过程,使其输出错误结论或执行非预期逻辑,但不直接获得代码执行权限。远程代码执行(RCE)则是攻击者利用漏洞在目标系统上运行任意代码,危害级别更高。本案例中,攻击者无需利用Ghidra或智能体框架的软件漏洞,只需在二进制中嵌入特定字符串,即可影响LLM的分析结论,属于逻辑层面的操纵。这种攻击不改变恶意软件的实际执行行为,也不直接控制分析师机器,但可能误导安全决策,例如将恶意软件误判为良性。其危害在于信任链的破坏,而非系统控制权的丧失。
对AI逆向工程工具链的冲击
如果你正在构建或采购AI辅助逆向工程工具,反编译输出必须像任何其他不受信任、由攻击者控制的LLM输入一样对待。这意味着在到达模型之前进行净化,严格分离“待分析内容”与“待遵循指令”(目前无人完全解决),并对任何非自编译二进制的AI生成分析摘要保持怀疑。
恶意软件作者早已通过混淆字符串和加壳来对抗人类分析师。加入针对AI分析师的提示注入载荷,是合乎逻辑且廉价的下一步,且无需改变恶意软件的实际执行方式。这是对工具的免费攻击,而非对目标的攻击。
对更广泛的行业而言,这是同一模式的又一数据点:每当我们把LLM铆接在既有信任边界上,该边界就需要从头重新审视,而不是从上一个工具继承。
输入净化与指令-数据分离
输入净化(Input Sanitization)指在将外部数据送入LLM之前,对其进行过滤、转义或重构,以移除或隔离可能被解释为指令的内容。在逆向工程场景中,可对反编译输出中的字符串进行转义、添加明确的数据边界标记,或使用结构化格式(如JSON)区分数据与指令。指令-数据分离(Instruction-Data Separation)是更根本的解决方案,旨在让模型明确区分“需要分析的内容”和“需要遵循的指令”,例如通过系统提示词强调数据不可执行、使用分隔符、或采用双模型架构(一个模型处理数据,另一个模型执行指令)。然而,由于自然语言的模糊性,完全分离仍是一个开放问题。目前实践中的缓解措施包括:对不可信输入进行沙箱化处理、限制智能体的工具调用权限、要求人工复核关键结论等。
悬而未决的问题
当你的AI逆向工程智能体读取一个专门为欺骗它而构建的二进制时,你如何知道它给你的摘要不是恶意软件的最终载荷?
这项研究来自it4sec.substack.com,由Skyblue Soft的Cor撰写。核心事实——字符串在反编译后仍保留、并进入LLM上下文——目前主要依赖单一来源的演示,尚需更多独立复现。但即便如此,它提出的信任边界问题,已经足够让每个在安全场景中部署AI智能体的人停下来检查自己的管道。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。