反Vibe Coding浪潮:历史上站错队的一派?

Reddit热帖引发争议:抵制vibe coding是邪教还是理性担忧?
一位Reddit用户将抵制vibe coding的群体称为“邪教”,并断言他们“将站在历史的错误一边”。帖子以C++物理模拟引擎的实测经验为据,证明前沿AI模型能在性能关键路径上生成优化代码,但强调“人在回路”的必要性。作者还将反AI情绪归因于外国机器人,但这一指控缺乏可验证证据,真实反对声音来自职业焦虑、创意同质化担忧和伦理质疑。帖子警告完全拒绝AI工具可能削弱竞争力,但“只会vibe coding”同样危险。最后呼吁对新手宽容,并指出AI正在将“写代码”拆解为不同层次的活动,二元对立的站队思维无助于理解真实的技术分工变化。
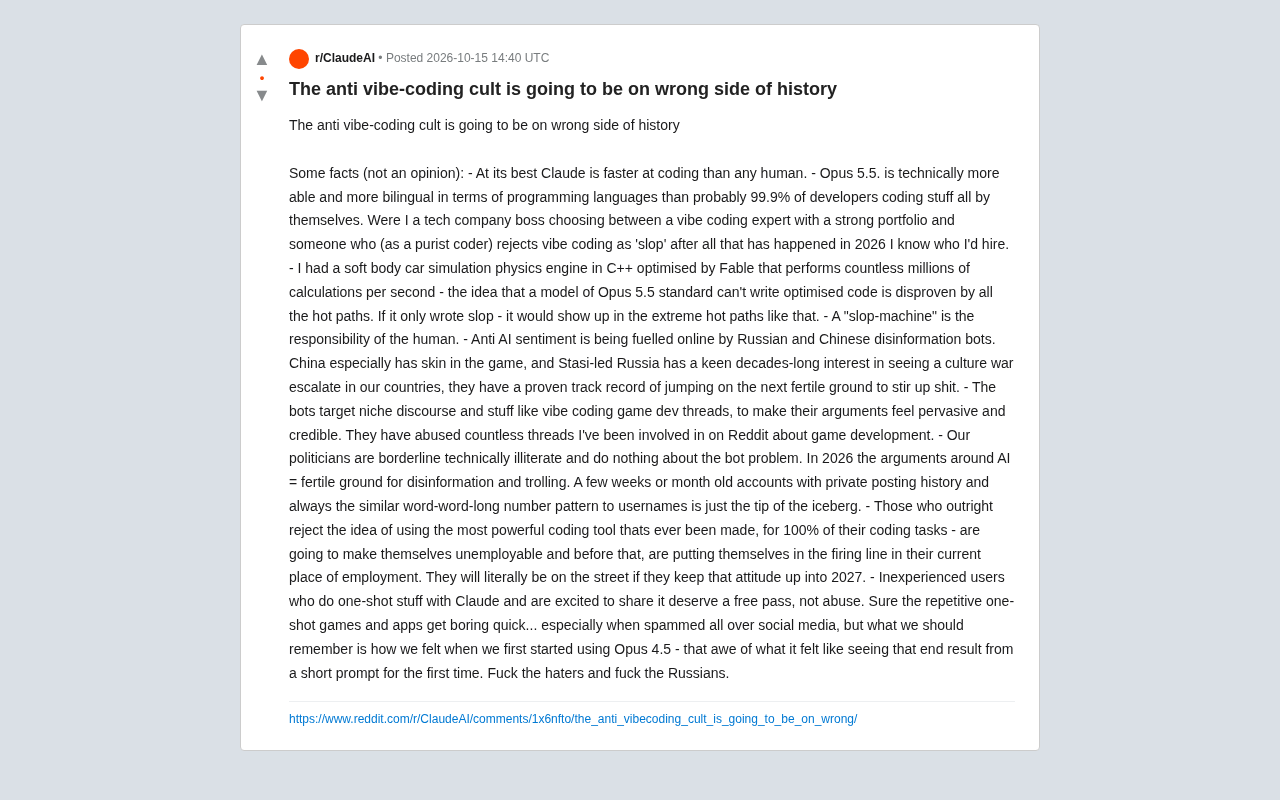
一位Reddit用户在r/gamedev相关讨论区发帖,以近乎宣战的口吻将抵制“vibe coding”的群体称为“邪教”,并断言他们“将站在历史的错误一边”。帖子中混杂着强烈的个人体验、对AI编码工具性能的辩护、对地缘政治操弄的指控,以及对“纯手工编码原教旨主义”的警告。抛开情绪化的措辞,这篇帖子实际上提出了几个值得拆解的技术与社会议题。
Vibe Coding工具的真实能力边界
帖子最核心的论据,是作者对AI编码工具在极限性能场景下的实测经验。他提到自己用C++编写了一个柔体汽车物理模拟引擎,其中由AI辅助优化的代码“每秒执行数百万次计算”,并以此反驳“模型只能写垃圾代码”的观点。
“一个Opus 5.5级别的模型无法写出优化代码——这种说法被所有热点路径的表现直接推翻。如果它只写垃圾,这些东西会在极端热点路径上暴露出来。”
客观来看,前沿模型在算法密集型任务中生成经过合理优化的C++、Rust或CUDA代码,已经不算罕见。关键在于“人在回路”:有经验的开发者提供性能约束、审查内存访问模式、验证数值稳定性,模型则快速生成候选实现并迭代。帖子中强调的“99.9%的开发者独自编码时的编程语言广度不如模型”,在跨语言迁移和API记忆层面基本成立,但这与“替代系统性软件工程能力”是两回事。模型能写出跑得很快的热点函数,不等于能独立负责一个百万行代码库的长期演进。
“人在回路”(human-in-the-loop)是AI辅助编程中一个被反复提及却常被误解的概念。它的核心含义是:模型负责生成候选代码,人类负责设定约束、检查输出、修正偏差。这一模式之所以关键,是因为当前大语言模型在代码生成上的失败往往不是“语法错误”,而是“语义微差”——比如边界条件处理不当、浮点精度累积误差、并发场景下的竞态条件。这类问题在单元测试中未必暴露,却可能在极端负载下引发崩溃。因此,有经验的开发者会为模型提供明确的性能预算(如“每秒千万次浮点运算”)、内存访问约束(如“避免随机访存”)、以及数值稳定性要求(如“使用Kahan求和”)。模型在这些约束下快速生成多个候选实现,人类再通过基准测试和代码审查筛选最优解。这种分工既发挥了模型的生成速度,又保留了人类对系统行为的最终判断权。
“反AI情绪是外国机器人挑动的”?
帖子最具争议的部分,是直接将互联网上的反AI风潮归因于“俄罗斯和中国的虚假信息机器人”,并称机器人专门瞄准“vibe coding游戏开发”这类小众话题,让反对声音显得更普遍、更可信。
这种指控需要分开看。一方面,社交媒体平台上确实存在大量低质量、模式化账户,用户名呈现“单词-单词-长数字”特征,注册时间短,发帖历史私密。无论其背后是商业水军、政治操弄还是单纯的网络喷子,这类账户在热门争议话题中放大对立情绪是平台治理的已知难题。另一方面,将特定技术社区的批评声音整体归因于外国势力,缺乏可验证的证据,且容易滑向阴谋论叙事。更合理的观察是:反AI情绪同时来自真实的职业焦虑、对创意同质化的担忧、对训练数据伦理的质疑,以及纯粹的美学偏好。把所有反对者打包成“机器人”或“邪教”,本身也是一种话语暴力。
“虚假信息机器人”(bot)与“网络水军”(troll farm)是社交媒体治理中的两个相关但不同的概念。机器人通常指自动化账户,通过程序批量发布内容、放大特定话题;水军则更强调有组织的人力操纵,往往带有商业或政治目的。两者都可能表现为用户名随机、注册时间集中、发帖模式重复等特征。然而,识别它们并不容易:平台上的普通用户也可能使用类似命名习惯,或因隐私设置而显得“可疑”。更重要的是,即便确认了机器人活动,也不等于证明其背后有国家支持。学术研究通常要求追踪资金流、IP基础设施或内部文件才能做出归因。因此,将某一技术社区的反对声音整体归因于外国势力,在方法论上是不严谨的。更常见的现实是:商业水军放大争议以获取流量,政治操弄者借机搅浑水,而真实用户的不满情绪被这些噪音裹挟,最终形成难以溯源的混合舆论场。
拒绝AI编码工具=职业自杀?
帖子中一个更实际的警告是:那些“100%拒绝使用史上最强编码工具”的开发者,正在让自己变得不可雇佣,甚至可能在现有岗位上被边缘化。
这个判断有其现实基础。在游戏开发、Web后端、数据管道等大量商业场景中,能够熟练编排AI代理、审查生成代码、快速迭代原型的工程师,单位时间产出确实显著高于完全手工编码的同行。企业招聘时,portfolio中展示“用AI辅助完成复杂系统”的候选人,往往比只展示纯手写代码的候选人更具吸引力。但这并不意味着“不会vibe coding就找不到工作”。系统设计能力、调试能力、性能调优经验、领域知识,仍然是区分高级工程师和提示词操作员的关键。真正危险的是“只会vibe coding”:一旦模型卡住或生成微妙错误的代码,缺乏底层理解的人将无从下手。
对新手宽容一点
帖子末尾有一段值得肯定的呼吁:对刚接触AI编码、兴奋地分享“一次性生成的小游戏”的新手,不应报以嘲讽。
“我们该记住自己第一次用Opus 4.5时的感受——第一次用简短提示看到完整结果时的那种敬畏。”
重复的、粗糙的“一键生成”作品确实会让人审美疲劳,尤其当它们被大量刷屏时。但每一个新工具普及初期,都会经历“大量低质量产出→社区筛选→最佳实践沉淀”的过程。对新手作品进行人身攻击,无助于提升讨论质量,反而会把有潜力学习的人推向防御性立场。更有建设性的做法是:指出具体可以改进的地方,或者分享如何从“一次性生成”进阶到“多轮迭代+人工审查”的工作流。
“一次性生成”(one-shot generation)与“多轮迭代+人工审查”(iterative refinement with human review)代表了AI编码工作流的两个阶段。前者指用户输入一段提示词,模型直接输出完整可运行的程序,常见于小游戏、简单工具等场景。这种方式门槛极低,能快速带来成就感,但也容易掩盖代码中的设计缺陷、安全漏洞和可维护性问题。后者则要求开发者将复杂任务拆解为多个子步骤:先让模型生成接口定义或伪代码,再逐步填充实现,每一步都进行测试和审查。这种工作流更接近传统软件工程中的敏捷开发,只是将部分编码任务委托给了模型。从“一次性生成”进阶到“多轮迭代”,需要开发者主动学习如何写更精确的提示词、如何设计测试用例、如何阅读和修改AI生成的代码。社区对新手作品的宽容,本质上是在保护这个学习曲线的起点,而不是纵容低质量产出。
不是站队,而是细化分工
这场争论的标题党色彩很浓,但它触及了一个真实的分岔:AI编码工具正在把“写代码”这件事拆解成不同层次的活动——快速原型、胶水代码、热点优化、系统架构、安全审查。不同层次对AI依赖的程度天然不同。把“用不用AI”简化成二元对立,既低估了工具的复杂性,也高估了单一方法论的普适性。真正会被历史淘汰的,或许不是某一派开发者,而是拒绝细化思考、只会用标签互相攻击的讨论方式。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。