FastEmbed教程:轻量级本地向量嵌入库安装与实战指南

FastEmbed:轻量快速的本地化Python向量嵌入库介绍与实践
FastEmbed是Qdrant团队开发的轻量级Python嵌入库,基于ONNX Runtime推理引擎,无需依赖PyTorch等重量级框架,支持文本和图像的向量嵌入生成。它API简洁、开箱即用,具备良好的语义理解能力,并与Qdrant向量数据库无缝集成,适合快速原型开发、无GPU环境部署及本地RAG应用构建,但支持的模型范围有限。
在AI应用开发中,文本和图像的向量嵌入(Embedding)是一项基础且关键的能力。然而,许多嵌入方案依赖PyTorch、TensorFlow等重量级框架,对硬件要求较高。FastEmbed作为一个专注于轻量、快速、本地化的Python嵌入库,为没有GPU的开发环境提供了一个极具吸引力的选择。本文将详细介绍FastEmbed的核心特性、使用方法以及与Qdrant向量数据库的集成实践。
FastEmbed是什么?为什么值得关注
FastEmbed是由Qdrant团队开发的Python库,专门用于在本地环境中快速生成文本和图像的向量嵌入。它的核心设计理念可以概括为三个关键词:轻量、快速、本地化。
与通用的嵌入框架不同,FastEmbed采用ONNX Runtime(Open Neural Network Exchange)作为推理引擎。ONNX可以理解为神经网络领域的"PDF格式"——一种通用的模型交换标准。这意味着FastEmbed不需要依赖PyTorch或TensorFlow这样的大型深度学习框架,极大地减少了安装包的体积和系统资源占用。
当然,FastEmbed也有其局限性。它只支持特定的模型列表,并非所有Hugging Face上的模型都能直接使用。在MTEB(Massive Text Embedding Benchmark)排行榜上排名最高的一些模型(如Google的KALM/Gemma系列)并不在其支持范围内。但对于原型开发和轻量级应用场景,FastEmbed提供的模型已经足够优秀。
安装与环境配置
安装FastEmbed非常简单,只需一行pip命令:
pip install fastembed
如果需要GPU加速支持,可以安装GPU版本:
pip install fastembed-gpu
对于使用UV(基于Rust的Python包管理器)的开发者,也可以通过uv add fastembed来添加依赖。整个安装过程无需额外配置CUDA或其他深度学习框架的环境,真正做到开箱即用。
文本嵌入:从基础用法到语义理解验证
基础用法
FastEmbed的API设计极其简洁。生成文本嵌入只需要三步:创建模型实例、调用embed方法、处理结果。
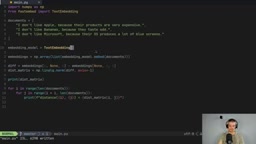
import numpy as np
from fastembed import TextEmbedding

documents = [
    "I don't like Apple because their products are overpriced",
    "I don't like bananas because they taste odd",
    "I don't like Microsoft because their OS produces a lot of blue screens"
]

embedding_model = TextEmbedding()
embeddings = np.array(list(embedding_model.embed(documents)))

有意思的是,embed()方法返回的是一个生成器(Generator),需要通过list()来触发实际的计算。这种设计在处理大量文档时可以有效控制内存使用。
语义理解能力验证
上面的例子精心设计了一个有趣的测试场景:三个句子中,"Apple"和"bananas"从词汇层面看更相似(都是水果名称),但从语义层面看,"Apple"和"Microsoft"才是真正相关的(都是科技公司)。
通过计算向量间的欧氏距离,结果表明:
- Apple vs Microsoft:距离0.78(最近)——模型正确识别了两者都是科技公司
- Apple vs Bananas:距离0.877
- Bananas vs Microsoft:距离最远
这说明FastEmbed默认使用的嵌入模型已经具备了不错的语义理解能力,能够超越简单的词汇匹配,理解上下文中的真实含义。
选择不同的嵌入模型
FastEmbed支持多种预训练模型,可以通过以下方式查看完整的支持列表:
from fastembed import TextEmbedding, ImageEmbedding

# 查看支持的文本嵌入模型
print([x["model"] for x in TextEmbedding.list_supported_models()])

# 查看支持的图像嵌入模型
print([x["model"] for x in ImageEmbedding.list_supported_models()])
要使用特定模型,只需在创建实例时指定模型名称即可:
embedding_model = TextEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")
图像嵌入:统一API实现多模态嵌入
FastEmbed不仅支持文本嵌入,还支持图像嵌入。使用方式与文本嵌入几乎完全一致:
from fastembed import ImageEmbedding

embedding_model = ImageEmbedding(model_name="Qdrant/resnet50-onnx")
embedding_list = list(embedding_model.embed(["image1.jpeg", "image2.jpeg"]))
只需将文本列表替换为图像路径列表,即可获得图像的向量表示。这种一致的API设计大大降低了多模态AI应用的开发门槛。
与Qdrant向量数据库的无缝集成
FastEmbed与Qdrant向量数据库有着天然的集成关系——它们出自同一团队。当使用Qdrant的add方法向集合中添加文档时,如果没有手动提供嵌入向量,Qdrant会自动调用FastEmbed在后台完成嵌入计算。
from qdrant_client import QdrantClient

client = QdrantClient(":memory:")
client.set_model("sentence-transformers/all-MiniLM-L6-v2")

# 添加文档时自动使用FastEmbed生成嵌入
client.add(collection_name="my_collection", documents=documents)

set_model方法指定了FastEmbed使用的嵌入模型,之后所有添加到集合中的文档都会自动通过该模型生成嵌入向量。这种设计让开发者可以专注于业务逻辑,而不必手动管理嵌入生成的流程。对于构建RAG(检索增强生成)应用来说,这种集成方式尤其方便。
GPU加速配置
虽然FastEmbed主打CPU推理,但它也支持通过NVIDIA GPU进行加速。安装fastembed-gpu包后,可以通过providers参数启用CUDA加速:
from fastembed import TextEmbedding

embedding_model = TextEmbedding(
    model_name="sentence-transformers/all-MiniLM-L6-v2",
    providers=["CUDAExecutionProvider"]
)
需要注意的是,GPU加速目前仅支持NVIDIA显卡(需要安装CUDA驱动),AMD显卡暂不支持。
FastEmbed适用场景与局限性分析
FastEmbed的定位非常清晰:它不追求在MTEB排行榜上登顶,而是为开发者提供一个开箱即用、轻量高效的本地嵌入解决方案。
最适合的场景包括:
- 快速原型开发和概念验证
- 没有GPU的轻量级部署环境(笔记本电脑、边缘设备)
- 与Qdrant配合构建本地RAG应用
- 对依赖管理有严格要求的项目(避免引入PyTorch等大型框架)
不太适合的场景:
- 需要最先进嵌入模型的生产环境
- 需要使用特定Hugging Face模型的项目
- 对嵌入质量有极高要求的专业检索系统
总的来说,FastEmbed在"够用"和"易用"之间找到了一个很好的平衡点。对于大多数本地AI应用开发场景,它都是一个值得优先考虑的轻量级向量嵌入方案。
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。