FDE必看:AI大模型项目30大评测指标全解析

B站UP主拆解FDE需关注的30大AI产品评测指标,覆盖五层能力与三层核心矛盾。
文章系统梳理了FDE(前线部署工程师)在AI产品落地中应关注的30个量化指标,并将其组织为模型质量、用户体验、系统效率、业务价值、数据闭环五层能力。作者开篇指出AI产品的三层核心矛盾:准确度决定入场资格,成本控制决定能否持续,壁垒决定能否避免被大厂快速复制。随后逐层展开:模型质量层以解决率为最终目标,给出幻觉率、空答率、意图识别准确率、RAG召回率等具体阈值及其trade-off关系;用户体验层关注首轮满意度、转人工率等端到端指标;系统效率层聚焦Token成本、延迟、QPS与供应商依赖;业务价值层讨论重复使用率、单位解决成本、LTV/CAC与ROI;数据闭环层强调反馈回流、bad case归因、自建评测集与模型漂移。全文反复提醒阈值仅为经验参考,真正价值在于建立"指标—归因—优化"的分析习惯。
AI产品好不好,不能靠感觉,得拿数字说话。一位B站UP主系统拆解了FDE(Forward Deployed Engineer,前线部署工程师)需要关注的30大评测指标,覆盖从模型智力到商业变现的完整链条。这套框架把AI产品的能力拆成五层:模型质量、用户体验、系统效率、业务价值、数据闭环,每一层都有对应的量化抓手。
三层核心矛盾:准确度、成本与壁垒
UP主把AI产品的关键归结为三个点。第一是准确度,也就是产品的"智力水平",这决定你有没有入场券。第二是成本之战,AI产品天然是"反SaaS"的,做一单赔一单的模式撑不下去,成本必须控制住。第三是生存之战,即产品壁垒在哪里——腾讯、阿里能不能快速复制你?如果这个问题解决不了,产品很容易昙花一现。UP主直言,现在很多AI产品都没有壁垒,这是最不好解决、也最需要行业共同讨论的问题。
从这三层矛盾出发,指标体系被拆成五层能力:模型质量层、用户体验层、系统效率层、业务价值层、数据闭环层。最终目标是"足够聪明、快且便宜、能自我进化"。UP主用DeepSeek广告对各类产品做过简单评分,但强调仅作参考。
FDE(Forward Deployed Engineer,前线部署工程师) 这一角色最早由 Palantir 在政府与国防项目中规模化使用,指被派驻到客户现场、直接对接业务需求并负责把通用平台改造为可用系统的工程师。与传统的售前或实施顾问不同,FDE 既要懂客户业务、又要能写代码、还要能定义成功指标,本质上是产品、工程与交付三者的结合体。在生成式 AI 落地中,FDE 的职责被进一步放大:基础模型是通用的,而客户数据、业务流程和合规要求高度异质,必须有人在现场把指标拆解、把 harness 调通、把 bad case 归因清楚。这也是为什么本文强调 FDE 需要一套贯穿模型质量到商业变现的量化框架——没有共同指标,FDE 与客户、与总部研发之间就无法对齐。
模型质量层:智力水平怎么量
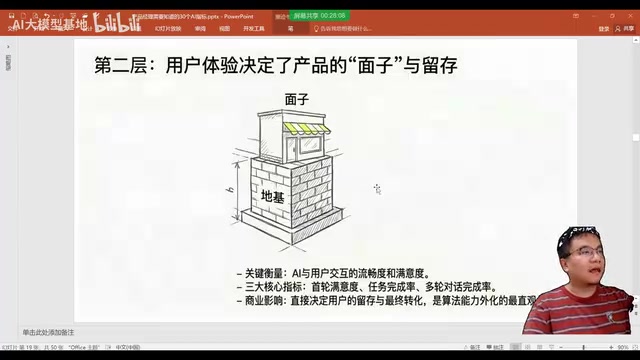
模型质量不只是基础模型的能力,还包括意图识别、RAG召回排序、幻觉控制等多种能力互相咬合的结果,最终以解决率的形式呈现。
解决率是最终目标:AI自己搞定了多少用户、不需要人工兜底。客服类产品能做到60%到80%已经不错;业务较难时30%到40%也算合理,这个数字直接关系到能给公司省多少钱。
幻觉率关乎信任。垂直行业如法务、医疗基本不能容忍出错,UP主的经验是幻觉率不应超过1%。完全做到0%不现实,因为模型是概率采样,但至少要保证大规模测试中不出让用户放心不下的错误。UP主还调侃:模型产生幻觉不可怕,可怕的是人产生幻觉。
空答率是幻觉的反面:系统说正确的废话、车轱辘话,过于保守。UP主建议空答率控制在10%以下。
意图识别准确率在Agent场景中常见,后面接了不同系统或工具时,能否调准相应工具是关键。要求通常在85%到95%左右——第一把没找准,后面都白做。
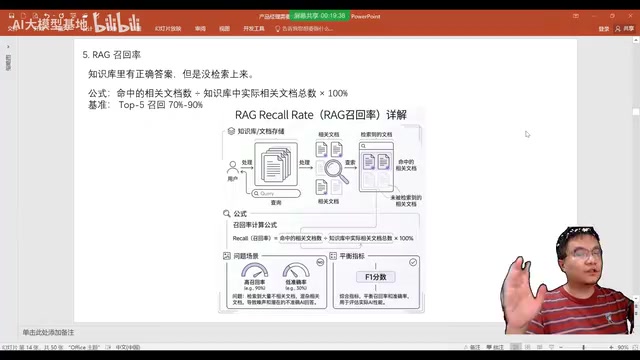
RAG召回率是知识库问答的核心。UP主强调,召回率一般要到90%以上(前5个召回结果里包含所需信息),召回上去了模型才不容易胡编乱造。
事实一致性则区分问题根源:如果知识库召回了正确知识、大模型却答错,说明基模不行,要考虑换模型;如果召回本身不行,往往跟基模关系不大,是召回排序策略需要优化。
Skill触发率与完成率是Agent场景的新指标。系统挂了多个Skill时,能否正确触发对应Skill(触发率),触发后基模能否按Skill描述的工作流正确执行(完成率)。UP主给出分析思路:Skill不被触发,先检查描述是否写好、多个Skill是否互相干扰,给每个Skill明确边界;正确触发但不正常干活,则可能是基模能力偏弱。
这些问答类指标之间存在trade-off。意图识别是闸门,错了后面全错;幻觉率和空答率此消彼长——压低幻觉往往采用保守策略,容易产出正确的废话。召回率和事实一致性是前后依赖关系。所以效果不好时不要盲目优化,先拿具体例子对照指标定位环节。
RAG(Retrieval-Augmented Generation,检索增强生成) 是目前知识库问答的主流架构:先把用户问题向量化,从文档库中召回 Top-K 相关片段,再把片段拼进提示词交给大模型生成答案。它把"记忆"外置到可更新的知识库,从而绕开模型参数固化带来的知识过时问题。关键环节有三个:切分与索引决定召回粒度,向量检索与重排序决定召回质量,提示词组织决定模型能否正确使用召回内容。本文所说的召回率、事实一致性、空答率,本质上分别对应这三个环节的失败模式——召回不到是检索问题,召回对了却答错是基模问题,不敢答则往往是提示词或阈值策略过于保守。
用户体验层:端到端好不好用
这一层从用户视角衡量产品,更多是产品经理优化的范畴。
首轮满意度:用户第一轮交互就能拿到想要的答案。优秀产品该指标通常要大于65%,类比搜索——用户希望答案在第一页,而不是翻好几页。
转人工率:常见于客服场景,用户用着用着全转人工甚至打电话投诉,说明AI效果比较差。这是端到端的用户角度衡量,与技术指标互补。
任务完成率:Agent系统里,用户让写代码、提工单、请假,最终能否落地成功。UP主认为大于40%就算不错的AI产品——基本让模型执行两三次就能达成目标。
客户满意度是传统打分,但要留意极端值:给满分是极端,给一星往往意味着用户已经面临流失。
系统效率层:能不能赚钱的关键
智力水平和体验决定这是不是一个好产品,系统效率决定它能不能长期上线、能不能赚钱。
Token消耗是成本大头。优化手段包括精简提示词、做KV Cache缓存、对不复杂的任务换更便宜的模型、用记忆或RAG做上下文管理。UP主特别强调:这一轮AI产品做不做得成是一方面,最终胜出的往往是能把成本压到极低的公司,成本有时比营收更重要。
首Token响应时间(RT):从输入到吐出第一个Token的等待,通常是毫秒级。降不下来时,宁可给用户一些可爱的提示语("正在思考""正在努力干活")缓解焦虑。
端到端延迟:整个答案输出需要多久,要求基模回答相对简洁。Agent场景下延迟几十秒很正常。
QPS衡量系统整体吞吐能力。UP主举例:一张GPU处理一路请求,5秒回答完,20张GPU并发20路,QPS就是20除以5等于4。但QPS高不代表单个用户等待短,两者不能混为一谈。AI产品的QPS相比传统互联网后端低得多——互联网产品QPS能上百,AI产品做Agent项目一个请求平均可能要100秒,QPS为1已经算快,这也是AI烧钱的原因之一。
Token使用效率:输入问题、提示词、检索文档、上下文对话、回答的Token总量与实际有效回答Token的比例。效率太低说明系统有大量优化空间——提示词能不能短一点、召回文档能不能少而准、对话历史能不能裁剪。UP主接触过不少公司只看效果不关注效率,内部用用尚可,真要市场化未必有竞争力。
系统可用性:只绑定单一模型供应商,外部故障会直接让业务中断。要降低对具体模型的依赖,这要求Agent能力和harness做得好。有些公司针对某个模型做大量优化,换模型后优化全白搭——harness不够行,产品就会过度依赖单一供应商。
KV Cache(键值缓存) 是大模型推理降本的核心手段之一。Transformer 在自回归生成时,每输出一个 Token 都要对之前所有 Token 重新计算注意力,计算量随上下文长度平方增长。KV Cache 把已计算的 Key 和 Value 张量缓存下来,后续 Token 直接复用,避免重复计算,可显著降低首 Token 之后的生成延迟与算力消耗。在多轮对话和长提示词场景中,若前缀保持不变,缓存命中率会很高;反之,提示词频繁变动会导致缓存失效。这也解释了为什么本文把"精简提示词"和"上下文管理"列为 Token 成本优化的重点——它们不仅减少输入 Token,还直接提升缓存复用率。
业务价值层:怎么让客户掏钱
UP主坦言,不同业务差异极大,AI本身是非标产品,"AI产品的差距比人和狗之间的差距还大"。模型选择和harness各占多少,取决于具体业务。
重复使用率:7天内来了1000人,其中600人用了两次以上,重复使用率就是60%。AI产品本身应该是高频产品,用户用一次就不用了,说明产品不够新。
单位解决成本:不能只算算力成本,还要算向量存储、人力、微调标注、监控等全部投入。一年200万成本服务1万用户,单个用户成本就是200块,产品至少要在一个用户身上赚超过200块才划算。标注数据和模型微调属于沉没成本,不随用户增长而增长,用户越多越能摊薄。
工单偏转率:客服场景常用。人工客服平均每单成本15块,每月通过AI搞定一万单就省15万。但要注意,有时不是用户不需要人工,而是入口太深找不到人工而劝退——腾讯的真人客服就是典型例子。
AI效率提升:要看端到端时间是否真正缩短。UP主举例公文写作系统,用了AI后写稿时间反而从五小时变成六七小时,因为要花大量时间审核。AI Coding也是典型:有新闻称代码量提升约130%但工作量提升300%,写出来的东西反复改反而更浪费时间。为用AI而用AI,会让AI成为负担。
LTV与CAC:AI产品必须把算力成本从LTV中扣除,这一点和互联网产品不同。用户生命周期付费500块、算力成本100块,实际只赚400;获客成本200块,比例只有2比1,很可能亏。UP主的经验是AI产品要做到5比1才可能赚钱——200块获客成本至少对应1000块利润。
ROI:分子是可量化收益(用户付费、节省人力、效率提升、收入增长),分母是人工、基础设施、机器采购等全部投入,ROI必须大于1,否则做一单亏一单。
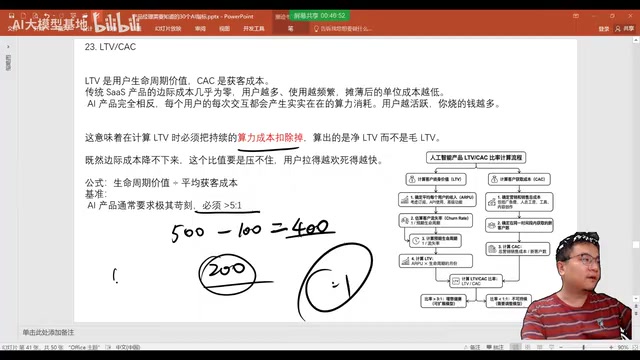
LTV(Life Time Value,用户生命周期价值)与 CAC(Customer Acquisition Cost,获客成本) 是 SaaS 行业沿用多年的单位经济模型指标:LTV 衡量一个用户从获取到流失期间贡献的毛利总和,CAC 衡量获取一个付费用户平均花掉的市场与销售费用。传统 SaaS 的常见健康线是 LTV/CAC 大于 3。本文强调 AI 产品必须从 LTV 中额外扣除算力成本,原因在于大模型推理的边际成本远高于传统软件——传统软件多服务一个用户几乎零成本,而 AI 产品每多一次调用就多一份 GPU 开销。因此同样的 3 比 1 在 AI 场景可能已经亏损,作者提出 5 比 1 的经验线,本质上是为算力这一新增变动成本留出安全垫。
数据闭环层:产品有没有前途
做FDE或接私活时,要跟甲方讲清楚:这次50万只是第一期,后面还有二期三期优化,这就要靠数据闭环层撑起想象空间。
反馈回流率:正反馈(点赞)和负反馈(吐槽)都要收集,用来优化系统。很多公司做AI产品没有数据回流,用户好坏运营方不知道,产品就无从优化。
Bad case归因:把bad case有效分析到前四层的哪一层——是不够聪明、交互不友好,还是响应太慢。不怕错,但要知道错在哪。
评测集覆盖率:UP主提醒,榜单指标存在过拟合问题,相当于泄题,很多模型刷榜第一但一用就废;也可能榜单覆盖不到你的特殊场景。所以要自建数据集和评测机,评测数据要贴近真实场景。榜单评测像标准化考试,高考上清华很牛,但让清华学生去开直播未必行。
模型漂移率是隐形杀手。知识会随时间变化——旅游问答的季节推荐、门票价格、周边餐饮都在变;用户问题也有季节性,三四月问买房、六七月问找工作、九月问入学。不更新,满意度会慢慢下降。云端服务还可能悄悄降级模型。UP主类比做自媒体:内容必须与时俱进。
执行校准率:让模型输出时附带置信度分级,可信度高就直接输出,模型自己都不满意就转人工。
数据飞轮:用户使用产生反馈,反馈被及时收集,问题被及时定位解决,再改善用户体验,这个循环必须转起来。不要挑战用户耐心,现在AI产品没有门槛,你能想到的点子别人也能想到,数据飞轮转得越快,优势越大。
写在最后
这套30大指标的价值不在于背数字,而在于建立"指标—归因—优化"的分析习惯。UP主反复强调,不同业务差异巨大,所有阈值都是经验参考。真正重要的是:出问题时能定位到是哪一层、哪个指标受影响,再针对性优化,而不是盲目调参。对FDE和AI产品技术负责人来说,这既是评估工具,也是和客户、老板对话的共同语言。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。