分位数分布式强化学习逼近极小极大速率:理论突破与统计精度分析

论文建立分位数分布式强化学习的非渐近误差界与局部极小极大风险,揭示分辨率对统计精度的影响。
本文研究分位数分布式策略评估问题,在 Wasserstein 距离下分析分位数贝尔曼不动点估计量的统计精度。作者建立了非渐近误差界:当奖励密度一致远离零时,估计误差以根 n 速率收敛,且与分辨率 m 和 Wasserstein 阶数 p 无关;当奖励密度在端点消失时,对于 p>2,速率受 m^{1/2-1/p} 系数影响。进一步,作者刻画了局部渐近极小极大风险,证明所提估计量达到最优,并揭示在端点消失实例中风险随 m 增长。这些结果阐明了分辨率与统计精度之间的基本权衡,为分位数强化学习算法设计提供了理论指导。
研究背景与问题设定
分布式强化学习(Distributional Reinforcement Learning, DRL)关注回报分布而非仅期望值,近年来在理论和方法上均取得显著进展。其中,分位数方法通过有限个分位点来近似回报分布,因其计算高效且易于实现而备受青睐。然而,这种近似带来的统计精度损失究竟如何?分位数分辨率 m 如何影响估计误差?这些问题尚未得到系统回答。
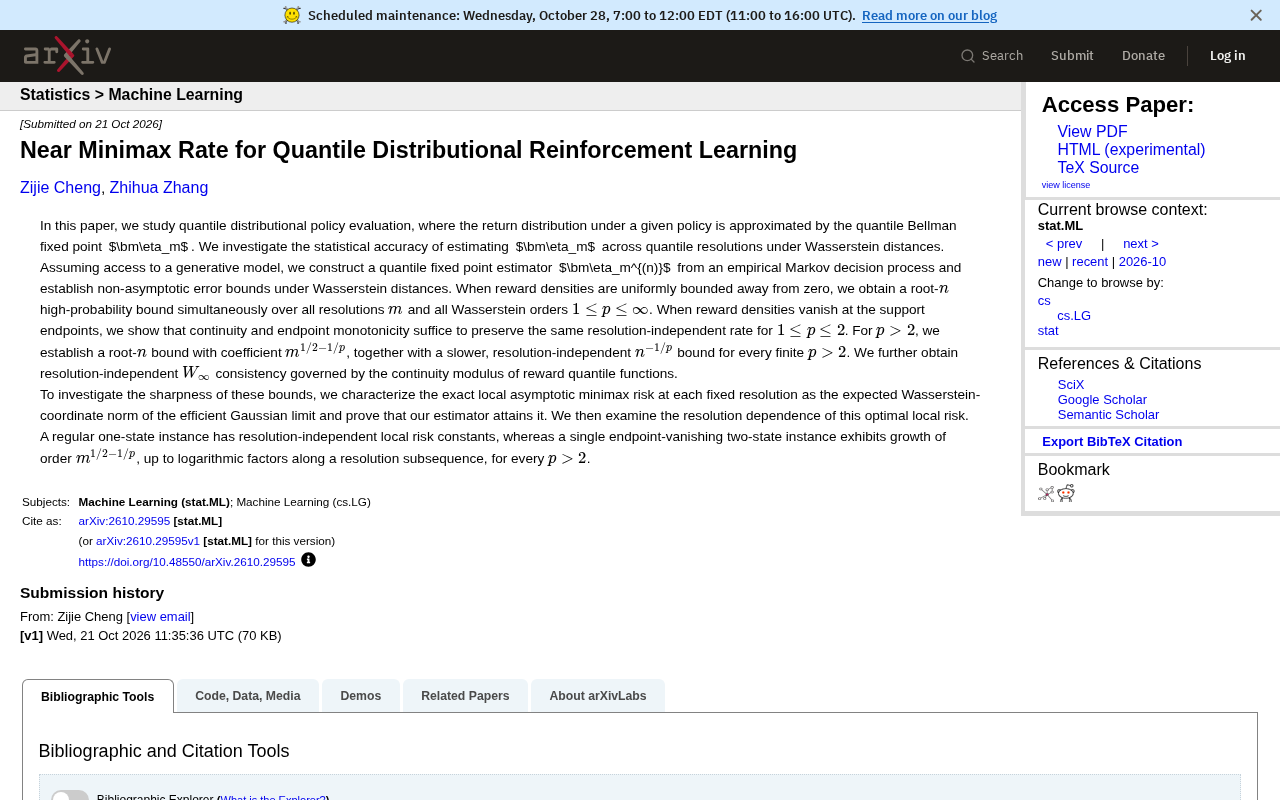
近期一篇论文《Near Minimax Rate for Quantile Distributional Reinforcement Learning》深入研究了分位数分布式策略评估问题。作者考虑在给定策略下,用分位数贝尔曼不动点 η_m 来近似回报分布,并在 Wasserstein 距离下考察估计 η_m 的统计精度。研究假设可以访问生成模型(generative model),从而能够从经验马尔可夫决策过程(MDP)中构建估计量 η_m^(n)。
分布式强化学习(DRL) 与传统的期望值强化学习不同,它学习回报的完整分布而非仅其期望。这一思想最早由 Bellemare 等人在 C51 算法中系统化,后续的 QR-DQN、IQN 等方法均属此列。DRL 的优势在于能捕捉回报的不确定性,为风险敏感决策提供依据。
分位数方法 是 DRL 的一种实现途径:用 m 个分位点(通常等概率间隔)来离散化回报分布。分位数贝尔曼不动点 η_m 即为该离散分布下的贝尔曼最优解。分辨率 m 越大,近似越精细,但计算成本也越高。
Wasserstein 距离 是衡量两个概率分布之间差异的度量,特别适合比较具有不同支撑或形状的分布。在 DRL 中,Wasserstein 距离常被用作分布贝尔曼算子的收缩度量。其阶数 p 控制了对尾部差异的惩罚程度:p 越大,对分布尾部的差异越敏感。
生成模型(generative model) 假设允许算法在任意状态-动作对处采样下一状态和奖励,这简化了理论分析,使研究者能聚焦于统计估计误差而非探索问题。
非渐近误差界与速率分析
论文的核心贡献之一是建立了分位数固定点估计量在 Wasserstein 距离下的非渐近误差界。当奖励密度一致远离零时,作者得到了一个同时适用于所有分辨率 m 和所有 Wasserstein 阶数 p(1 ≤ p ≤ ∞)的根 n 高概率界。这意味着,无论分位数分辨率如何选择,估计误差都以参数速率 n^{-1/2} 收敛。
当奖励密度在支撑端点处消失时,情况变得复杂。作者证明,对于 1 ≤ p ≤ 2,只要奖励分位函数满足连续性和端点单调性,仍可保持与分辨率无关的根 n 速率。然而,对于 p > 2,他们建立了一个系数为 m^{1/2-1/p} 的根 n 界,同时对于每个有限的 p > 2,也存在一个更慢但分辨率无关的 n^{-1/p} 界。此外,他们还得到了由奖励分位函数的连续性模控制的、分辨率无关的 W_∞ 一致性。
这些结果表明,分位数近似的统计精度对 Wasserstein 阶数和奖励分布特性敏感,尤其在高阶距离下,分辨率 m 的选择会显著影响收敛速率。
非渐近误差界 指的是对任意样本量 n 都成立的高概率误差上界,而非仅描述 n→∞ 时的极限行为。这类界通常以 n^{-1/2} 的速率衰减,并显式包含置信水平、状态空间大小等常数因子。
奖励密度在支撑端点处消失 是指奖励分布的概率密度函数在取值范围的边界处趋于零。例如,稀疏奖励场景中,奖励常集中在零附近,而正奖励的密度在零点处可能为零。这种端点行为会影响分位数估计的精度,因为靠近端点的分位点需要更多样本才能稳定估计。
参数速率 n^{-1/2} 是统计估计中的经典速率,对应于正则参数模型下的最优收敛速度。当估计量达到此速率时,称为“根 n 相合”。本文表明,在奖励密度远离零时,分位数估计量无论分辨率如何都能达到此速率。
局部渐近极小极大风险与锐性
为了探究这些界的锐性,作者刻画了每个固定分辨率下的精确局部渐近极小极大风险。他们证明,该风险等于有效高斯极限的 Wasserstein 坐标范数的期望,并进一步证明所提出的估计量达到了该风险。这奠定了估计量的渐近最优性。
随后,作者分析了最优局部风险对分辨率的依赖性。在一个正则的单状态实例中,局部风险常数与分辨率无关;而在一个端点消失的两状态实例中,对于每个 p > 2,局部风险以 m^{1/2-1/p} 的阶增长(沿分辨率子序列可达对数因子)。这一发现揭示了分位数方法在高阶 Wasserstein 距离下的内在局限性:增加分辨率 m 并不能无限降低风险,反而可能因端点效应导致风险增大。
局部渐近极小极大风险 是统计决策理论中的核心概念,用于刻画在参数空间中某一点附近,所有估计量中最坏情况下的渐近风险下界。若某估计量达到该下界,则称为渐近最优。本文通过这一框架证明了所提估计量在固定分辨率下的最优性。
有效高斯极限 指的是当样本量趋于无穷时,估计误差经过适当缩放后收敛到的高斯过程。其协方差结构由得分函数和 Fisher 信息决定。在本文中,该极限的 Wasserstein 坐标范数的期望即为局部极小极大风险。
端点消失的两状态实例 是作者构造的一个简化模型,用于揭示分辨率对风险的影响。该实例中,奖励分布仅在两个点有质量,且密度在端点处消失,从而使得高阶 Wasserstein 距离下的风险随分辨率 m 增长。这一反例说明,增加分辨率并非总能提升统计精度。
多源视角与领域意义
尽管本文是单一来源的理论研究,但其结论与分布式强化学习领域的其他工作相互印证。例如,Bellemare 等人提出的 C51 算法和 Dabney 等人的 QR-DQN 均基于分位数近似,而本文为这类方法提供了严格的统计精度保证。同时,论文关于端点消失情形的分析,与近期关于重尾分布下 DRL 鲁棒性的讨论形成呼应。
从实践角度看,该研究提示从业者在选择分位数分辨率时需权衡计算成本与统计精度,尤其是在奖励分布具有端点消失特性时(如稀疏奖励场景),过高的分辨率可能不会带来预期收益。此外,论文的极小极大分析为设计自适应分辨率策略提供了理论依据。
C51 算法 由 Bellemare 等人于 2017 年提出,是首个成功将分布式强化学习应用于 Atari 游戏的算法。它用 51 个固定支撑点来近似回报分布,并通过投影步骤更新分布。本文的理论分析为 C51 类方法的分辨率选择提供了统计依据。
QR-DQN 由 Dabney 等人于 2018 年提出,采用分位数回归来学习回报分布的分位点。与 C51 不同,QR-DQN 直接参数化分位点,避免了投影误差。本文的分位数固定点估计量可视为 QR-DQN 的理论对应物,其速率分析解释了 QR-DQN 在实践中表现良好的原因。
重尾分布下的 DRL 鲁棒性 是近期研究热点。重尾奖励分布会导致方差无穷,传统期望值方法失效。分位数方法因直接建模分布而具有一定鲁棒性,但本文指出,当密度在端点消失时,高阶 Wasserstein 距离下的风险仍会随分辨率增长,这为鲁棒性分析提供了新的视角。
总结与展望
本文通过严谨的非渐近分析和局部极小极大理论,揭示了分位数分布式强化学习中分辨率与统计精度之间的基本关系。所建立的速率被认为是接近极小极大的,为后续研究奠定了理论基础。未来工作可探索更一般的奖励分布假设、函数逼近下的分位数方法,以及将理论指导转化为实际算法设计。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。