风险敏感非参数与核Bandits:CPT遗憾无额外代价

NPCB将累积前景理论引入非参数与核Bandits,证明风险敏感不增加遗憾阶数。
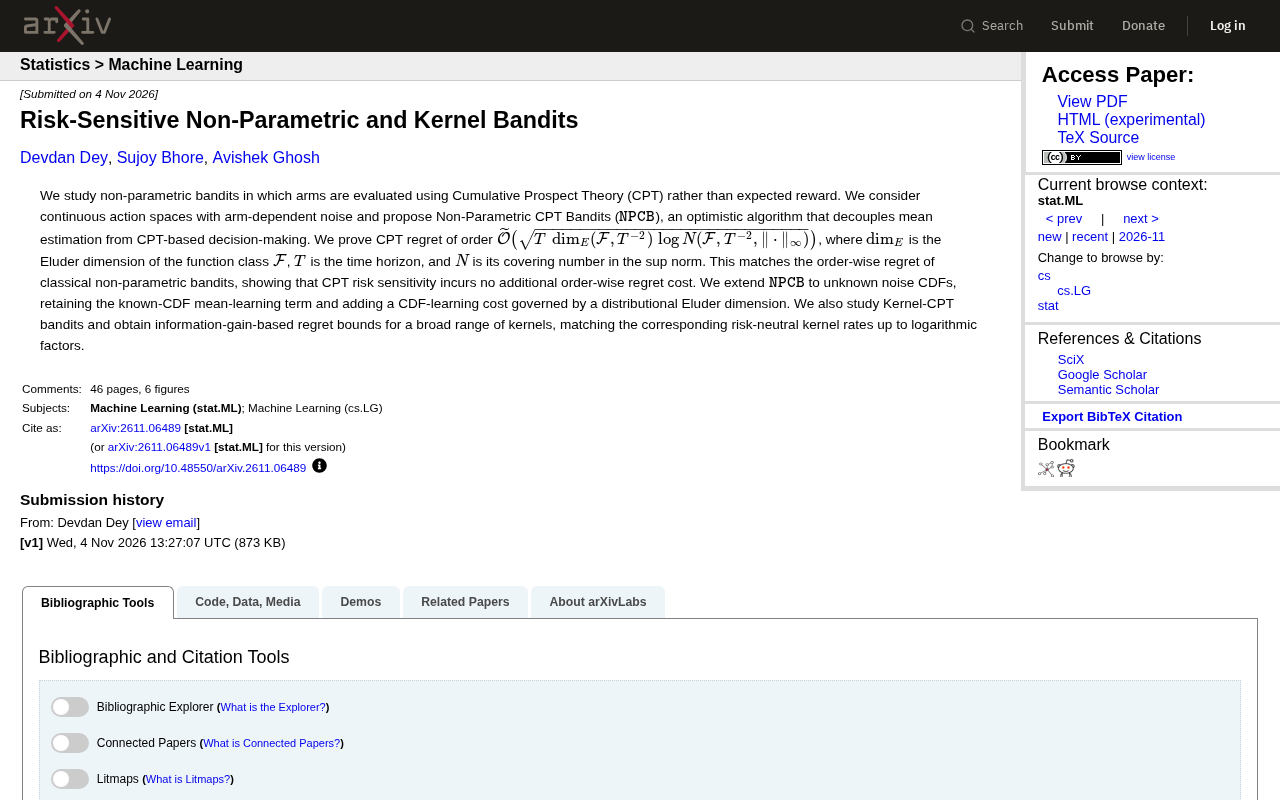
本文研究将累积前景理论(CPT)引入非参数Bandits与核Bandits框架,提出NPCB算法,在连续动作空间与臂相关噪声下最大化CPT效用而非期望奖励。算法采用解耦设计:均值估计沿用非参数回归的乐观估计,CPT决策则基于估计的奖励分布计算效用并选臂。理论分析给出CPT遗憾上界,以Eluder维度与覆盖数刻画,与经典非参数Bandits同阶,表明风险敏感偏好不会带来额外的阶数级遗憾代价。作者进一步将算法扩展至未知噪声CDF情形,引入分布Eluder维度刻画CDF学习成本,并针对核CPT Bandits给出基于信息增益的遗憾界,与风险中性核方法速率在忽略对数因子后匹配。该工作为金融、推荐与医疗等风险敏感场景提供了理论基石,实验验证与实践指南尚待补充。
当Bandits遇见累积前景理论
传统Bandits算法通常以期望奖励作为优化目标,但人类决策往往表现出风险敏感特征——这正是累积前景理论(Cumulative Prospect Theory, CPT)所刻画的。一项新的理论研究将CPT引入非参数Bandits与核Bandits框架,提出了NPCB算法,并证明风险敏感决策不会带来额外的阶数级遗憾成本。
累积前景理论(Cumulative Prospect Theory, CPT)由Tversky与Kahneman于1992年提出,是对原始前景理论的改进,用于描述人在不确定性下的风险决策。CPT的核心在于两点:一是概率权重函数,人们对小概率事件赋予过高权重、对中高概率事件赋予过低权重,从而系统性偏离期望效用;二是价值函数,以参考点为界分别定义收益与损失的效用,损失区间通常更陡峭(损失厌恶),且两端呈现风险态度反转——收益区间风险规避、损失区间风险寻求。与期望效用理论不同,CPT效用不是奖励的线性期望,而是对排序后的累积概率施加非线性权重后再加权价值函数,因此它是一个关于奖励分布的非线性泛函。这一性质正是将CPT引入Bandits时的主要技术障碍:传统乐观算法依赖期望的线性可加性,而CPT目标破坏了这一结构,需要重新设计估计与决策流程。
核心问题:CPT下的连续动作空间
研究考虑连续动作空间,且每个臂的噪声分布可以不同(arm-dependent noise)。目标不再是最大化期望奖励,而是最大化CPT效用。CPT对收益与损失采用不同的权重函数与价值函数,这使得决策目标变为非线性泛函,直接套用传统乐观算法不再可行。
作者提出的NPCB(Non-Parametric CPT Bandits) 算法采用解耦设计:均值估计与基于CPT的决策分离进行。均值学习部分沿用非参数回归的乐观估计,而CPT决策则基于估计的奖励分布计算效用并选择臂。这种解耦让算法既能利用非参数函数类的结构,又能嵌入风险敏感偏好。
Eluder维度(Eluder dimension)是衡量函数类“复杂度”的一种组合度量,由Russo与Van Roy提出,常用于分析乐观算法的遗憾。直观上,它刻画的是:在一个函数类中,一个点序列能被“逐点区分”的最大长度——若新点上的函数值总能被此前观测所约束,则序列停止增长。对于线性函数类,Eluder维度与维数同阶;对于一般的非参数函数类,它通常与覆盖数或度量熵相关联。在非参数Bandits的遗憾界中,Eluder维度替代了有限臂数或有限假设数,成为控制探索成本的关键量。本文的CPT遗憾界同时出现Eluder维度与覆盖数,正是非参数函数类复杂度的标准刻画方式,也解释了为何该界与经典非参数Bandits同阶——CPT只改变决策准则,不改变函数类本身的学习难度。
遗憾界:与经典非参数Bandits同阶
理论分析给出了CPT遗憾的上界:
$$\widetilde{\mathcal O}\bigl(\sqrt{T,\dim_E(\mathcal F,T^{-2}),\log N(\mathcal F,T^{-2},|\cdot|_\infty)}\bigr)$$
其中 $\dim_E$ 是函数类 $\mathcal F$ 的Eluder维度,$T$ 是时间跨度,$N$ 是上确界范数下的覆盖数。这一结果与经典非参数Bandits的遗憾同阶,意味着CPT风险敏感性不会带来额外的阶数级遗憾代价。这是该工作最核心的结论:风险偏好可以在不牺牲学习效率的前提下被纳入。
扩展至未知噪声CDF
实际场景中噪声分布往往未知。作者将NPCB扩展到未知噪声CDF的情形,算法保留已知CDF下的均值学习项,并增加一个由分布Eluder维度控制的CDF学习成本。这一扩展表明,分布学习带来的额外代价可以被清晰刻画,且不会破坏整体遗憾的阶数结构。
分布Eluder维度是Eluder维度思想在分布学习上的推广。当噪声CDF未知时,算法不仅需要学习条件均值函数,还需要学习奖励的完整分布(至少是其CDF),因为CPT效用依赖于整个分布而非仅均值。分布Eluder维度衡量的是:在给定历史观测下,候选分布类中仍能被区分的分布数量增长速率。它把“学习分布”的难度量化为一个与函数类结构相关的维度量,从而可以将CDF估计误差纳入遗憾分析。这一概念的价值在于,它使未知噪声情形下的遗憾可以分解为均值学习项与分布学习项之和,并清晰显示后者不会主导整体阶数——只要分布类的分布Eluder维度增长可控,CPT风险敏感目标在未知噪声下依然保持与已知噪声情形相同的遗憾阶数。
核CPT Bandits的信息增益视角
研究进一步考察核CPT Bandits,针对广泛的核函数给出基于信息增益的遗憾界,其结果与对应的风险中性核方法速率在忽略对数因子后相匹配。这从信息论角度说明,CPT风险敏感目标在核方法框架下同样不改变学习速率的阶数。
信息增益(information gain)是核Bandits与高斯过程Bandits分析中的核心工具,通常定义为观测前后对未知函数后验熵的减少量,记为γ_T。在核方法中,最大信息增益与核矩阵的有效维度直接相关,并决定了乐观算法遗憾界中探索项的大小。基于信息增益的遗憾界具有算法无关性:它不依赖于具体的核函数形式,只需核满足一定的正则性,因此能统一覆盖有限维线性核、平方指数核、Matérn核等广泛核类。本文对核CPT Bandits给出信息增益型遗憾界,其意义在于将CPT风险敏感目标嵌入这一成熟分析框架,并证明所得速率与风险中性核方法在忽略对数因子后一致。这从信息论角度说明,CPT的非线性效用只改变决策规则,不改变核函数类所能提供的信息量,因而不会引入额外的学习成本阶数。
实践意义与开放问题
这项工作为风险敏感决策提供了理论基石:在连续动作空间与核方法中,CPT目标可以与高效学习共存。潜在应用包括金融决策、推荐系统与医疗治疗选择等需要刻画风险偏好的场景。不过,当前结果仍以理论为主,实验验证与针对具体CPT参数化的实践指南尚待补充。
要点总结
- NPCB通过解耦均值估计与CPT决策,在连续动作空间实现风险敏感Bandits。
- CPT遗憾与经典非参数Bandits同阶,风险敏感无额外阶数代价。
- 未知噪声CDF扩展引入分布Eluder维度刻画学习成本。
- 核CPT Bandits的信息增益遗憾界与风险中性速率匹配。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。