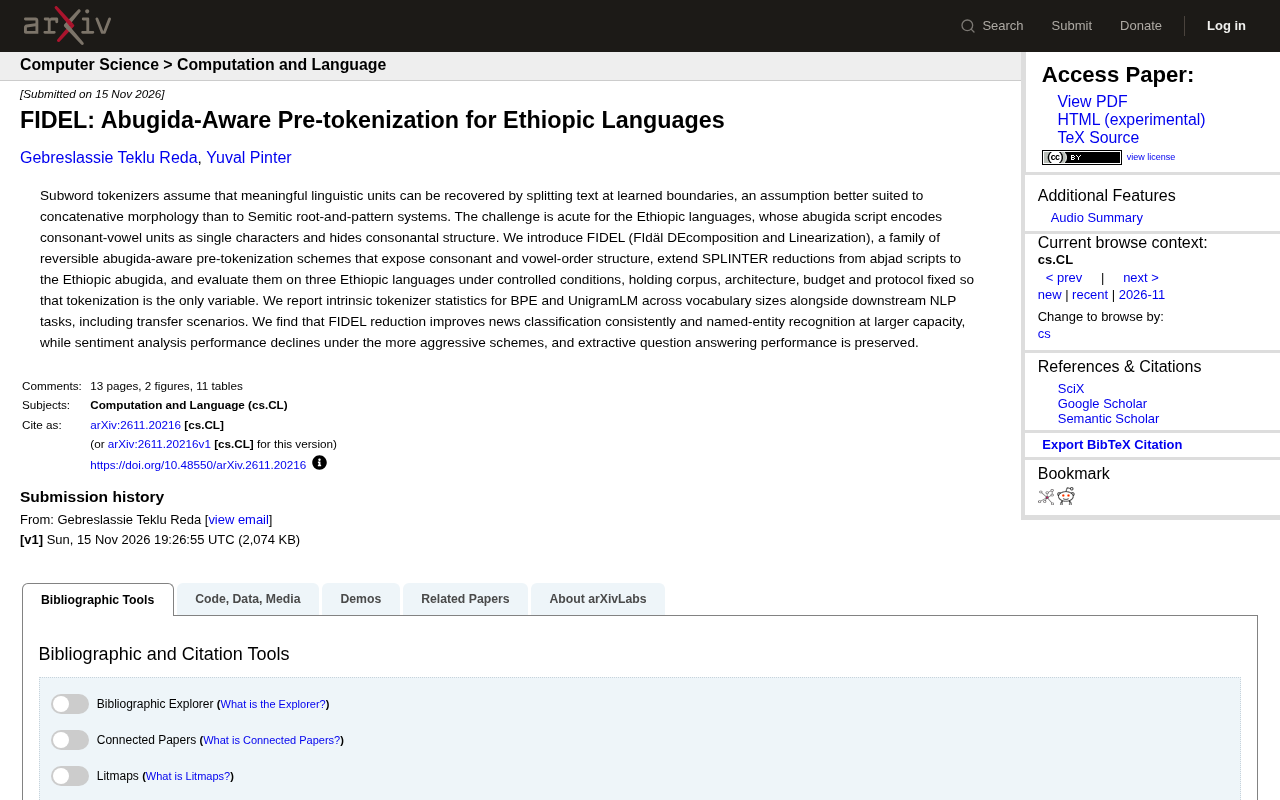
FIDEL:面向埃塞俄比亚语的阿布吉达感知预分词方案

FIDEL提出可逆的阿布吉达感知预分词方案,在埃塞俄比亚语言上提升分类和NER但情感分析下降。
论文提出FIDEL,一种针对埃塞俄比亚阿布吉达文字的可逆预分词方案,通过将字符分解为辅音和元音序并线性化,扩展了SPLINTER方法。在三个埃塞俄比亚语言上的控制变量实验表明,FIDEL缩减持续提升新闻分类性能,在更大模型容量下对NER也有帮助,但更激进的缩减会导致情感分析性能下降,抽取式问答保持不变。这揭示了分词策略的任务依赖性,并展示了语言学先验在低资源、非拉丁文字语言中的价值。
引言
子词分词器(如BPE、WordPiece)假设有意义的语言单元可以通过学习边界来恢复,但这套逻辑更适用于 concatenative morphology(拼接式形态),而对 Semitic root-and-pattern(闪米特语根-模式)系统则水土不服。埃塞俄比亚语系使用的阿布吉达(abugida)文字更是如此:每个字符编码辅音-元音单元,辅音结构反而被隐藏。最近一篇来自rss的论文提出了FIDEL(FIdäl DEcomposition and Linearization),一套可逆的、阿布吉达感知的预分词方案,试图从分词层面注入语言学先验。
问题背景:当分词器遇到阿布吉达文字
主流子词分词器在拉丁字母语言上表现优异,因为它们能通过统计共现学习到词缀边界。但埃塞俄比亚语系的阿布吉达文字将辅音和元音融合为单一字形,例如一个字符同时表示 /kə/ 这样的音节。这导致分词器难以暴露闪米特语中至关重要的辅音词根(consonantal root)结构。论文指出,这种文字特性使得基于学习边界的分词假设不再成立,需要专门的语言学感知预处理。
阿布吉达(abugida) 是一种介于音节文字和辅音音素文字之间的书写系统,每个基本字符代表一个辅音加一个固有元音(通常是 /ə/ 或 /a/),其他元音通过附加符号或字符变体表示。埃塞俄比亚的吉兹文(Ge'ez)及其衍生文字是阿布吉达的典型代表。与拉丁字母不同,阿布吉达文字不单独书写元音,而是将元音信息融合在辅音字形中,因此一个字符同时承载辅音和元音信息。这种特性使得字符序列无法直接反映辅音词根的线性结构,对依赖字符边界的子词分词器构成挑战。
FIDEL方案:分解与线性化
FIDEL的核心是将每个阿布吉达字符分解为辅音和元音序(vowel order)两部分,然后线性化输出。这套方案具有可逆性,即可以从分解后的序列还原原始文本。研究将原本用于abjad(辅音音素文字)的SPLINTER缩减方法扩展到了埃塞俄比亚阿布吉达文字。SPLINTER此前用于阿拉伯语等abjad文字,通过映射辅音模式来减少词表稀疏性。FIDEL在三个埃塞俄比亚语言上进行了评估,实验控制严格:语料、架构、预算和协议固定,分词是唯一变量。
SPLINTER 是一种针对辅音音素文字(abjad)的预分词缩减方法,最初用于阿拉伯语等语言。其核心思想是将词汇映射到辅音骨架(consonantal skeleton),通过合并同辅音模式的词形来减少词表稀疏性。例如,阿拉伯语中许多词形共享相同的辅音词根但元音模式不同,SPLINTER 通过暴露辅音结构帮助模型捕捉形态规律。FIDEL 将这一思路扩展到阿布吉达文字,但需额外处理元音序信息,因为阿布吉达字符本身编码了元音,分解时需将辅音与元音序分离并线性化,同时保证可逆性。
实验设计与评估任务
论文报告了BPE和UnigramLM在不同词表大小下的内在分词统计,并测试了多个下游NLP任务,包括迁移场景。具体任务涵盖新闻分类、命名实体识别(NER)、情感分析和抽取式问答。这种控制变量的实验设计让分词效果可以被干净地隔离出来,避免其他因素干扰。
UnigramLM 是一种基于一元语言模型的分词算法,与 BPE 的贪心合并策略不同,它从大词表出发,通过概率模型逐步剪枝,选择使语料似然最大化的子词集合。UnigramLM 通常能产生更符合语言统计规律的分词,并且支持多种分词候选的采样。在 FIDEL 的实验中,同时使用 BPE 和 UnigramLM 作为基础分词器,可以检验 FIDEL 预分词方案是否与具体分词算法无关,从而增强结论的泛化性。
结果:分类与NER受益,情感分析下降
实验发现,FIDEL缩减持续提升新闻分类性能,在更大模型容量下对NER也有帮助。然而,更激进的缩减方案会导致情感分析性能下降,而抽取式问答性能则保持不变。论文没有回避负面结果,这种坦诚值得肯定。可能的原因是情感分析更依赖词汇层面的细微线索,过度分解破坏了这些信号;而分类和NER更依赖词根和形态结构,因此从辅音暴露中获益。
启示与局限
FIDEL的价值在于展示了语言学先验在分词阶段的有效性,尤其是对形态复杂、文字特殊的语言。但方案并非万能:情感分析上的退化提示我们,预分词策略需要根据任务类型调整。此外,研究仅覆盖三个埃塞俄比亚语言,泛化性有待验证。未来工作可以探索自适应缩减强度或任务感知的分词方案。
结语
对低资源、非拉丁文字的语言来说,FIDEL提供了一条可逆、可控的分词优化路径。它提醒我们,分词不是中立的预处理步骤,而是嵌入语言学假设的设计选择。
相关推荐
FBI警告:黑客用AI代理ARTEX攻击200+组织
FBI发布预警,点名AI渗透框架ARTEX被用于攻击200多家组织,CrowdStrike追踪到VaporPanda团体。本文拆解ARTEX的代理编排架构、真实攻击链与损失数据,并整理FBI给出的五条防御建议。
FBI警告:免费AI黑客工具Artex失控,三小时攻破云系统
FBI警告免费开源AI渗透工具Artex被犯罪与国家背景黑客滥用,最快三小时攻破云系统。本文解析真实攻击案例、被忽视的侧门风险,以及企业与个人可立即采取的防御措施。

Verse Engine:一键将Blender/Unity/Unreal场景变成浏览器3D链接
Verse Engine by Ctruh是一款浏览器原生3D与XR引擎,支持从Blender、Unity、Unreal一键发布3D场景为浏览器链接,无需下载安装。按视野流式传输让10.3亿三角面城市场景在笔记本打开,提供嵌入、API与SDK,适合开发者、3D艺术家、建筑与电商团队。