Firefox智能窗口升级:AI填表与网页监控
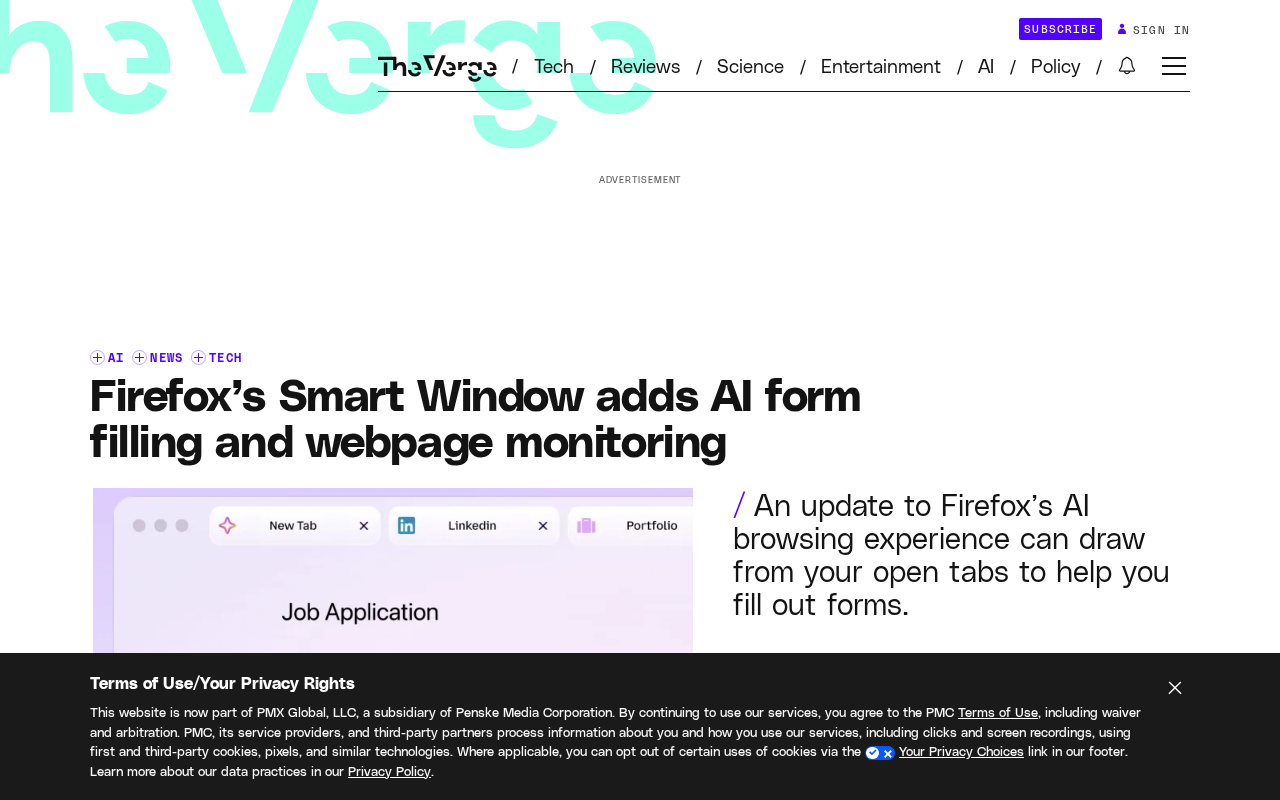
Mozilla为Firefox Smart Window新增标签页内容自动填表与网页监控两项AI原生能力。
Mozilla正在为Firefox的AI浏览体验Smart Window添加两项新功能:一是基于已打开标签页内容自动填写在线表单,例如从LinkedIn或作品集页面提取工作经历填入求职申请;二是网页监控,可跟踪指定页面的内容变化并提醒用户。Smart Window的定位不是侧边栏聊天助手,而是深度融入浏览器日常操作的原生AI能力。这一路线体验更自然,但需要读取标签页内容和持续访问页面,带来隐私与权限设计挑战。Mozilla尚未公布具体的隐私控制机制、数据处理方式和上线时间,表单填充准确率与监控可靠性也有待真实使用验证。
Mozilla正在为Firefox的AI浏览体验——Smart Window——添加新功能,让浏览器不仅能阅读网页,还能主动帮你填写表单,并监控页面变化。
从标签页中提取信息,自动填充表单
Smart Window的新能力之一是基于已打开的标签页内容填写在线表单。Mozilla给出的例子很具体:当用户申请工作时,Smart Window可以从其在线作品集或LinkedIn页面中提取工作经历,并粘贴到求职申请中。
这意味着浏览器不再只是被动展示页面,而是开始理解你打开的多个标签页之间的语义关联。传统浏览器的自动填充依赖本地存储的地址、电话等结构化数据,而Smart Window的做法更接近“阅读并理解”你的个人资料页面,再动态生成表单字段的答案。
这种能力如果落地顺畅,对频繁填写重复信息的场景——求职、注册、申请——会有明显效率提升。但同时也引出一个问题:浏览器如何判断哪些标签页内容可以被用于填表?用户是否需要逐次授权?Mozilla目前透露的细节有限,这些边界设计将决定功能的实际体验。
传统浏览器自动填充依赖结构化数据(如地址、信用卡、电话),这些数据由用户手动保存或系统根据表单历史记录学习。而Smart Window需要处理的是非结构化信息:LinkedIn页面上的工作经历以自然语言段落、时间线和职位描述呈现,没有统一schema。要实现提取并填入求职申请表,浏览器需要做语义理解——识别哪些文本片段对应“公司名称”“任职时间”“职位职责”,再映射到目标表单的字段。这本质上是一个信息抽取(Information Extraction)任务,涉及命名实体识别、关系抽取和文本生成。AI模型在这里的准确率直接决定功能是否可用:一旦把“期望职位”填成“过往职位”,用户就需要逐项核对,效率优势荡然无存。
网页监控:让浏览器替你盯着变化
除了表单填充,Smart Window还加入了网页监控能力。虽然原始信息没有展开具体实现方式,但从功能命名来看,浏览器可以跟踪指定页面的内容变动,并在发生变化时提醒用户。
这类需求在现实中并不少见:等待补货的商品页面、关注的价格变动、需要留意的公告更新。过去用户依赖第三方监控工具或浏览器扩展,如果Smart Window原生集成这一能力,相当于把“定时检查”变成了浏览器的内置行为。
结合AI能力,网页监控可以做得更智能——不是简单比对HTML差异,而是理解页面内容的实质变化,过滤掉广告轮播、推荐位刷新等噪声。这恰好是AI擅长而传统监控工具薄弱的地方。
网页监控的技术实现通常有几种路径:轮询(定时请求页面比对内容)、DOM差异检测(监听页面结构变化)和基于选择器的定向监控(只跟踪特定元素)。传统工具多采用最后一种,用户需要手动指定CSS选择器或XPath。AI增强的监控则试图自动识别“有意义的变化”,例如区分商品价格从199降到149和推荐位轮播图刷新。这需要模型理解页面各区域的功能属性,而非机械比对文本差异。浏览器内置监控还有一个天然优势:它已经拥有用户的会话和Cookie,可以访问登录后的页面,而第三方监控工具往往受限于权限或需要额外授权。
Smart Window的定位:AI浏览体验的实验场
Smart Window是Mozilla为Firefox打造的AI驱动浏览体验。从目前披露的功能看,它的思路不是做一个独立的AI助手,而是把AI能力嵌入浏览器的日常操作中——填表、监控、内容理解。
这与当前浏览器AI化的两条路线形成对照:一条是侧边栏聊天助手,另一条是深度融入页面操作的原生能力。Smart Window显然属于后者。优势是体验更自然,挑战是隐私和权限设计更复杂——浏览器需要读取你的标签页内容,才能完成填表;需要持续访问页面,才能实现监控。
Mozilla历来在隐私问题上态度鲜明,Smart Window能否在能力与信任之间找到平衡,会是它能否被用户接受的关键。目前官方透露的信息还停留在功能示例层面,具体的隐私控制、数据处理方式、上线时间都尚未明确。
浏览器AI化的侧边栏路线以Microsoft Edge的Copilot为代表:AI作为独立面板存在,用户主动提问,AI基于当前页面回答,但不会直接操作用户的页面元素。原生能力路线则让AI直接读取标签页内容、填写表单、触发页面操作,体验更连贯但权限更大。两条路线的隐私模型截然不同:侧边栏AI通常只处理用户显式提交的内容,而原生能力需要持续、后台地访问页面数据。Mozilla选择后者,意味着Smart Window需要建立一套细粒度的权限体系——比如按站点授权、按功能开关、操作前确认——才能让用户放心把标签页内容交给浏览器处理。
值得关注的几个问题
对于开发者和重度浏览器用户来说,Smart Window的演进值得跟踪。它代表了一种方向:浏览器从“展示网页的工具”变成“理解并操作网页的代理”。表单填充和网页监控只是起点,如果这套能力对外开放,第三方场景的想象空间会更大。
短期内,用户最关心的可能还是实际可用性:表单填充的准确率如何、监控的触发是否可靠、误报多不多。这些都需要真实使用才能验证。Mozilla目前给出的信息足以让人产生兴趣,但距离完整评估还有距离。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。