Firestore新功能:用自然语言查询数据库,无需复杂解析器
Firestore 新增自然语言查询能力,通过上下文集和查询端点让开发者快速构建数据库对话 AI agent。
Firestore 推出查询数据支持,使开发者能用自然语言与数据库对话。核心机制分两步:在 Firestore Studio 中定义上下文集,将自然语言概念映射到集合与字段;再通过查询数据端点传入用户问题和上下文集 ID。Studio 内可用 Gemini 测试并调优查询模板,端点则返回结构化数据、对话式答案或澄清性问题。该功能省去了自建查询解析器、意图识别和实体映射的繁重工作,把构建数据库对话接口简化为几步配置和一次 API 调用,显著降低门槛,尤其适合已使用 Firestore 的团队快速为内部工具或客服系统添加自然语言查询能力。
Firestore 最新推出的查询数据支持,让开发者能够构建出用自然语言与数据库对话的 AI agent。这意味着,用户可以直接用日常语言提问,而不再需要编写复杂的查询语句或依赖繁琐的解析器。
核心机制:上下文集与查询端点
要实现这一功能,核心在于两个步骤:定义上下文集和调用查询端点。
首先,在 Firestore Studio 中定义上下文集(context set)。这个步骤相当于“教会”AI agent 理解你的数据结构——将自然语言概念映射到实际的集合(collections)和字段(fields)上。正如视频截图所示,整个过程无需编写复杂的查询解析器。
定义好上下文集后,你可以在 Studio 中直接测试提示词(prompts),例如询问“今天哪个用户升级了?”(which user is upgraded today?)。Gemini 会据此调整查询模板,直到结果足够可靠。
接下来,从你的后端或前端发起一个简单的调用,请求查询数据端点(query data endpoint),并传入用户的自然语言问题以及上下文集 ID。Firestore 会解析意图、执行查询,并返回结构化数据、对话式答案,甚至在你提问时给出澄清性问题。
上下文集(Context Set) 是 Firestore 为自然语言查询引入的配置层,本质上是一份语义映射表。它将业务领域中的自然语言概念(如“用户”“升级”“今天”)绑定到具体的集合路径(如 users)、字段名(如 plan、upgraded_at)以及可选的值域说明。这种映射让底层模型在生成查询时不必猜测表结构,从而避免“字段不存在”或“语义歧义”类错误。上下文集与数据库 schema 解耦,可独立版本化管理,也支持为同一数据库定义多个上下文集以服务不同业务场景(如客服、运营分析)。
查询数据端点(Query Data Endpoint) 是一个由 Firestore 托管的 API,接收自然语言问题与上下文集 ID,内部完成意图解析、查询构造与执行,并以 JSON 返回结果。它把传统上需要自行搭建的 NL2SQL/NL2Query 流水线封装为一次调用:开发者无需维护解析器、实体识别模型或查询模板引擎。端点返回的“澄清性问题”是一种交互式兜底机制——当问题缺少时间范围、对象限定等关键信息时,系统会反问用户,而不是返回空结果或错误查询。
实际工作流程
整个流程可以概括为三个环节:
- 定义上下文集:在 Firestore Studio 中,将自然语言概念映射到数据库的集合和字段。
- 测试与调优:在 Studio 中直接输入提示词进行测试,Gemini 会优化查询模板,确保结果准确。
- 集成调用:在后端或前端代码中调用查询数据端点,传入用户问题和上下文集 ID。
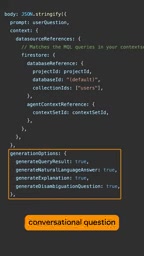
Firestore 会返回三种类型的结果:结构化数据、对话式回答,以及必要的澄清性问题。这使得开发者能够快速将原始的 Firestore 集合转化为智能的对话助手,回答复杂的数据库问题。
Gemini 调优查询模板 指的是在 Firestore Studio 中,系统利用 Gemini 模型根据测试提示词反复修正底层查询模板的过程。开发者输入的每个自然语言问题都会被用来检验模板能否正确映射到集合、字段与过滤条件;当结果偏离预期时,模型会调整模板中的字段选择、运算符或聚合方式。这一环节把传统上依赖人工编写的查询逻辑转化为可迭代的提示词驱动调优,使非查询专家也能通过试错把准确率提升到可接受水平,最终固化为生产环境可复用的上下文集配置。
意义与展望
这一功能的推出,大幅降低了构建数据库对话接口的门槛。传统上,要实现自然语言查询,开发者需要构建复杂的查询解析器、处理意图识别和实体映射,工作量巨大。而 Firestore 的新支持将这一过程简化为几步配置和一次 API 调用。
对于已经使用 Firestore 的团队来说,这意味着可以快速为内部工具或客户支持系统添加自然语言查询能力,而无需重写数据层。随着 AI agent 的普及,这种“对话即查询”的模式有望成为数据库交互的新常态。
相关推荐
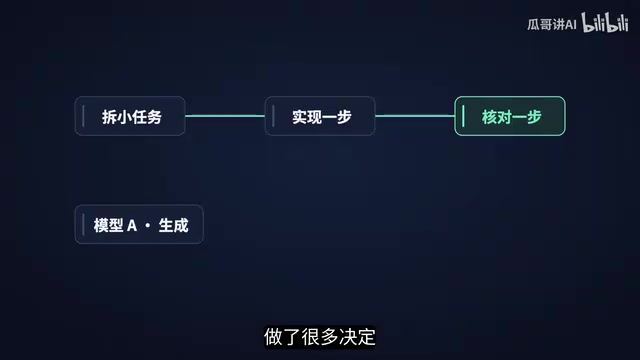
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。