Fisher几何重塑对抗训练:突破伪攻击困境
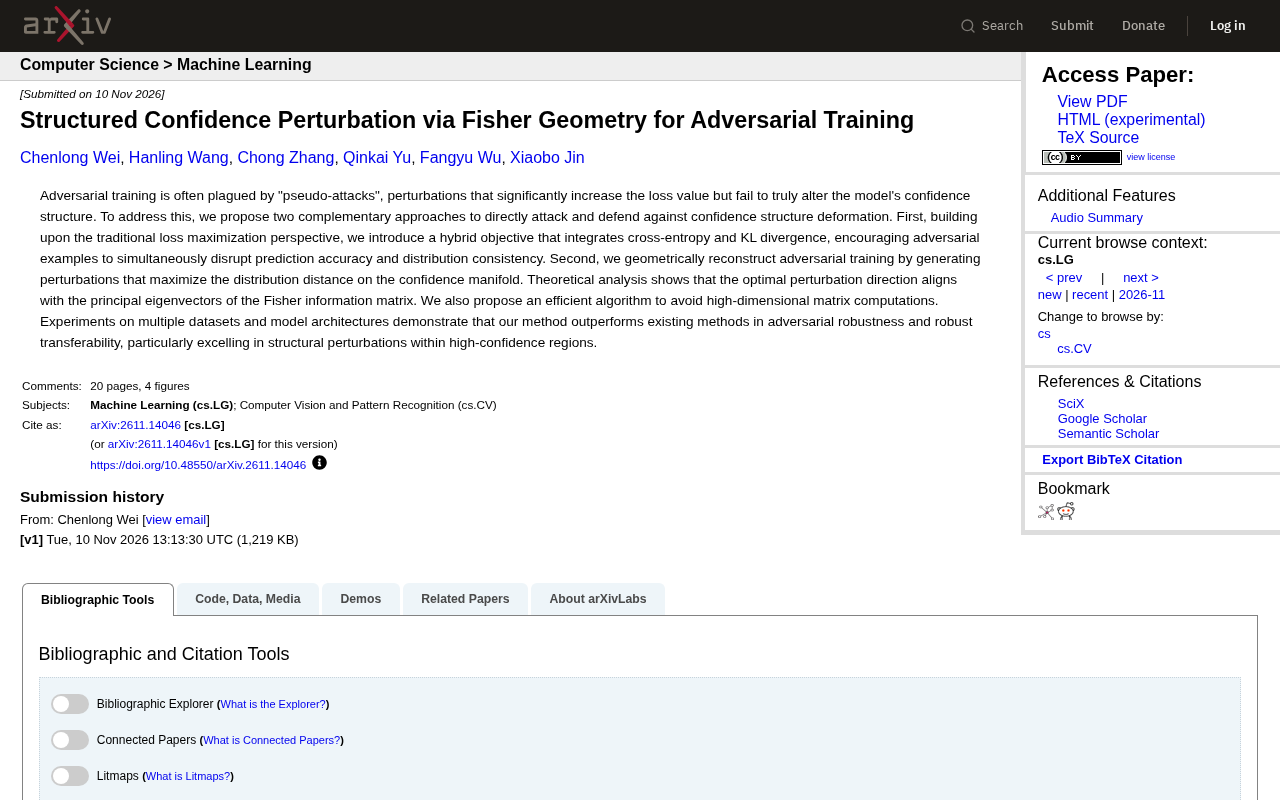
论文用Fisher信息几何重塑对抗训练,破解损失升高但置信度结构不变的伪攻击困境。
传统对抗训练通过最大化损失生成对抗样本,但存在“伪攻击”问题:扰动虽显著抬高损失,却几乎不改变模型输出的相对置信度分布,模型只是被“吓到”而非被“说服”。论文从置信度结构角度重新审视该问题,提出两种互补方案。其一是混合目标,将交叉熵与KL散度结合,迫使对抗样本同时破坏准确率与分布一致性;其二是几何重构,将置信度分布视为流形,证明最优扰动方向与Fisher信息矩阵主特征向量对齐,并通过幂迭代等近似方法避免高维矩阵分解,计算成本与标准对抗训练相当。实验表明该方法在鲁棒性与鲁棒迁移性上均优于现有方法,尤其在高置信度区域能有效破坏结构脆弱性。
Fisher几何重塑对抗训练:突破伪攻击困境
对抗训练是提升模型鲁棒性的主流方法,但它长期被“伪攻击”问题困扰:许多对抗扰动虽然显著提高了损失值,却未能真正改变模型的置信度结构。换句话说,模型可能只是被“吓到”了,而不是被“说服”了。近期一篇论文提出从置信度结构的角度重新审视对抗训练,并利用Fisher信息几何给出了两种互补的解决方案。
伪攻击:对抗训练中的隐形陷阱
传统对抗训练通过最大化损失函数来生成对抗样本,迫使模型在扰动下仍能正确分类。然而,损失值的上升并不等价于决策逻辑的破坏。论文指出,存在一类扰动,它们能让损失飙升,却几乎不改变模型对各类别的相对置信度分布——这就是“伪攻击”。
伪攻击的危害在于,它让对抗训练看似有效,实则未能触及模型的脆弱本质。模型可能学会了在特定扰动模式下“硬扛”损失,但置信度结构依然脆弱,面对真正具有语义破坏性的攻击时仍会失效。
置信度结构指的是模型对各个类别的输出概率分布形态,而不仅仅是最高概率对应的类别标签。一个扰动如果只让正确类别的概率从0.9降到0.8、错误类别仍保持在0.05左右,那么模型的相对判断逻辑几乎没有改变,只是整体置信度被压缩了。这种“结构不变、幅度变化”的扰动正是伪攻击的典型形态。理解这一点需要区分两个层面:一是标量损失值,它汇总了所有类别的信息;二是向量化的概率分布,它保留了类别间的相对关系。对抗训练的初衷是破坏后者,但优化器只“看见”前者,于是产生了目标与效果之间的错位。
混合目标:同时破坏准确率与分布一致性
第一种方案延续了损失最大化的思路,但引入了更丰富的目标。论文提出一个混合目标函数,将交叉熵损失与KL散度结合,鼓励对抗样本同时破坏预测准确率和输出分布的一致性。
交叉熵负责拉低正确类别的概率,KL散度则强制模型输出的分布偏离原始干净样本的分布。两者结合,使得生成的对抗样本不再只是“让模型犯错”,而是“让模型以不同的方式犯错”——置信度结构被迫发生实质性变形。
这一设计简单却有效,它从损失层面部分缓解了伪攻击问题,因为单纯提高损失但保持分布一致的扰动会被KL项惩罚。
KL散度(Kullback-Leibler divergence)衡量两个概率分布之间的差异,定义为 $D_{KL}(p | q) = \sum_i p_i \log(p_i/q_i)$,取值非负且仅在两个分布完全相同时为零。在对抗样本生成中,通常将干净样本的输出分布作为参考分布 $p$,对抗样本的输出分布作为 $q$,KL项越大说明两者的置信度结构偏离越远。与交叉熵不同,KL散度对分布的“形状”敏感:即使两个分布的最高类别相同,只要各类别概率的相对比例不同,KL值就会上升。因此它恰好能惩罚那些“只压低保真度、不改变类别间相对关系”的伪攻击扰动。需要注意KL散度不对称,实际使用时需明确参考分布的方向。
几何重构:在置信度流形上最大化分布距离
第二种方案更为根本。论文从几何角度重构对抗训练:将模型输出的置信度分布视为一个流形,对抗扰动的目标是最大化该流形上的分布距离。
理论分析揭示了一个优雅的结论:最优扰动方向与Fisher信息矩阵的主特征向量对齐。Fisher信息矩阵刻画了模型输出分布对参数的敏感度,其主特征向量指向置信度流形上曲率最大的方向。沿此方向扰动,能以最小的扰动幅度换取最大的分布偏移。
这解释了为何传统损失最大化容易产生伪攻击:它没有考虑流形的几何结构,可能在平坦方向上浪费扰动预算。
Fisher信息矩阵是统计模型中刻画参数估计精度的一个核心量,定义为对数似然函数梯度的协方差,等价于对数似然的海森矩阵的期望。在深度学习中,它描述了模型输出分布对参数扰动的敏感程度:Fisher矩阵在某个方向上的特征值越大,说明沿该方向微调参数会引起输出分布越剧烈的变化。因此其主特征向量对应“最敏感”的方向。从信息几何的角度看,Fisher矩阵定义了参数空间上的一个黎曼度量,使得分布之间的KL散度在该度量下可局部近似为二次型。这正是论文能用主特征向量指导扰动的理论根基——沿主特征向量走一步,等价于在分布空间中走最远的距离。
高效算法:避开高维矩阵计算
直接计算Fisher信息矩阵的主特征向量在高维模型中不可行。论文提出了一种高效算法,通过近似和迭代方法避免显式构造和分解高维矩阵。
具体而言,算法利用Fisher信息矩阵与梯度外积的关系,通过矩阵-向量积的幂迭代来逼近主特征向量,计算成本与标准对抗训练相当。这使得该方法可以无缝集成到现有训练流程中,而不带来显著开销。
幂迭代(power iteration)是一种求解矩阵主特征向量的经典迭代方法:从一个随机向量出发,反复用矩阵乘该向量并归一化,向量会收敛到绝对值最大的特征值对应的特征向量。其优势在于只需要矩阵-向量积,无需显式构造或分解矩阵。在本文场景中,Fisher矩阵可以写成梯度外积的期望 $F = \mathbb{E}[\nabla_\theta \log p(y|x) \nabla_\theta \log p(y|x)^\top]$,因此 $Fv$ 可通过“先算梯度与 $v$ 的内积、再乘梯度并求期望”来高效估计,单次迭代成本与一次前向-反向传播相当。配合少量迭代步数,整体开销即可控制在标准对抗训练的同一量级。
实验表现:鲁棒性与迁移性双提升
论文在多个数据集和模型架构上进行了实验。结果表明,该方法在对抗鲁棒性和鲁棒迁移性上均优于现有方法。
尤其你可能没注意到,在高置信度区域的结构扰动上,该方法表现突出。高置信度区域是模型最“自信”的地方,传统攻击难以撼动其置信度结构,而Fisher几何引导的扰动能够有效破坏这种结构,暴露出更深层的脆弱性。
启示:从“损失对抗”到“结构对抗”
这项工作的核心贡献在于将对抗训练的焦点从损失值转移到置信度结构。伪攻击问题的根源在于目标函数与真实脆弱性之间的错位,而Fisher几何提供了一种原则性的方式来对齐二者。
对于实践者而言,混合目标方案易于实现,可作为现有对抗训练流程的即插即用改进;几何方案则提供了更深层的理论视角,有望启发更多基于信息几何的鲁棒性研究。两者共同指向一个趋势:对抗训练正在从粗放的损失最大化,走向精细的结构化扰动。
相关推荐

智能体与工作流:LangGraph 工作流编排的核心概念解析
基于B站老肖的LangGraph教程,解析工作流与智能体的本质区别:编排权归属、复杂业务选型、StateGraph三大组件及构建流程,帮助开发者合理选择架构方案。
LangGraph工作流与智能体:企业级AI编排新解
LangGraph工作流与智能体的核心区别是什么?本文解析状态图三要素(状态、节点、边),探讨工作流如何编排复杂AI业务,以及LangChain 1.0企业级应用中的协同策略。

4个习惯正在偷走你的Claude Code额度(附诊断提示词)
Claude Code额度消耗过快?本文拆解4个常见烧额度习惯:模糊需求、冗长日志、随意开子代理、长会话不切换。附一个能扫描最近七天日志、自动找出你个人耗电前三名的提示词,并给出针对性修正规则。