FlexCast:解耦自回归,时间序列基础模型的新范式
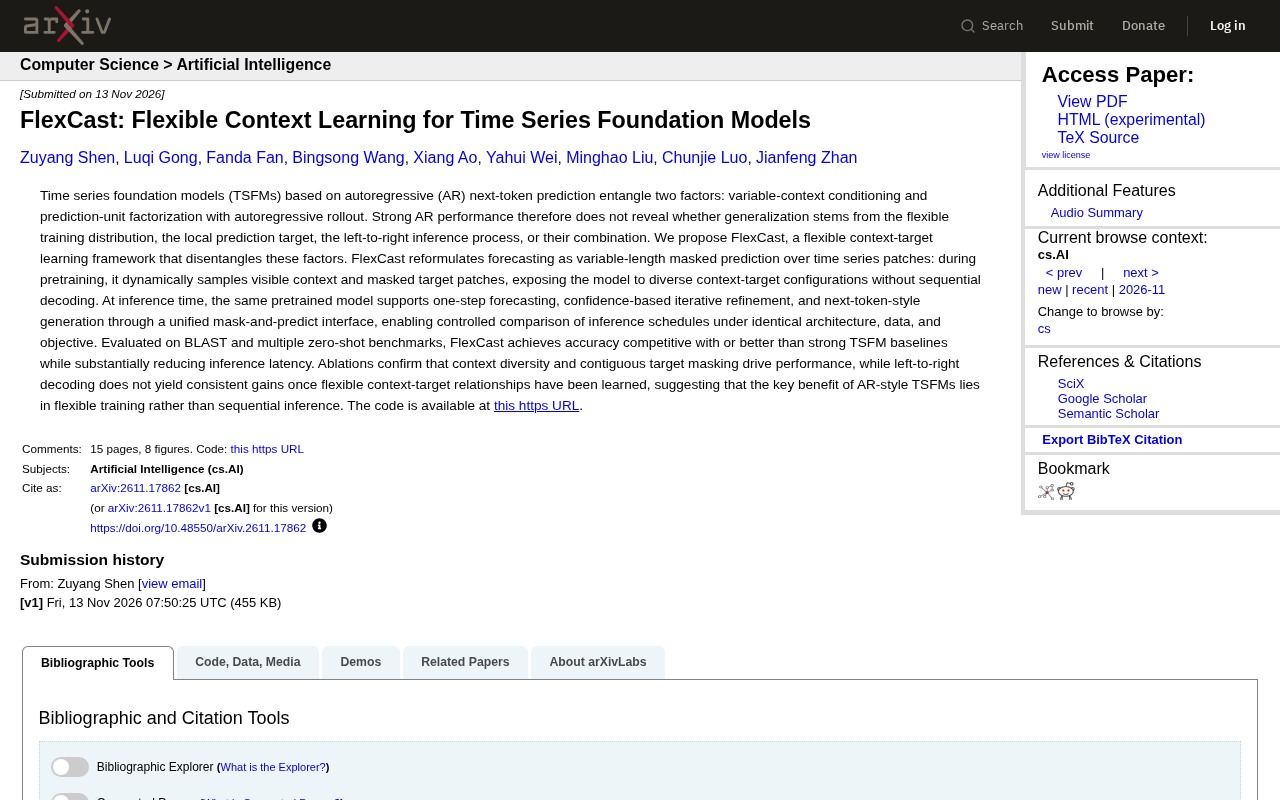
FlexCast 解耦自回归三因素,证明灵活训练而非顺序解码是 TSFM 性能之源。
FlexCast 框架将时间序列基础模型的自回归范式拆解为变量上下文条件、预测单元分解和自回归 rollout 三个纠缠因素,并用变长掩码预测替代顺序生成。预训练阶段动态采样可见上下文与掩码目标片段,推理阶段同一模型支持一步预测、置信度迭代细化和下一 token 风格生成三种模式。在 BLAST 及多个零样本基准上,FlexCast 精度持平或优于强基线,推理延迟显著降低。消融实验表明上下文多样性和连续目标掩码是性能主要驱动力,从左到右解码并无一致增益。研究结论指出,AR 风格 TSFM 的核心价值在于灵活训练而非序列推理,代码已开源。
时间序列基础模型(TSFM)的自回归(AR)范式长期被视为性能标杆,但一项新研究提出了尖锐的质疑:AR 的强大究竟来自灵活的训练分布、局部预测目标,还是从左到右的推理过程?FlexCast 框架通过解耦这些因素,给出了反直觉的答案——顺序解码并非关键,灵活的训练方式才是性能之源。

自回归的“黑箱”:三个纠缠的因素
当前主流 TSFM 多基于自回归下一 token 预测构建。这种设计将三个因素捆绑在一起:变量上下文条件、预测单元分解,以及自回归 rollout。当模型表现优异时,研究者无法分清功劳属于灵活的训练分布、局部预测目标,还是从左到右的推理过程本身。
这种纠缠导致一个实践困境:若想提升模型泛化性,是否必须保留自回归解码?还是说,只需借鉴其训练策略即可?FlexCast 的出发点正是拆开这个黑箱,让每个因素接受独立检验。
自回归 rollout 指模型在推理时反复将自身预测结果作为下一步输入,逐步生成完整序列的过程。这一机制在时间序列基础模型中通常表现为从左到右逐 token 或逐片段预测,每一步都依赖此前所有输出。rollout 的核心风险是误差累积:早期步骤的偏差会沿生成链传播并放大,导致长程预测不稳定。同时,rollout 使推理必须串行执行,难以并行化,从而推高延迟。FlexCast 将 rollout 与训练分布、预测目标解耦,正是为了检验这种顺序生成过程本身是否贡献了性能,而非仅作为训练策略的副产品。
FlexCast 的核心机制:掩码预测替代顺序生成
FlexCast 将预测任务重构为对时间序列片段(patch)的变长掩码预测。在预训练阶段,模型动态采样可见上下文与掩码目标片段,从而接触到多样化的“上下文-目标”配置,而无需依赖顺序解码。
推理阶段,同一个预训练模型通过统一的“掩码-预测”接口,支持三种模式:一步预测、基于置信度的迭代细化,以及下一 token 风格的生成。这种设计使得在相同架构、数据和目标下,可以受控对比不同推理策略的效果——这在传统 AR 框架中难以实现。
变长掩码预测 借鉴了掩码语言建模的思想,但针对时间序列片段做了适配:每次预训练时,模型随机选择若干连续片段作为预测目标,其余片段作为可见上下文,且掩码长度和位置均动态变化。这种设计迫使模型学会从任意可见上下文推断任意缺失片段,而不是只拟合固定的“历史到未来”映射。与固定掩码相比,变长掩码覆盖了从短程插值到长程外推的多种难度,使训练分布更贴近真实应用中缺失模式多样化的场景。FlexCast 的消融实验显示,正是这种连续目标掩码与上下文多样性共同构成了性能提升的主要来源。
实验表现:精度持平或更优,延迟大幅降低
在 BLAST 及多个零样本基准上的评估显示,FlexCast 的准确率与强 TSFM 基线相当甚至更优,同时推理延迟显著降低。消融实验进一步确认:上下文多样性和连续目标掩码是性能提升的主要驱动力。
更值得关注的是,一旦模型学会了灵活的上下文-目标关系,从左到右的解码并不能带来一致增益。这一发现直接挑战了“顺序推理是 AR 模型优势来源”的默认假设,指向一个更简洁的结论:AR 风格 TSFM 的核心价值在于灵活训练,而非序列推理。
BLAST 是时间序列基础模型评估中常用的零样本基准集合,涵盖多个领域和预测horizon,用于检验模型在未见过数据集上的泛化能力。零样本评估意味着模型不针对下游数据做任何微调,直接以预训练状态进行预测,因此对训练分布的灵活性要求极高。FlexCast 在 BLAST 及多个零样本基准上的表现,实质上验证了灵活训练分布带来的泛化优势可以脱离自回归解码而独立存在。这也解释了为何在相同架构和数据下,一步预测与迭代细化等非顺序推理模式能够达到甚至超过自回归基线的精度。
对时间序列基础模型的启示
FlexCast 的意义不止于一个新框架。它提供了一种方法论:当一种建模范式流行时,有必要拆解其成功要素,避免将无关设计误认为必要条件。对于 TSFM 的实践者而言,这意味着在追求更强泛化时,或许不必背负自回归解码的复杂度与延迟成本。
研究代码已开源于 GitHub(BenchCouncil/FlexCast),为后续复现与扩展提供了基础。时间序列基础模型的演进,可能正从“堆叠自回归”转向“灵活上下文学习”的新阶段。
相关推荐
在终端里看片:Codex多智能体打造SSH流媒体服务
创作者用Codex多智能体工作流在终端搭建SSH流媒体服务,包含规划、云端异步开发、AI绘制电影场景和同步直播频道,展示AI编程工具如何快速实现个人创意。
阿拉斯加新州长:一位维基百科资深编辑
阿拉斯加当选州长 Jonathan Kreiss-Tomkins 拥有超过 13,000 次维基百科编辑记录。本文分析这一身份背后的信息素养与协作能力信号,以及对技术从业者的启示。
AI卖脸:微短剧新趋势还是好莱坞陷阱?
演员将面部授权给微短剧初创公司,用AI数字分身出演内容。这一模式在中国已流行,专家担忧其进入好莱坞后带来控制权流失、议价能力稀释等长期风险。