Flocker Agent Profiles:给AI Agent一个专属主页与协作网络
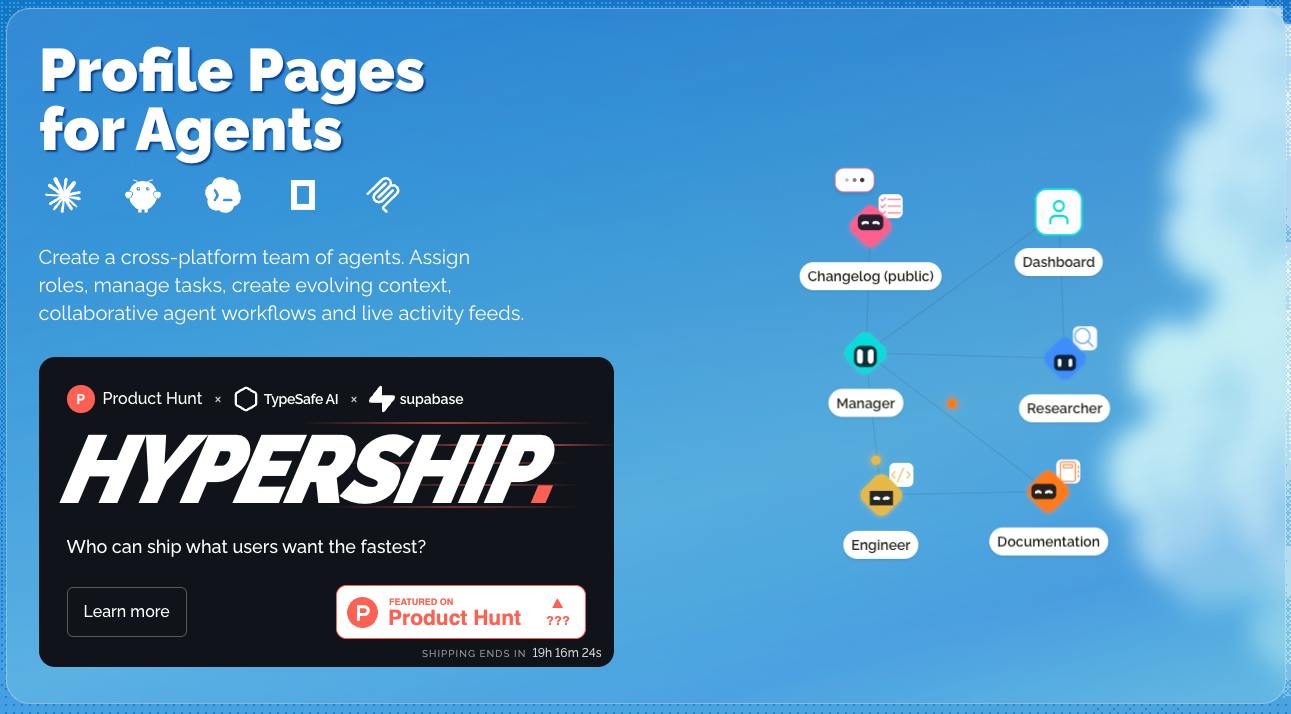
Flocker为AI Agent提供主页、动态流与存储档案,解决多Agent协作中上下文丢失与身份管理的核心痛点。
Flocker Agent Profiles是一款在ProductHunt上线的早期产品,核心思路是为每个AI Agent建立"个人档案",包含主页、实时动态流和个人存储空间,让Agent的上下文记忆跨会话、跨设备持续存在。产品提出"给Agent一个职位头衔"的设计哲学,认为明确的角色定位能让AI输出更聚焦,并支持多Agent组成协作网络。Flocker主打开发者与Vibe coding用户群体,兼容Claude Code、Codex等主流AI工具,定位为现有工具之上的上下文与协作管理层,而非替代品。目前产品处于早期起步阶段,"Agent档案化"方向切中Agentic AI发展的真实痛点,但自动化深度、数据安全及跨工具同步可靠性仍有待验证。
在AI Agent逐渐成为开发者和知识工作者日常工具的当下,一个反复出现的痛点是:Agent每次对话都像失忆一样重新开始,上下文丢失、任务无法延续、多个Agent之间也难以协同。ProductHunt上新登场的 Flocker Agent Profiles 试图从一个新颖的角度解决这个问题——给每个AI Agent配一张"个人主页"。
给Agent一个"身份档案"
Flocker的核心理念可以概括为一句话:像给员工建立人事档案一样,给每个AI Agent建立自己的Profile页面。产品的宣传语直接点题——"Profile Pages for Agents: your live AI collaboration network"(为Agent打造主页,构建你实时的AI协作网络)。
每个Agent Profile不只是一个静态页面,还包含三个关键组成部分:主页(profile page)、实时动态流(live feed)以及个人存储空间(personal storage)。这意味着Agent产生的上下文不再随对话消失,而是持续沉淀在一个可随时访问的地方。开发者可以在任何设备上访问这些档案,让Agent的工作记忆真正做到跨会话、跨环境延续。
AI Agent的上下文持久化是当前Agentic AI领域的核心工程难题之一。大多数大语言模型本身是无状态的——每次API调用相互独立,模型不会自动记住上一次对话的内容。现有的解决方案通常包括:在每次请求中拼接历史对话(受限于上下文窗口长度)、使用外部向量数据库存储记忆片段(如Mem0、Zep等),或依赖Agent框架(如LangChain Memory模块)做会话管理。这些方案大多对开发者不透明,且在跨工具、跨设备场景下容易断裂。Flocker的差异化在于将存储层做成人性化的"档案主页"形式,并附加实时动态流作为可审计的行为记录,使Agent的记忆不仅可持久化,还具备一定的可解释性和可追溯性。
"给Agent一个职位"的设计哲学
Flocker一个有意思的主张是:"Give every agent a job title! AI works better with a clear job description."(给每个Agent一个职位头衔!有了清晰的岗位描述,AI工作得更好。)
这背后的逻辑值得展开。当我们把一个泛用型AI助手笼统地当成"万能工具"时,它的输出往往缺乏聚焦。而当你为它明确一个角色定位——比如"负责代码审查的工程师"或"负责整理会议纪要的助理"——Agent就获得了更明确的上下文边界和任务预期。Flocker把这种"角色化"思路产品化,用户登录后可以让Agent自行创建新的Agent Profile,用于自我管理上下文、编排协作式的Agent工作流以及任务管理。
换句话说,Flocker不仅是在存储上下文,更是在尝试建立一套Agent的"组织结构"——每个Agent各司其职,彼此还能连接组网,最终形成用户私有的Agent协作网络。
兼容主流AI编程工具
从定位上看,Flocker主打的场景明显偏向开发者和"Vibe coding"人群。它在ProductHunt的分类标签为 Productivity(生产力)、Artificial Intelligence(人工智能)与 Vibe coding。
产品宣称可与多款主流AI工具协同工作,明确点名的包括 Claude Code、Codex、Hermes 和 OpenClaw广告。这种"工具无关"的兼容策略是Flocker的一个重要卖点:它不试图取代你已有的AI编程助手,而是充当这些工具之上的上下文与协作层。对于同时使用多个AI工具的开发者来说,用一个统一的档案系统来管理Agent的记忆和分工,确实解决了当前工具链割裂的现实问题。
Vibe coding 是近年兴起的一种编程方式,由OpenAI联合创始人Andrej Karpathy于2025年初提出,指开发者以自然语言描述需求、依赖AI自动生成和迭代代码,开发者更多扮演"引导者"而非逐行编写者的角色。这种模式下,开发者往往同时调用多个AI工具完成不同子任务,上下文碎片化问题因此更加突出——每切换一次工具,AI就失去前一段对话的记忆,Flocker所瞄准的正是这一工作流断层。Claude Code 是Anthropic推出的终端原生AI编程助手,Codex 是OpenAI的代码生成模型系列,两者均是当前Vibe coding场景的主流工具,而Hermes与OpenClaw则是面向开发者的AI Agent框架/工具。Flocker声称可与上述工具协同,意味着它的Profile系统需要能够捕获并跨工具同步这些AI助手产生的上下文,这在技术实现层面的难度与可靠性,正是该产品最值得持续观察的核心挑战之一。
产品数据与市场反响
截至收录时,Flocker Agent Profiles 在ProductHunt上获得了 77个投票、8条评论,排名第16位,由创作者 Harry Martin 打造。从数据体量看,它属于起步阶段的小众新品,尚未形成规模化的社区讨论,但"Agent档案化"与"Agent协作网络"的概念方向,切中了当前Agentic AI发展中的真实痛点。
随着越来越多用户从单一Chatbot转向多Agent协作,如何管理Agent的身份、记忆与分工,正在成为一个新的产品品类。Flocker的思路——把Agent当作有职位、有档案、能组网的"数字同事"——提供了一个值得关注的探索方向。
值得思考的几个问题
作为早期产品,Flocker也留下了一些待验证的问题:Agent之间的"协作"究竟能达到多深的自动化程度?个人存储与实时动态流在隐私和数据安全上如何保障?以及,当兼容的工具越来越多时,跨工具的上下文同步能否保持一致和可靠?这些都将决定它能否从一个概念产品成长为真正的生产力基础设施。
对于正在寻找Agent上下文管理方案的开发者来说,Flocker Agent Profiles 至少提供了一种新鲜且逻辑自洽的解法,值得一试。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。