Florence-2-Large入门指南:一个模型搞定多任务视觉

Florence-2-Large 以统一架构和提示词切换多任务,省去多模型编排,但需权衡文本解析、颜色丢失与授权限制。
Florence-2-Large 是一个基于序列到序列 Transformer 的视觉基础模型,训练于含 1.26 亿图像、54 亿标注的 FLD-5B 数据集。其核心价值不在单项任务极致,而在「一次部署、多任务复用」:图像描述、目标检测、区域描述、视觉定位与分割提示生成均可通过切换 task_input 调用,省去多模型串联的延迟与工程复杂度。文章给出四类优先场景(商品智能、文档表单、零样本定位、无障碍描述)与五项限制(文本输出需解析、颜色可能丢失、小目标受限、任务词表有边界、速度硬件未公开),并与 base、Kosmos-2、InternVL、Llama 3.2 Vision 做了选型对比。落地时需注意坐标解析容错、Microsoft Research License 商用核对、微调需自取原始代码,以及分辨率对精度与延迟的权衡。
视觉AI的工程实践中,一个反复出现的痛点是:图像描述用一个模型、目标检测换另一个、区域定位又要再部署一套。每增加一项能力,就多一份推理延迟、多一层服务编排的复杂度。Florence-2-Large 试图用「统一架构 + 提示词切换任务」的思路解决这个问题。本文基于 AImodels.fyi 发布的入门指南,梳理这个模型的能力边界、适用场景与落地注意事项。
统一架构意味着什么
Florence-2-Large 是一个视觉基础模型,采用序列到序列(sequence-to-sequence)的 Transformer 结构。它接收图像与文本提示两类输入,输出统一为文本形式的任务结果。据原作者介绍,模型训练于 FLD-5B 数据集,该数据集覆盖 1.26 亿张图像、包含 54 亿条视觉标注。
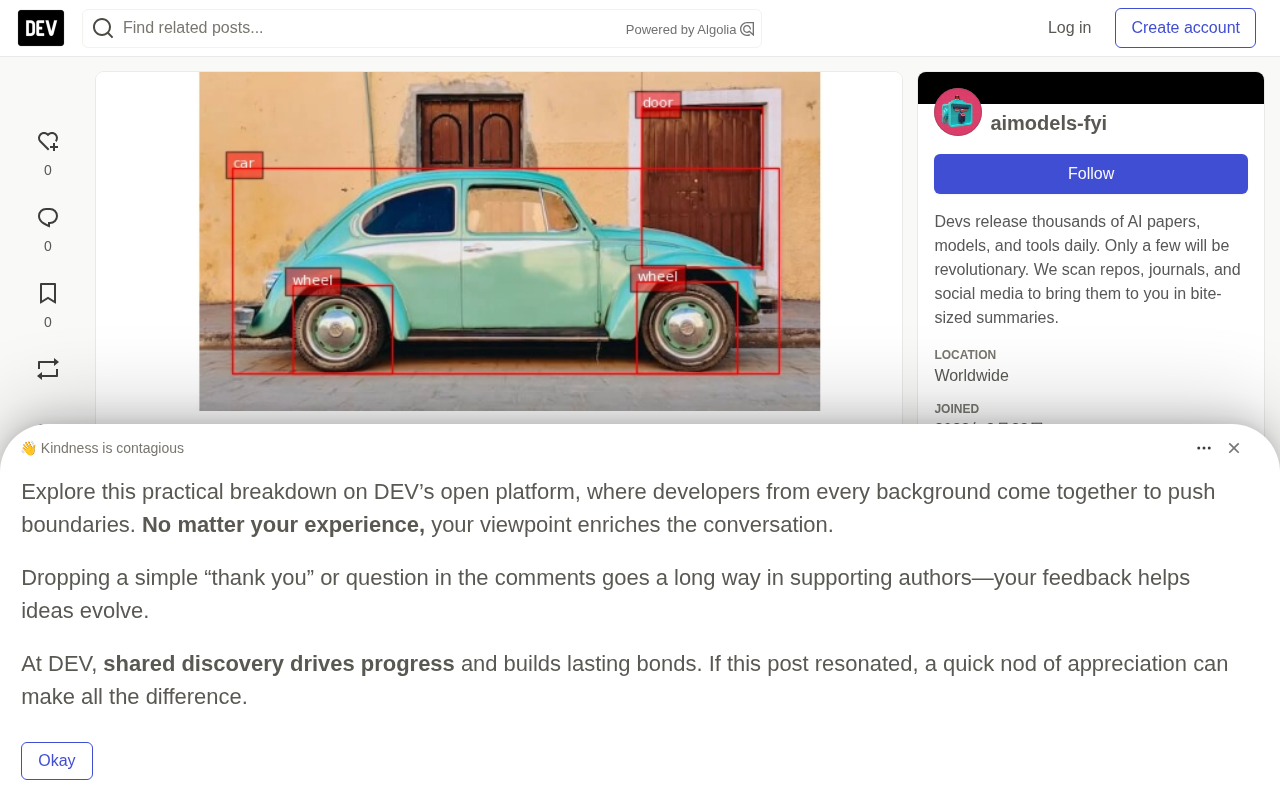
这个设计的核心价值不在于单项任务做到极致,而在于「一次部署、多任务复用」。图像描述、目标检测、区域描述、视觉定位、分割提示生成等任务,都通过切换 task_input 参数来调用,无需为每个任务单独微调模型。对于需要串联多种视觉能力的流水线来说,这直接省掉了模型切换带来的延迟和工程复杂度。
序列到序列(sequence-to-sequence)架构最初用于机器翻译,其特点是输入一个序列、输出另一个序列,两端长度可以不同。Florence-2 把图像经过视觉编码器转换成的特征序列,与文本提示的词元序列拼接后送入编码器,再由解码器自回归地生成文本答案。这种设计的灵活性在于:同一套权重可以处理任意「输入→文本」的映射,任务差异完全由提示词前缀(如 <CAPTION>、<OD>)表达,而不需要改动网络结构或增加任务头。代价是输出必须被「文本化」,坐标、多边形等结构化结果都要序列化成字符串再解析,这也是后文提到解析成本的根本原因。
四类值得优先考虑的场景
商品智能的多任务流水线。 电商平台摄入一张商品图后,可以用不同提示词分别生成上架描述、检测 SKU 或瑕疵、定位价签区域,全部在一次推理框架内完成。相比把多个专用模型串起来,统一架构减少了服务编排开销。
文档与表单理解。 保险理赔、房贷材料审核、合同分析这类场景需要同时识别文字区域、检测表单字段、并把自然语言引用落到具体图像区域。Florence-2-Large 的优势在于用提示词驱动结构化元素提取,而不必依赖规则式的抽取逻辑。
零样本视觉定位。 模型支持用自然语言指定目标并返回边界框,比如「找出图中那辆红色自行车」。这意味着构建交互式检索工具时,不必先收集标注数据再训练专用检测器。
大规模无障碍描述生成。 面向视障用户的平台或需要归档海量图像的机构,可以用它批量生成自然语言描述。相比小模型,大杯版本在处理包含多个对象与动作的复杂场景时,描述的信息量更充分。
必须知道的五个限制
第一,输出是文本格式。模型返回的边界框坐标、分割提示都是字符串,下游系统使用前必须做解析转换。这会引入额外延迟,且当文本格式在边界情况下不一致时,解析逻辑需要容错处理。
第二,颜色信息可能被丢弃。模型 schema 中标注了「Grayscale input image」,暗示输入可能被转为灰度处理。如果你的任务依赖颜色判别——比如识别红色异常、按颜色区分物体——这个模型并不合适,除非做预处理把颜色编码进灰度空间,或搭配一个颜色感知模型。
第三,小目标与细粒度任务表现受限。工业质检中的微小缺陷、小号印刷文字、毫米级元件识别,可能出现漏检或描述含糊。这类场景更适合用高分辨率特写数据训练过的专用检测或 OCR 模型。
第四,任务词表有边界。模型的能力范围受限于 FLD-5B 标注阶段训练过的提示词类型。高度垂直的新任务——比如制造业罕见故障模式检测、卫星图像地质构造识别——如果视觉模式与训练数据差异过大,可能产生幻觉或泛泛而谈的描述。
第五,速度与硬件要求未公开。作为大型视觉语言模型,推理通常需要 GPU。大规模批量推理或实时视频流这类对延迟敏感的应用,可能比小模型或推理优化版本更容易触到性能瓶颈。
理解「灰度输入」这一限制,需要区分两件事:模型架构本身并不排斥彩色图像,视觉编码器通常接受三通道输入;但若预处理管线在缩放、归一化时把图像转为单通道,颜色信息在进入模型前就已丢失。Florence-2 的训练数据以图文对和标注为主,颜色并非其监督信号的重点,因此即使输入保留彩色,模型也未必稳定地利用色相做判断。实践中可用两种方式验证:用同一物体换色后对比输出描述是否变化;或把颜色作为 text_input 提示的一部分显式给出,观察模型能否据此定位。若两次结果无差异,说明颜色通道对该任务不可依赖。
和同类模型怎么选
与同架构的 florence-2-base 相比,大杯版本参数量更多,复杂场景与细粒度任务的准确率更高;base 版本推理快 15%–20%、内存占用更低。吞吐优先选 base,质量优先且算力预算允许时选 large。
与 kosmos-2 相比,后者在设计上就以视觉-语言对齐为核心,开放式推理和空间关系问答(如「人物左边是什么」)更强;Florence-2-Large 在批量标注任务上更高效,且支持更结构化的输出格式。
与 internvl3_5-30b 相比,后者语言理解与推理能力更广,但更慢、更吃算力。需要细粒度场景理解或复杂图像问答时选 InternVL;高吞吐标注流水线和单任务视觉负载选 Florence-2-Large。
与 ollama-llama3.2-vision-11b 相比,后者偏对话式、通用图像问答;如果你在做聊天机器人界面,选 Llama 3.2 Vision,如果要做结构化任务执行与检测定位等细粒度子任务,Florence-2-Large 更合适。
至于 realistic-vision-v4.0,它是图像生成模型,与本模型功能相反、互为补充:一个理解图像,一个生成图像。
输入输出与上手代码
Replicate 上的实现接收三类输入:URI 格式的图像;task_input 枚举(默认 Caption),指定要执行的视觉子任务;可选的 text_input 自然语言提示,用于引导任务执行,例如检测时指定目标类别。输出包含 text(文本形式的任务结果)与可选的 img(在输入图上渲染边界框或分割掩码的可视化图)。模型文件为 Hugging Face 格式,通过 Cog 在 Replicate 基础设施上运行。
最简调用只需指定任务为 Caption:
import replicate

client = replicate.Client(api_token="your-api-token")

output = client.run(
    "lucataco/florence-2-large:da53547e17d45b9cfb48174b2f18af8b83ca020fa76db62136bf9c6616762595",
    input={
        "image": "https://example.com/car.jpg",
        "task_input": "Caption",
        "text_input": None
    }
)
print(output)

`task_input` 的取值并非任意字符串,而是模型训练时定义的**任务提示词词表**中的固定枚举,常见的有 `<CAPTION>`、`<DETAILED_CAPTION>`、`<MORE_DETAILED_CAPTION>`、`<OD>`(目标检测)、`<DENSE_REGION_CAPTION>`(区域描述)、`<REGION_PROPOSAL>`、`<CAPTION_TO_PHRASE_GROUNDING>`(视觉定位)、`<REFERRING_EXPRESSION_SEGMENTATION>` 与 `<OCR_WITH_REGION>` 等。Replicate 封装把这些标记映射为 Caption、ObjectDetection、Grounding 等可读名称,但底层仍是这些特殊词元。选错或自造任务名不会报错,模型只会退化为泛泛的描述输出。因此接入前应查阅原始仓库中的任务列表,并把名称映射固化在配置里。
# 返回: {"text": "A green car parked in front of a yellow building.", "img": "https://..."}
切换到目标检测时,把 task_input 改为 ObjectDetection,并在 text_input 中列出关心的类别,例如 "car, person, traffic sign"。做视觉定位时,task_input 设为 Grounding,text_input 写自然语言目标,例如 "the red bicycle"。
落地前的几个实务判断
坐标解析是绕不开的一步。官方 FAQ 明确表示,文本输出通常不能直接用于生产,需要把坐标字符串解析回数组、多边形坐标或 numpy 掩码,且要为格式异常的边缘情况准备错误处理。
商用授权需自行核对。模型采用 Microsoft Research License,研究类许可往往对商业产品分发有限制,计划商用前应仔细阅读 Hugging Face 仓库中的具体条款。
微调不在托管服务范围内。Replicate 上的模型只提供推理,若要针对自有数据做领域适配,需要从 Hugging Face 或研究仓库拉取原始 Florence-2 代码,在本地或自有算力上训练。
图像分辨率的影响缺乏官方文档。更高分辨率可能改善小目标检测,但会增加推理延迟,建议用实际业务图像尺寸做延迟与精度的权衡测试。
最后提醒一句:Replicate 上的部署版本停留在较早时间点,托管推理由 Replicate 独立维护,但原始 Florence-2 研究代码的维护状态需要在微软的 Hugging Face 仓库确认。
Microsoft Research License 属于研究用途许可,通常允许学术与非商业使用,但对商业分发、托管服务、再许可设有附加条件,部分版本还要求衍生模型同样开源或需单独申请商用授权。判断能否商用不能只看「是否免费下载」,而要逐条核对仓库中的许可文本,重点关注:是否允许用于创收产品、是否允许作为 API 对外提供、是否要求署名或回馈改进。若产品处于早期验证阶段,可先用研究许可做原型;进入商业化前,建议法务介入评估,或考虑以商用友好的替代模型兜底,避免上线后被迫迁移。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。