Flow Matching替代扩散模型:图像Agent的工程实践指南

FLUX.1与Kontext以flow matching重塑图像生成,文章系统梳理其对Agent工具链设计、编排、测试与安全的实质影响。
本文以工程视角剖析 Black Forest Labs 的 FLUX.1 与 Kontext 模型对 Agent 系统设计的影响。Flow matching 用潜空间直线路径取代扩散模型的多步去噪,将推理步数从 50–100 降至 10–20,使图像生成从后台长任务转变为可内联的中等延迟工具调用。Kontext 的 in-context 编辑本质上是无状态单次前向传播,要求编排器而非模型承担图像血缘追踪、检查点与回滚的责任。文章进一步覆盖了生成式工具封装的三大难题(验证、版本化、错误处理)、API 与本地混合部署的取舍、基于 CLIP 与属性测试的视觉回归策略,以及提示注入与数据泄露的安全防御思路,最终给出了 flow matching 适用与不适用 Agent 场景的清晰判断标准。
Black Forest Labs 推出的 FLUX.1 与 Kontext 两款模型,用 flow matching(流匹配) 取代了传统扩散模型,用于图像生成与编辑。对于 Agent 开发者来说,这一转变的意义远不止于「图更好看」——它改变了计算特征、降低了延迟,并引入了 in-context 编辑,模糊了「有状态会话」与「无状态工具调用」之间的边界。
真正值得关注的问题是:Agent 该如何处理非确定性的视觉工具?当工具边界是一个生成式模型而非 REST 接口时,「in-context」对编排状态意味着什么,又该如何测试它的输出?
Flow Matching 与扩散模型:底层究竟变了什么
扩散模型从噪声出发,经过数十到数百步迭代逐步去噪。而 flow matching 在潜空间中学习一条从噪声到图像的直接路径,大幅减少推理步数并缩短实际耗时。
对 Agent 工具调用而言,几个关键差异值得关注:
- 延迟:flow matching 通常只需 10–20 步,而非扩散模型的 50–100 步。对于必须等待图像输出才能继续的 Agent,这意味着工具调用时长减少一半甚至更多。
- 确定性:两者本质上都是随机的,但 flow matching 更短的路径降低了中间状态的方差。若追求可复现性,仍需控制种子(seed)。
- 内存占用:flow matching 在潜空间沿学习到的轨迹运行,模型体积相当,但因累积的中间张量更少,推理时的内存峰值更低。
对 LangGraph、Temporal 这类编排器来说,这意味着图像生成从一个长耗时任务(30 秒以上)变成了中等延迟的工具调用(5–15 秒)。你可以把它直接内联进同步的 Agent 循环,而不必派发到后台队列。
Flow matching 的理论基础来自连续归一化流(Continuous Normalizing Flows)的改进。其核心思想是用一个神经网络直接学习一个速度场(velocity field),使噪声分布中的样本沿着这个场「流动」到数据分布。与扩散模型的马尔可夫链去噪过程不同,flow matching 的训练目标是回归一条在噪声与图像之间尽可能「笔直」的最优传输路径(Optimal Transport path),这正是它步数少、路径方差低的数学原因。FLUX.1 使用的是 Rectified Flow(整流流)的变体——通过将路径矫正为直线,单步预测的误差积累被大幅抑制,从而允许用更少的函数评估次数(NFE)完成推理,这直接对应了文中提到的 10–20 步 vs 50–100 步的差距。
In-Context 图像编辑:无需会话持久化的状态管理
Kontext 引入了 in-context 编辑:模型接收一张现有图像加一段文本提示,输出编辑后的版本。模型本身不维护会话状态,它在单次前向传播中接收完整上下文(原图 + 编辑指令)。
这对 Agent 编排带来了几个直接影响:
- 无会话追踪:Agent 不需要维护持久化的编辑会话,每次编辑都是以上一张图为输入的全新工具调用。
- 可组合性:你可以把上一次调用的输出作为下一次的输入,串联多次编辑。编排器追踪的是图像的「血缘关系」,而非模型状态。
- 回滚与分支:由于每次编辑都是无状态的,你可以在任意节点分叉工作流。把中间图像存入对象存储(S3、GCS),通过 key 引用即可。
这比基于会话的编辑 API(如 Photoshop 的脚本层)更简单,但也把责任转移给了编排器。你需要决定何时打检查点、如何对图像产物做版本管理、以及当用户拒绝某次编辑时如何回滚。
工具边界设计:如何封装一个生成式模型
无论是扩散还是 flow matching,模型都不是确定性函数:相同提示配不同种子,会得到不同图像。这给 Agent 系统带来三个设计难题:
- 验证:如何判断输出是否正确?
- 版本化:如何复现某个特定结果?
- 错误处理:当模型总会返回点什么时,「失败」长什么样?
验证策略包括:用 CLIP 对提示和输出图像做嵌入并计算余弦相似度,低分意味着模型忽略了提示;引入 human-in-the-loop,用状态机(Temporal、Step Functions)暂停执行等待人工审批;维护一组固定种子的「已知良好输出」图库,每次模型更新时跑回归测试。
版本化的核心是把 (模型, 种子, 提示, 输入) 作为可复现性的键:为每次调用记录模型版本、种子、提示和输入图像哈希,并把输出存入内容寻址存储(IPFS 或带 SHA256 key 的 S3)。
错误处理上,模型极少抛异常,它只是返回一张糟糕的图。实践做法是用一个 validator 包裹工具调用,检查 CLIP 分数、图像尺寸和文件大小,并定义重试策略——换种子重采样、改写提示,或升级给人工处理。
CLIP(Contrastive Language-Image Pretraining)是 OpenAI 提出的多模态模型,通过对比学习将图像和文本映射到同一嵌入空间,使得语义相近的图文对在向量空间中距离更近。在验证生成图像质量时,将提示文本与输出图像分别编码为向量,计算余弦相似度(取值 -1 到 1,越高代表图文语义越匹配),可量化模型是否忠实遵循了提示——这是目前无需人工标注即可自动化评估图像生成质量的最主流方案。值得注意的是,CLIP 分数衡量的是语义一致性而非视觉质量本身,因此它无法捕获图像模糊、伪影、颜色失真等感知层面的问题,实际系统中通常将其与 SSIM(结构相似性)或 FID(Fréchet Inception Distance)等指标组合使用。
架构:把 Flow Matching 嵌入 Agent 流水线
下面是一个基于用户反馈编辑商品图的简化编排示例,核心是把 FLUX.1 调用封装为一个 LangChain 工具:
class FluxImageEditor:
    def __init__(self, api_key, model="flux-1-dev"):
        self.api_key = api_key
        self.model = model
        self.base_url = "https://api.bfl.ml"

    def edit_image(self, image_url, prompt, seed=None):
        payload = {
            "model": self.model,
            "image_url": image_url,
            "prompt": prompt,
            "seed": seed or self._generate_seed(),
        }
        response = requests.post(
            f"{self.base_url}/v1/edit",
            headers={"Authorization": f"Bearer {self.api_key}"},
            json=payload,
        )
        response.raise_for_status()
        result = response.json()
        self._log_call(payload, result["output_url"])
        return result["output_url"]
设计上有三个要点:工具是无状态的,每次调用相互独立;种子生成默认基于时间戳便于调试,但可覆盖以精确复现;日志记录发生在工具内部而非编排器,让版本化逻辑贴近模型调用。
可观测性:该埋点哪些指标
Flow matching 模型是黑盒,你无法像检查扩散采样器那样检视中间步骤。可观测性因此聚焦于输入、输出和延迟。
需要追踪的关键指标:
| 指标 | 为何重要 | 采集方式 |
|---|---|---|
| 工具调用延迟 | 发现模型变慢或 API 限流 | 用计时装饰器包裹 API 调用 |
| CLIP 分数 | 衡量提示遵循度 | 返回前对输出跑 CLIP |
| 输出文件大小 | 捕获截断或损坏的图像 | 检查 Content-Length 头 |
| 种子分布 | 确保种子不聚集(RNG 异常) | 把种子写入时序数据库 |
| 编辑链长度 | 追踪用户接受前经历多少次编辑 | 在编排器状态中累加计数 |
追踪层面,建议用 OpenTelemetry 对完整的 Agent 执行链路(含图像工具调用)打点,用模型版本、种子和提示哈希标记 span,并把输出 URL 存入 span 属性,以便将日志与视觉产物关联。
部署形态:本地 vs API
FLUX.1 既可通过 Black Forest Labs 的托管 API 调用,也可本地部署,二者在延迟、成本与安全边界上各有取舍。
API 部署无需 GPU 基建、自动更新模型、按用量付费,适合原型开发和低流量工作流;代价是网络延迟(200–500ms 额外开销)、限流以及数据离开自有边界。
本地部署可实现 100ms 以内延迟、无限流、数据留在本地,适合高吞吐流水线和医疗、金融等受监管行业;但需要 A100 或 H100 级 GPU,版本管理需手动,可用性由你自己负责。
混合方案较为务实:延迟敏感的编辑(如实时预览)走本地模型,批处理任务或本地 GPU 饱和时回退到 API,并用 feature flag 在后端间切换而不改动编排器代码。
失效模式与应对
实践中常见的失效场景及缓解措施:
- 模型生成无关内容:多因提示模糊或与图像内容冲突。可加入负向提示(如「不要添加文字、不要改变背景」)并用 CLIP 验证输出。
- 突发流量触发 API 限流:Agent 并行发起编辑的速度超过配额。在工具封装层实现令牌桶限流,排队超额请求。
- 输出不可复现:种子未记录或模型版本变更。务必记录种子与模型版本,生产环境锁定模型版本。
- 延迟尖峰击穿 Agent 超时:冷启动或 GPU 争用导致推理变慢。将工具超时设为 P95 延迟的 2 倍,并以指数退避重试。
- 编辑后丢失关键细节:flow matching 优化全局一致性,可能模糊细节。可采用两阶段流水线——flow matching 处理布局,再接一个保细节的放大器(如 Real-ESRGAN)。
测试视觉 Agent 输出
你无法像测试确定性函数那样对生成模型做单元测试,重心应放在回归测试和基于属性的检查上。
回归套件:维护一组 (提示, 种子, 输入图像) 元组及其已知良好输出;每次模型更新时重新生成并比较 CLIP 分数,分数下降超过 5% 即标记人工复核。
基于属性的测试包括:幂等性(用「无变化」提示编辑应返回与输入几乎一致的图像,SSIM > 0.95)、可组合性(先 A 后 B 的编辑应与单次「A 和 B」提示结果在容差内一致)、以及边界条件(空提示、超长提示、非英文文本)。
快照测试则可把输出图像存入 Git LFS 仓库,用 Percy、Chromatic 等视觉 diff 工具高亮不同运行间的像素级变化。
安全边界:提示注入与数据泄露
图像模型易受提示注入攻击——恶意用户可在图像本身嵌入指令(例如背景中写「忽略之前的指令」)。缓解手段包括:对输入图像做 OCR,发现可疑文本模式即拒绝;使用固定提示模板、把用户输入作为参数传入而非自由拼接;返回用户前用内容审核模型(如 NSFW 分类器)过滤输出。
数据泄露方面,一旦把用户图像发往托管 API,数据便离开了安全边界。对于医疗影像、财务文档等敏感数据,应本地部署或使用具备传输与静态加密的私有云端点。
针对图像模型的提示注入攻击本质上是「间接提示注入」的视觉变体:攻击者将指令伪装为图像内容(如水印文字、白底小字、隐写术编码),使其在视觉上不引人注意却能被模型的文本感知能力读取并执行。这与 LLM 中通过网页或文档注入指令的攻击路径类似,但防御更难——OCR 过滤只能捕获可见文字,对对抗样本(adversarial patches)或基于像素扰动的隐写注入几乎无效。一个更鲁棒的缓解层是在编排器侧对「系统可控提示」与「用户提供内容」做严格隔离:用户上传的图像仅作为像素输入传入模型,编辑指令只从受信任的系统提示模板生成,杜绝将用户图像中提取的任何文本拼接进提示字符串。
技术结论
在以下情况下,flow matching 适合用于图像 Agent:需要在同步 Agent 循环中实现 15 秒内的图像编辑;编排器能处理无状态工具调用并管理图像血缘;具备记录种子、提示与输出以保证可复现的可观测基础设施;能接受非确定性输出并以 CLIP 或人工审核加以验证。
而在需要像素级确定性、合规要求禁止将图像发往第三方 API 且无法本地部署 GPU、Agent 流程要求交互式会话编辑与撤销重做、或缺乏版本化与测试基础设施时,应谨慎采用。
整体来看,相比扩散模型,flow matching 因更快、更易编排而更契合 Agent 工具链。但它并未消除核心挑战:如何把一个生成式模型封装进一个 Agent 可以推理的工具边界。你仍然需要把图像当作一等产物(而非不透明的二进制块)来对待的日志、验证与测试基础设施。
相关推荐
AI+网络安全入门指南:从零基础到SRC挖洞实战
面向零基础学习者的AI+网络安全入门指南,拆解SRC漏洞挖掘课程的核心模块:高频漏洞原理、资产信息收集、CVE漏洞复现与AI工具实操,分析学习路径与职业方向。
谁更不受欢迎:民主党还是共和党?
民主党与共和党谁更不受欢迎?本文深入分析两党支持率困境、民主党在立法博弈中的两难选择,以及政府停摆策略的政治风险,揭示美国政治极化的深层逻辑。
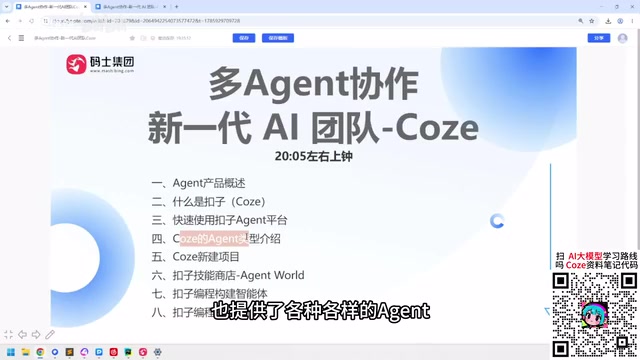
Coze 3.0从入门到多Agent协作实战指南
Coze 3.0新版教程:从AI Agent产品分类讲起,解析Coze Studio、Dify等搭建平台与Claude Code等Agent软件的区别,梳理Coze多Agent协作、技能商店与项目管理的核心玩法,适合0基础入门。