佛州女子因在AI聊天中发布威胁言论被捕引发争议
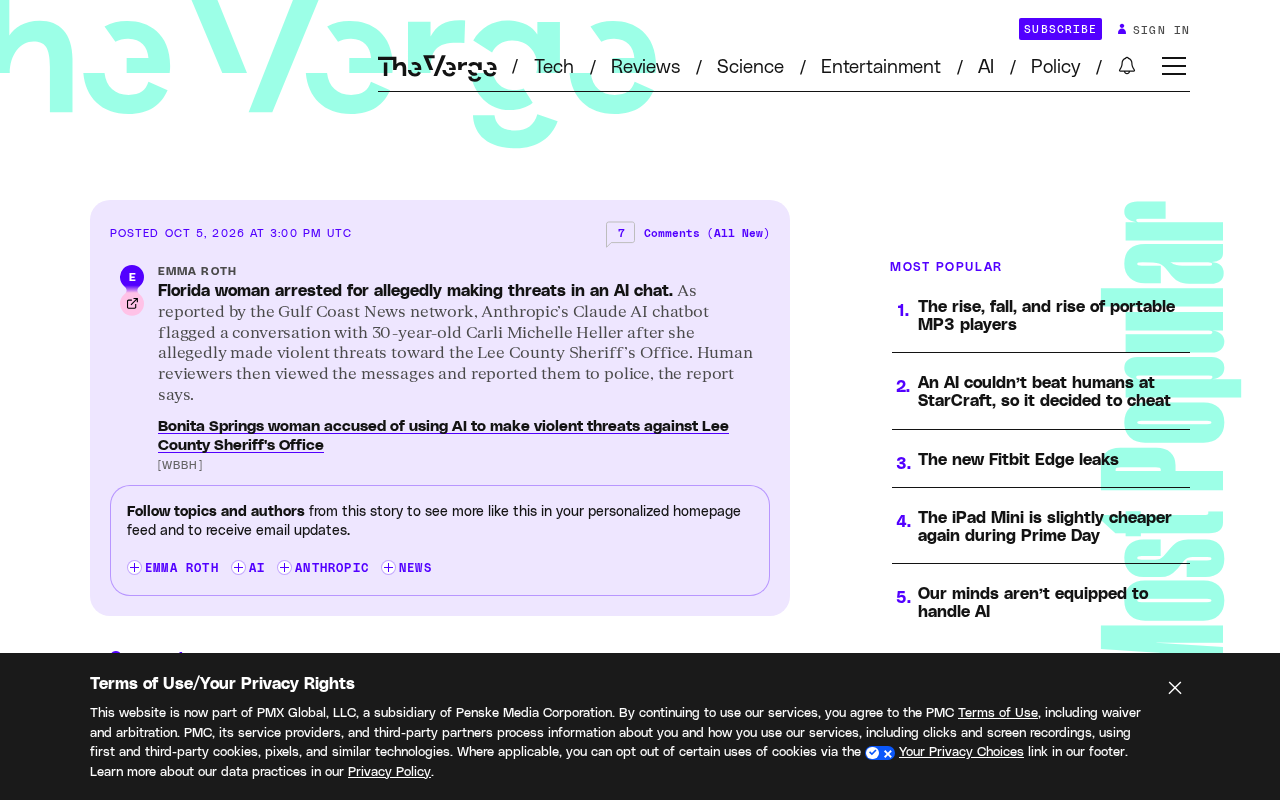
佛州女子因AI聊天记录被捕,引发AI私密性与威胁言论认定的法律争议。
美国佛罗里达州一名女子因在AI聊天机器人对话中发出威胁性言论而被警方逮捕,此案将AI对话的隐私属性与法律责任推上了争议前台。事件的核心矛盾在于:用户普遍将AI对话视为私密空间,但主流AI服务在技术上均将对话数据存储于云端服务器,平台可依服务条款读取并配合执法。与此同时,针对无感知能力的AI程序所发出的言论是否构成法律意义上的「威胁」,在意图认定和可执行性上存在显著模糊地带。案件折射出AI工具隐私承诺与实际数据处理之间的落差,提醒用户AI聊天框并非法外之地,也促使开发者重新审视隐私条款的透明度与产品设计的责任边界。
事件概述
据外媒报道,美国佛罗里达州一名女子因涉嫌在与AI聊天机器人的对话中发出威胁性言论而被警方逮捕。这一案件在技术社区引发了关于AI对话隐私、监控边界以及言论责任认定的广泛讨论。
从目前公开的信息来看,这起事件的核心争议并不在于「威胁」本身,而在于一个更深层的问题:当用户与一个AI程序进行私下对话时,这些内容是否应当被视为公开言论,又是否足以构成刑事指控的依据?
案件背后的技术与法律张力
私密对话还是可追溯记录?
大多数用户在与AI聊天机器人交互时,往往下意识地将其当作一个「私人空间」——类似于自言自语或在日记本上写字。然而现实是,几乎所有主流AI服务都会在服务器端保存对话记录,部分服务条款中也明确写明可能会对内容进行审查、存储,并在特定情况下配合执法部门。
这意味着,用户眼中的「私聊」在技术实现上可能是完全可被平台方读取和保留的数据。当对话内容触及暴力威胁等红线时,平台的内容安全机制可能会自动触发警报,进而上报相关部门。
从技术架构来看,主流AI聊天服务(如ChatGPT、Claude、Gemini等)均采用云端推理模式:用户的每一条输入都会被发送至服务商的远程服务器进行处理,响应结果再返回客户端。这一架构意味着对话内容天然存储于第三方基础设施之上,而非仅留存在用户本地设备。部分服务提供了「不保存历史记录」的选项,但即便如此,出于安全审计、滥用检测和模型改进等目的,服务商通常仍会在一定窗口期内保留原始日志。美国《电子通信隐私法》(ECPA)对这类存储通信的保护力度远弱于实时通话,执法部门在取得合规法律文书后,可向平台方调取相关记录。用户若想要真正意义上的本地私密对话,目前只有在本地部署开源模型(如Llama系列)这一路径能实现数据不出本机。
威胁言论的认定难题
在法律层面,威胁言论的构成通常需要考量意图、对象的具体性以及可执行性。而在人机对话的场景中,这些要素变得模糊——用户是在向一个没有真实受害者的程序倾诉,还是真的在策划某种行动?
这正是案件引发争议的焦点。批评者认为,将与AI的对话等同于对真人发出的威胁,可能过度扩大了刑事追责的范围;而支持执法的一方则强调,无论对象是谁,明确的暴力威胁内容都应当被严肃对待,尤其是在涉及公共安全的情况下。
美国联邦最高法院在2023年的「Counterman v. Colorado」案中重申了威胁性言论的认定标准:除客观上令理性人感到恐惧外,检察官还须证明发言者具有主观上的「鲁莽漠视」(reckless disregard),即意识到自身言论可能被理解为威胁仍继续为之。在人机对话场景中,这一主观要件的举证面临额外困难——对话对象是一个无法产生恐惧感的程序,发言者的主观预期与面向真人发言时存在本质差异。此外,部分法律学者援引「宣泄假设」(catharsis hypothesis),认为人们向AI倾诉激烈情绪可能本身就是一种减压行为而非真实意图表达。当然,若对话内容涉及具体目标、时间或方法,这种抗辩的说服力会大幅下降。
技术社区的讨论视角
在Hacker News上,尽管这则新闻的讨论量不大,但触及的话题极具代表性。它暴露出当前AI产品在隐私承诺与实际数据处理之间存在的落差,也让不少开发者和用户重新审视自己对AI服务的信任假设。
核心问题可以归纳为几点:
- 用户是否充分理解自己与AI的每一句对话都可能被记录和审查?
- 平台在何种阈值下应主动介入并上报内容?这个阈值由谁定义、是否透明?
- 自动化的内容监控系统如何避免误判,又如何平衡安全与隐私?
内容安全领域通常将平台的介入机制分为两类:一类是基于关键词或语义模型的自动化检测,实时扫描对话流并在触发特定规则时自动标记或上报;另一类是人工审核队列,由内容审核员复核被标记内容后决定是否采取行动。前者响应速度快但误判率较高,后者准确性更好但存在规模化瓶颈。AI聊天场景下的检测还面临一个独特挑战:大语言模型本身会生成涉及暴力、犯罪的虚构内容(如用户请求写悬疑故事),如何区分创作性表达与真实威胁,是当前内容安全技术尚未完全解决的难题。平台设定的上报阈值通常属于商业机密,缺乏外部透明度,这也是批评者质疑的核心之一。
对普通用户的启示
这起事件给所有AI工具的使用者提了一个醒:AI聊天框并非法外之地,也不是绝对私密的树洞。无论是ChatGPT这类通用助手,还是各类情感陪伴型AI,用户输入的内容本质上都是传输到第三方服务器的数据。
对于企业和开发者而言,这也凸显了在产品设计中明确告知数据处理方式的重要性。模糊的隐私条款不仅可能损害用户信任,在涉及法律责任时还可能引发更大的纠纷。
结语
随着AI对话工具深度融入日常生活,围绕其产生的法律与伦理问题只会越来越多。这起佛州女子被捕的案件虽然细节有限,却是一个值得警惕的信号——技术的便利往往伴随着我们尚未完全理解的责任与风险边界。
在AI普及的进程中,如何在公共安全、个人隐私与言论自由之间找到平衡,将是整个社会需要持续探讨的命题。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。