FreeLLMAPI:一个免费端点统一34个LLM,直连Claude Code

FreeLLMAPI将34个免费LLM层级聚合为单一OpenAI兼容端点,降低试用门槛但受限于免费层约束。
FreeLLMAPI 把 34 个免费 LLM 层级封装在一个 OpenAI 兼容端点之后,让 Claude Code、Codex 等编程助手只需修改 base URL 即可调用多个免费模型,核心价值是降低模型对比与试错的成本。项目通过聚合各家免费额度并在统一接口后做路由,把协议差异和鉴权细节留在服务端。但文档坦承免费层级固有的速率限制、功能不完整与聚合层额外延迟不会消失,额度耗尽或限流会直接影响体验。因此它适合原型验证、学习实验和轻量编程辅助,不适合生产环境或稳定性要求高的任务;请求经过第三方服务,敏感代码的数据处理也需额外评估。
为什么需要统一端点?
开发者想用Claude Code或Codex这类AI编程助手时,常被API密钥、配额和不同厂商的接口格式困扰。FreeLLMAPI的做法很直接:把34个免费LLM层级打包到一个OpenAI兼容端点后面,你只需要把Claude Code或Codex的请求指向这个端点即可。
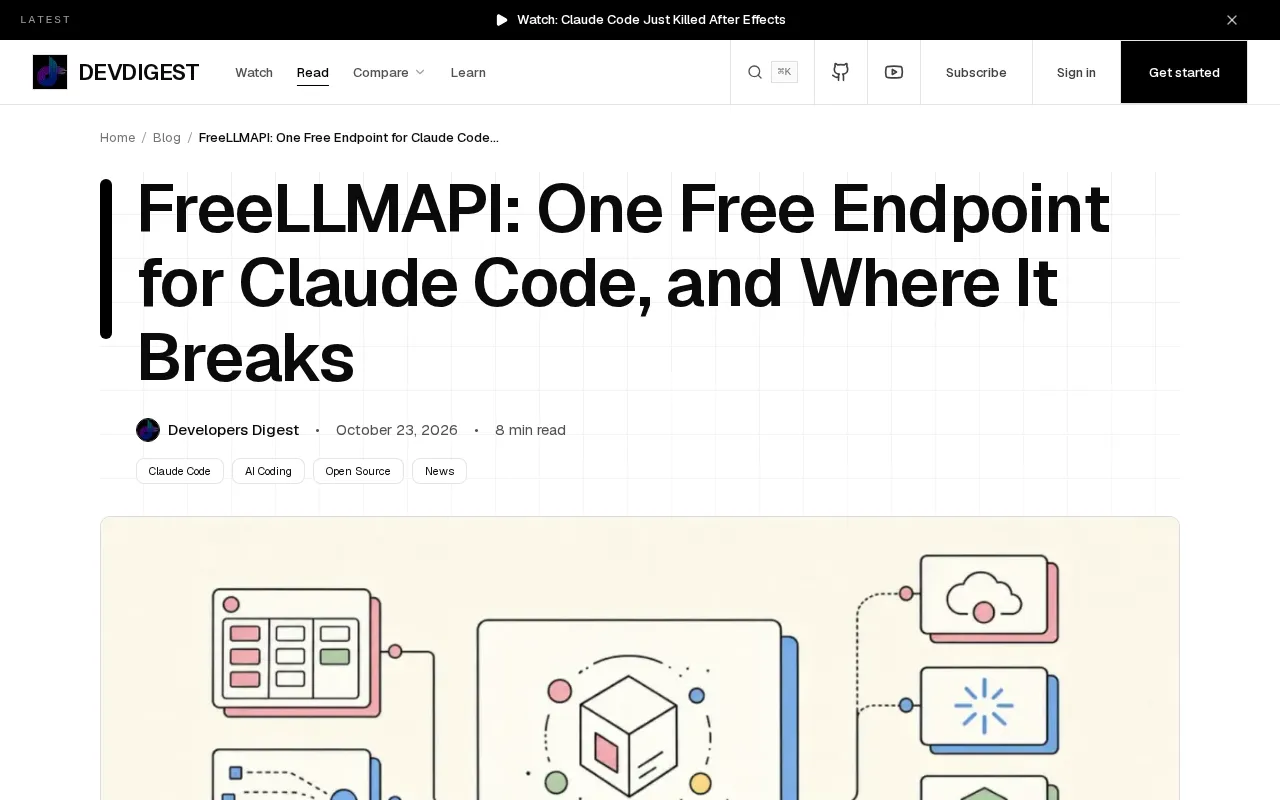
这个项目的核心价值在于降低尝试成本。不需要为每个模型单独注册、配置环境变量或写适配层,一个端点就能覆盖多个免费模型。对于想快速对比不同模型在编程任务上表现的人,这省掉了大量重复劳动。
OpenAI 兼容端点指的是遵循 OpenAI Chat Completions API 规范的 HTTP 接口,包括请求路径(如 /v1/chat/completions)、JSON 字段结构(messages、model、temperature 等)以及流式响应的 SSE 格式。由于大量客户端工具(包括 Claude Code 的兼容模式和许多开源编程助手)都内置了对这套规范的支持,只要服务端暴露同样的接口,客户端无需修改代码,仅替换 base URL 和密钥即可切换后端。这也是 FreeLLMAPI 选择该形态的根本原因——它把不同厂商各异的鉴权方式、请求参数和响应结构统一翻译成一份标准契约,从而让“一个端点对接多个模型”在工程上成为可能。
两条关键命令
FreeLLMAPI的文档强调了两条命令,它们构成了使用流程的主干。第一条用于启动本地服务并加载所有已配置的免费层级,第二条用于将Claude Code或Codex的请求代理到这个服务。
具体命令原文未逐字给出,但从项目定位可以推断:一条负责端点初始化,一条负责客户端指向。这种设计把复杂度留在服务端,客户端只需要改一个base URL。对熟悉OpenAI兼容接口的开发者来说,上手门槛很低。
它怎么把34个免费层级串起来
FreeLLMAPI并不是自己提供模型,而是聚合各家已有的免费额度。每个LLM厂商的免费层通常有速率限制、上下文长度限制或功能限制,FreeLLMAPI把这些差异封装在统一接口后面。
这意味着你在Claude Code里发出的同一个请求,可能会被路由到不同的后端模型。项目文档承认了这种做法的边界:免费层级本身的限制不会消失,只是被统一入口掩盖了。当某个后端触发限流或额度耗尽时,体验会受到影响。
速率限制是免费层级的核心约束,常见形式包括 RPM(每分钟请求数)、TPM(每分钟 token 数)以及 RPD(每日请求数),触发后通常返回 HTTP 429。不同厂商的窗口算法和计数口径并不一致,有的按账号、有的按密钥,有的对输入输出 token 分别计数。聚合层需要在多个后端之间做路由与失败重试,这实际上是在做一种简化的负载均衡与限流规避:当某个层级的配额耗尽,请求被转向下一个可用后端。理解这一点很关键——聚合层并不能突破任何单一厂商的限额,它只是把多个独立限额拼成一个更大的池子,池子的总容量与各后端策略强相关。
文档自己承认的局限
FreeLLMAPI的文档没有回避问题。它明确列出了几类限制:免费层级的调用频率上限、部分模型对长上下文或特定功能的支持不完整、以及聚合层本身可能引入的额外延迟。
这些限制决定了它适合什么场景。原型验证、学习实验、轻量级编程辅助是合理用途;生产环境或对稳定性有要求的任务,仍然需要付费API或自建推理。把免费聚合端点当成正式基础设施,会在额度耗尽或限流时付出代价。
聚合层引入的额外延迟主要来自三个方面:请求需要先经过本地或远程代理进程做协议转换与路由决策;跨厂商调用意味着网络路径更长,尤其当后端分布在不同的云区域时;失败重试机制在某个后端限流时会追加一次甚至多次往返。对于编程助手这类交互式场景,首 token 延迟(TTFT)尤其影响体验,因为用户在等待补全时对卡顿非常敏感。此外,流式响应经过代理转发时若缓冲策略不当,还会把本应逐字吐出的输出攒成整块返回,进一步放大体感延迟。评估这类聚合工具时,除了看支持多少模型,更应实测其在实际网络下的延迟分布。
对AI编程工具生态的意义
Claude Code和Codex这类工具的价值在于把模型能力嵌入开发流程,但它们默认绑定特定厂商。FreeLLMAPI代表了一种反向趋势:让客户端与模型解耦,用兼容层把选择权还给开发者。
这种解耦有实际好处。团队可以在不改变工作流的情况下切换后端模型,个人开发者可以用零成本试错。代价是可靠性和功能完整性需要自己权衡。项目文档的坦诚反而增加了可信度——它没有承诺免费聚合能替代付费服务。
使用建议
如果你打算尝试FreeLLMAPI,先明确用途。做模型对比或学习实验,它是个高效入口;跑日常开发任务,注意监控限流和额度消耗;用于团队协作或生产流程,建议保留付费API作为兜底。
另外,聚合多个免费层级意味着你的请求会经过第三方服务,敏感代码或数据的处理需要额外评估。免费额度的可持续性也不由你控制,某个层级的政策变化可能直接影响可用性。
FreeLLMAPI的定位是降低门槛的工具,不是基础设施替代品。理解它在哪里会断,比记住它支持多少模型更重要。
请求经过第三方服务带来的风险需要具体化:代码片段、文件路径、注释中的业务逻辑乃至密钥都可能出现在发往聚合端点的请求体中,而聚合方及其上游厂商的日志留存、数据使用政策并不受你控制。对于使用免费层级的服务,部分厂商会明确保留将请求数据用于改进模型的权利。因此在接入前应确认:聚合服务是否自行记录请求内容、其转发的上游是否启用训练用途、以及是否有本地部署或自建代理的选项。涉及专有算法或客户数据的场景,更稳妥的做法是仅在脱敏后的代码或示例项目上使用此类工具。
相关推荐

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。

Arsaze:把Cursor的Tab补全带到视频剪辑
Arsaze是一款AI原生视频编辑器,把Cursor的Tab补全交互带入视频剪辑:剪一次按Tab即可重复风格,还能删除转录文字来裁剪片段。本文解析其工作流、账户限制与评测结论。