FreeToken:在桌面运行大规模模型的本地推理引擎

FreeToken 用 Python 把数据中心级模型服务调度搬到桌面,让超大模型在本地跑得动。
FlashML-org/FreeToken 是一个用 Python 实现的开源项目,目标是把数据中心规模的模型服务能力下沉到个人电脑,目前已获超过 15000 星、1500 多次 fork。它的核心思路不是简单封装推理框架,而是引入服务化调度:通过细粒度显存管理和多请求批处理,让参数超出单卡显存的大模型在桌面硬件上仍能保持可用吞吐。文章分析了它在显存瓶颈、并发队列上的应对方式,指出其最适合需要本地运行超大模型或把模型作为共享服务的开发者与团队,同时提醒项目公开信息有限、缺少模型支持列表与性能基准,上手前需自行验证兼容性并评估维护成本。
为什么本地推理需要新的答案
大模型能力突飞猛进,但部署门槛并没有同步下降。云端API虽然便捷,却意味着持续成本、数据外流和网络依赖。不少开发者和团队希望把模型跑在自己的机器上,可现实是:显存不够、吞吐太低、并发一高就排队。GitHub 上的 FlashML-org/FreeToken 试图解决这一矛盾——它的目标是把数据中心级别的模型服务能力搬到桌面。项目用 Python 实现,目前已获得超过 15000 颗星,今日新增 232 星,说明本地推理的需求正被广泛关注。
FreeToken 的定位不是又一个推理框架的“封装”,而是面向“大规模模型在本地高效运行”这一具体场景。它想回答的问题是:当模型参数远超单卡显存时,桌面级硬件能否仍然提供可用的响应速度?
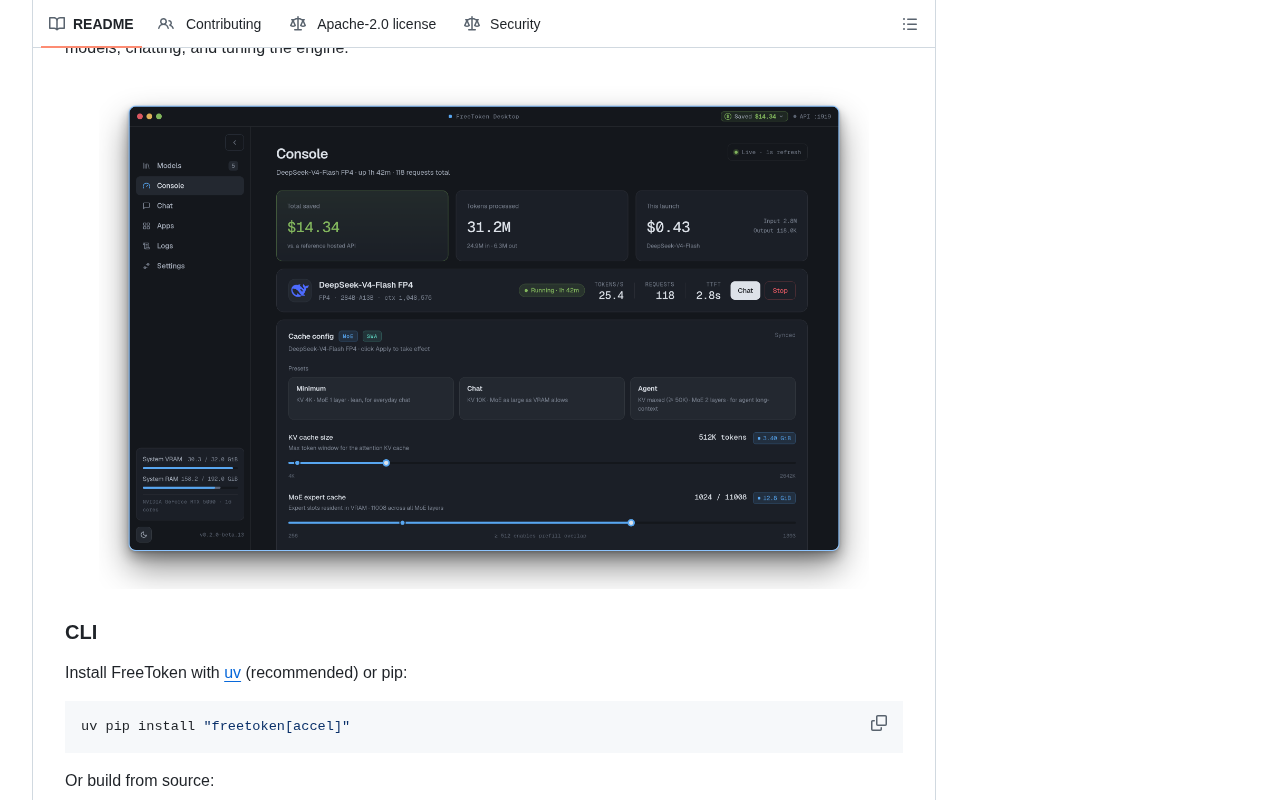
核心思路:把服务端的调度搬进个人电脑
从描述看,FreeToken 强调“datacenter-scale model serving”——数据中心规模的模型服务。这通常意味着几件事:对超大模型的加载与分片管理、对请求的批处理调度、对有限显存的精细利用。传统做法是直接用推理框架加载模型,单请求、单卡、一次性占满显存;FreeToken 则引入服务化思维,让桌面环境也能像服务器那样管理模型生命周期和请求队列。
面向“跑得动”而非“跑得全”
高星项目的价值往往在于取舍。FreeToken 没有宣称支持所有模型或所有硬件,而是聚焦于让“massive models”在本地可用。对个人开发者而言,最实际的痛点不是跑一个 7B 模型,而是想尝试更大的模型却受限于显存。FreeToken 的方向是让这类尝试变得可行,即便速度不是最优,也能先跑起来。
本地推理的现实挑战与 FreeToken 的应对
桌面环境与数据中心的最大差别在于资源的不稳定:显存小、内存带宽低、没有专用加速卡集群。FreeToken 要解决的正是这些约束下的效率问题。
显存与模型规模的矛盾
大模型无法完整放入单张消费级显卡是常态。FreeToken 的处理方式属于“服务化”路线:通过更细粒度的内存管理和请求调度,在有限硬件上维持可接受的吞吐。原文没有披露具体技术细节,但从“fast and efficiently”的表述看,它强调的是综合效率,而不是单纯的低延迟或高吞吐。
大模型推理的显存占用大致由三部分构成:模型权重、KV Cache 和中间激活值。以 FP16 精度为例,每 10 亿参数约需 2GB 显存,一个 70B 模型仅权重就要约 140GB,远超单张消费级显卡的 24GB 上限。业界常见的应对手段包括量化(如 4-bit 将权重压缩至约四分之一)、CPU-GPU 分层卸载(把部分层留在内存中按需换入)以及张量并行分片。FreeToken 所强调的“细粒度内存管理”大概率涉及这类技术的组合,其本质是在显存容量、内存带宽与响应延迟之间做动态权衡。
并发与队列
本地使用往往被忽略的一点是并发。多个请求同时到达时,简单推理框架会串行处理,导致等待时间叠加。FreeToken 引入服务端的批处理思路,把多个请求合并调度,这在桌面场景下能显著提升资源利用率。对于把本地模型作为个人助理或小团队共享服务的用户,这一能力比单次推理速度更有价值。
批处理(batching)是模型服务提升吞吐的核心手段:把多个独立请求拼成一个批次同时送入模型计算,从而摊薄权重加载和 GPU 空闲的开销。连续批处理(continuous batching)进一步允许请求在生成过程中动态加入或退出批次,避免短请求被长请求拖住。与之配套的通常还有分页式 KV Cache 管理,把每个请求的缓存切成固定大小的块按需分配,减少显存碎片。这些机制原本是 vLLM、TGI 等数据中心推理框架的标配,FreeToken 的看点在于把它们适配到显存更紧张、请求模式更随机的桌面环境。
谁适合用 FreeToken
项目的 15084 星和 1532 次 fork 说明它已经吸引了一批实际使用者。从场景看,以下几类人最可能受益:
- 希望在本地运行超出显存容量模型的研究者和开发者;
- 需要把模型作为本地服务、供多个应用调用的个人用户;
- 对数据隐私敏感、不愿将请求发送到云端的团队;
- 想学习模型服务调度机制、以 Python 为技术栈的工程师。
反过来,如果只是偶尔跑小模型,或者追求开箱即用的图形界面,FreeToken 未必是最省事的选择——它更偏向有部署经验的用户。
开源生态中的位置
FreeToken 进入的是一个竞争激烈的领域:本地推理已有多个成熟项目。它的差异化在于强调“数据中心规模”的服务能力下沉到桌面。这个定位切中了一个真实缺口——多数工具解决的是“能不能跑”,FreeToken 试图解决“能不能像服务一样跑”。
Python 作为实现语言降低了二次开发门槛,也让项目更容易被集成到现有工具链。超过 1500 次 fork 表明社区不只是围观,还在基于它做修改和扩展。
本地推理领域已有若干代表性项目:llama.cpp 以 C++ 实现和 GGUF 量化格式著称,主打 CPU 与低配硬件;Ollama 在其上提供开箱即用的模型管理与命令行体验;vLLM 和 SGLang 则专注服务端的超高吞吐与连续批处理。FreeToken 的差异点在于用 Python 实现并把服务端调度能力引入桌面,这使其更易被集成进 Python 工具链,但 Python 在底层性能上通常需要借助 CUDA 扩展或现有推理后端来弥补。理解这一生态位,有助于判断它适合作为独立服务还是上层编排工具。
需要注意的地方
高星不等于成熟。FreeToken 的原始描述较短,没有给出支持的模型列表、硬件要求和性能基准。对于准备上手的用户,这意味着需要自行验证兼容性。另外,“数据中心规模”在桌面上的实际表现取决于硬件配置,项目宣称的“fast”是相对概念,不宜直接套用到所有设备。
本地推理的另一个隐性成本是维护:模型更新、依赖冲突、驱动适配都需要投入精力。FreeToken 能降低运行门槛,但无法消除这些工程负担。
小结
FreeToken 的价值主张清晰:把服务端的模型调度能力带到个人电脑,让大规模模型在本地变得可用。15000 多颗星说明这一方向有真实需求。对于愿意折腾、希望掌控模型运行环境的开发者,它提供了一个值得尝试的选项;而对于追求零配置的用户,仍需评估自身硬件和维护成本。本地推理的普及,正需要这类把“跑得动”做扎实的项目。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。