复古IBM打孔卡启发:开源DUMEdb如何解决10万Token上下文重放难题

DUMEdb用不到220 Token的唤醒握手替代十万级上下文重放,为智能体提供确定性记忆。
文章介绍开发者 MadBradSmith 在 Reddit 分享的记忆引擎 DUMEdb(确定性单元记录内存引擎),针对长时智能体的「会话失忆症」:标准框架靠重放 8 万至 12 万 Token 聊天记录恢复上下文,成本高、速度慢,且在上下文窗口约 75% 阈值后易产生幻觉。DUMEdb 借用 1959 年 IBM 1401 打孔卡会计思想,以不可变状态记录替代历史重放。其核心机制包括:cabinet_wake 零轮次唤醒握手,用暗语换取状态回执,消耗不到 220 Token 并保留 99.8% 干净上下文跑道;基于内存映射 LMDB 的确定性引擎,实现亚微秒零拷贝读取;审计 transcript.jsonl 的磁盘里程计,在自动压缩致失忆前触发干净交接;原生 MCP 支持,可接入 Claude Desktop、Cursor 等。作者认为该思路对长期运行、频繁重启的智能体可能优于单纯扩大上下文窗口,但方案尚处早期,需更多验证。
当AI智能体患上「会话失忆症」
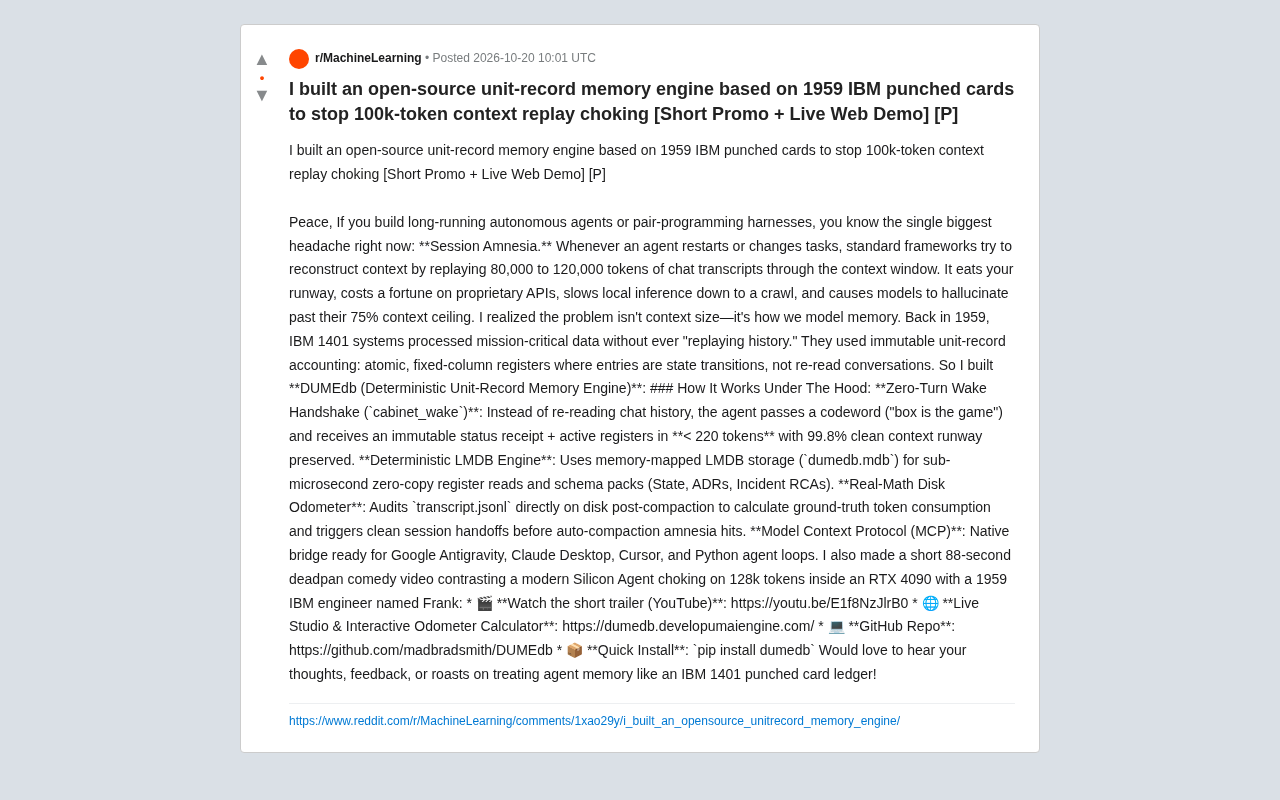
如果你构建过长时间运行的自主智能体或结对编程工具,一定对会话失忆症不陌生。每当智能体重启或切换任务,标准框架会试图通过重放8万到12万Token的聊天记录来重建上下文。这不仅消耗大量预算、拖慢本地推理速度,还导致模型在上下文窗口75%的阈值后开始产生幻觉。
一位开发者在Reddit上分享了他的解决方案:DUMEdb(Deterministic Unit-Record Memory Engine,确定性单元记录内存引擎)。有趣的是,这个引擎的灵感来自1959年的IBM 1401打孔卡系统——在那个年代,关键任务数据处理从不「重放历史」,而是依赖不可变的单元记录会计:原子化的固定列寄存器,记录的是状态转移,而非重读对话。
会话失忆症并非严格的学术术语,而是对长时运行智能体在一类典型失效模式的形象描述:当对话历史被截断、压缩或超出模型上下文窗口时,智能体丢失此前积累的任务状态、约束条件和已确认事实,从而重复提问、前后矛盾或凭空编造细节。其根源在于主流智能体框架把「记忆」等同于「聊天记录的完整重放」,而上下文窗口是有限且昂贵的资源。业界常用「上下文腐烂」(context rot)描述类似现象:随着输入变长,模型对中段信息的召回率下降,输出质量在窗口接近饱和时明显退化。因此,如何在有限窗口内保存结构化状态而非原始对话,成为长时智能体设计的核心问题之一。
DUMEdb的核心机制
零轮次唤醒握手(cabinet_wake)
传统方法重读聊天历史,而DUMEdb要求智能体传递一个暗语(例如「box is the game」),然后接收一个不可变的状态回执和活跃寄存器信息。整个过程消耗不到220个Token,就能保留99.8%的干净上下文跑道。这意味着智能体可以在极低开销下恢复精确状态,避免信息过载。
确定性LMDB引擎
引擎底层使用内存映射的LMDB存储(dumedb.mdb),实现亚微秒级的零拷贝寄存器读取,并支持模式包(State、ADRs、Incident RCAs)。这种设计确保了状态读取的确定性和高速性,适合对延迟敏感的智能体循环。
LMDB(Lightning Memory-Mapped Database)是一个以B+树组织的嵌入式键值存储库,最初由Symas为OpenLDAP开发。它的关键特性是内存映射:数据库文件通过mmap直接映射到进程地址空间,读取时无需系统调用和数据拷贝,指针直接指向页缓存,因而能实现微秒甚至亚微秒级的读取延迟。LMDB采用单写多读的MVCC并发模型,读事务不加锁且能看到一致快照,写事务串行提交,保证ACID语义。其数据文件格式与字节序在跨平台时保持稳定,适合需要确定性、可审计、低延迟的本地状态存储场景——这正是DUMEdb选择它作为底层引擎的原因。
真实数学磁盘里程计
DUMEdb直接审计磁盘上的transcript.jsonl文件,在压缩后计算真实的Token消耗,并在自动压缩导致失忆前触发干净的会话交接。这相当于给上下文使用量装了一个「里程表」,让开发者可以精确掌握消耗情况。
模型上下文协议(MCP)支持
引擎原生支持MCP桥接,可无缝接入Google Antigravity、Claude Desktop、Cursor以及Python智能体循环。这大大降低了集成门槛。
模型上下文协议(Model Context Protocol,MCP)是Anthropic于2024年底提出并开源的开放标准,用于让大模型应用以统一方式连接外部数据源与工具。它采用客户端—服务器架构:宿主应用(如Claude Desktop、Cursor)内置MCP客户端,外部能力以MCP服务器形式暴露资源(resources)、提示模板(prompts)和工具(tools),通过JSON-RPC通信。MCP的价值在于把「每个工具一套私有集成」变为可复用的标准接口,使同一份记忆或数据服务能被不同智能体前端直接调用。DUMEdb原生提供MCP桥接,意味着任何支持MCP的客户端都能把它当作记忆后端接入,而无需为每个框架单独适配。
从打孔卡到现代智能体
开发者还制作了一个88秒的冷面喜剧视频,对比现代硅基智能体在RTX 4090上被128k Token噎住,与1959年IBM工程师Frank的从容。视频和在线演示都已上线:
- 🎬 YouTube短片:https://youtu.be/E1f8NzJlrB0
- 🌐 在线工作室与交互式计算器:https://dumedb.developumaiengine.com/
- 💻 GitHub仓库:https://github.com/madbradsmith/DUMEdb
- 📦 快速安装:
pip install dumedb
IBM 1401是1959年推出的中端商用计算机,是早期大规模数据处理的主力机型之一,常与IBM 1402读卡器/打孔机配合使用。其数据处理范式与今天的对话重放形成鲜明对照:数据以固定格式的80列打孔卡为单位,每张卡是一条原子记录,作业通过读入记录、更新累加器或账目寄存器、再输出新卡来完成状态转移,系统从不「重读整段历史」来恢复状态。这种以不可变单元记录和确定性状态转移为核心的会计式设计,正是DUMEdb借用的思想原型——把智能体记忆建模为一组固定模式的寄存器与状态回执,而非可无限增长的对话日志。
为什么值得关注
当前大模型上下文窗口不断扩大,但简单增加窗口大小并非万能药。重放历史不仅成本高昂,还会引入噪声和幻觉。DUMEdb通过将内存建模为不可变的状态记录,提供了一种轻量、确定性的替代方案。尤其对于需要长期运行、频繁重启的智能体场景,这种思路可能比单纯堆上下文更有前景。
当然,该方案仍处于早期,实际效果需更多测试验证。但将1959年的会计理念应用于AI内存管理,这种跨时代的思想实验本身就值得开发者关注。
(本文基于Reddit帖子内容整理,观点仅供参考。)
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。