复刻爆款酒店大堂视频:AI Agent配方全流程拆解

用「配方」驱动 AI Agent,自动复刻爆款酒店大堂视频的完整实操流程解析。
本文梳理了一位 Reddit 用户分享的爆款"酒店大堂视频"AI 制作方案:将多步骤复杂任务封装为可复用的"配方",令 Instinct、Muse、Grok 等 Agent 平台能一键执行。流程的关键环节包括:提前剪辑好原始视频、为画面左右人物各准备全身照与面部特写两张参考图、在 Fal.ai 上调用 Minimax H3 Max 模型进行多模态条件生成,以及在提示词中用 #image1 等标签精确标注每张图的身份。由于模型无法自动理解多图间的语义关系,图片-身份的显式映射是保证人物一致性的核心。最终效果通常需要多轮迭代调整方能收敛,"配方化"的意义正在于降低每轮迭代的重复成本,支撑内容的规模化生产。
近期社交平台上流行的"酒店大堂视频"(Hotel Lobby Video)成为不少内容创作者的追逐目标。一位 Reddit 用户分享了如何将这一爆款视频的制作流程封装成一套可复用的"配方"(recipe),让 AI Agent 能够按指令自动完成。本文对其分享的完整流程进行梳理与解读,帮助你理解背后的技术逻辑与操作要点。
什么是"配方"式的 Agent 工作流
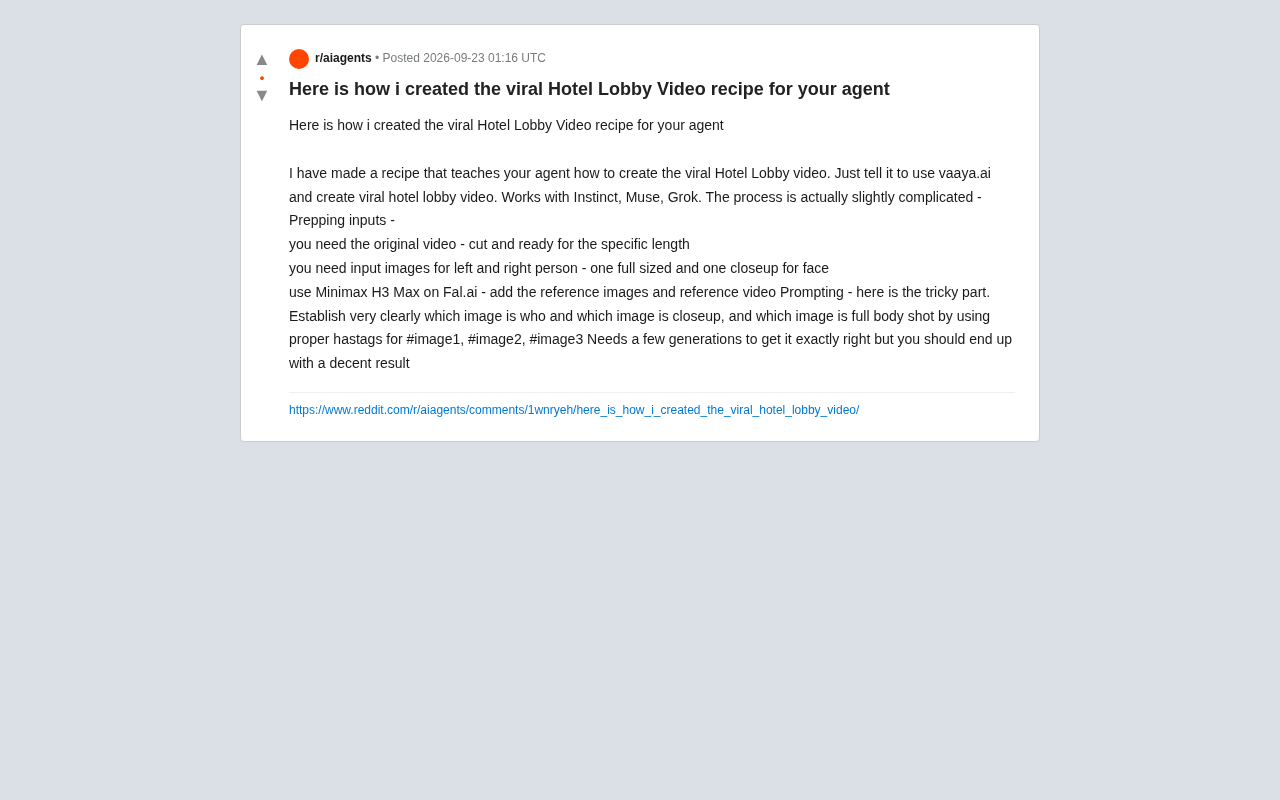
所谓"配方",本质上是把一个原本需要多步骤、多工具协作的复杂任务,抽象成一段可复用的指令模板。作者提到,只需告诉 Agent "使用 vaaya.ai 创建爆款酒店大堂视频",它就能调用相应流程完成任务。
这套配方据称兼容多个主流 Agent 平台,包括 Instinct、Muse 与 Grok。这种跨平台的兼容性说明配方本身更依赖底层的生成模型与素材准备逻辑,而非绑定某一特定 Agent 生态。对于希望批量生产同类视频的创作者来说,把繁琐的手动操作固化为一条指令,是提升效率的关键思路。
Agent 工作流(Agentic Workflow)是指由大语言模型或多模态模型驱动的自动化任务执行框架,模型不只是被动回答问题,而是能够主动规划步骤、调用外部工具(如图像生成 API、视频剪辑接口)并根据中间结果调整后续行动。"配方"(Recipe)是这一框架中的一种常见设计模式:将某个经过验证的复杂任务流程,固化为包含占位符的可参数化模板,用户只需填入特定素材(如指定人物照片),Agent 即可按模板自动串联多个工具完成完整任务。这种模式的核心优势是"把专家经验变成可规模化复用的资产",背后依赖的是 Agent 平台对工具调用(Function Calling)与多步推理(Chain-of-Thought)的支持能力。
输入素材的准备:细节决定成败
作者反复强调,这个流程"实际上略微复杂",而复杂性主要集中在前期素材准备阶段。根据其描述,需要准备以下几类输入:
- 原始视频:必须提前剪辑好,长度要与目标输出匹配。这意味着你不能直接丢一整段原片进去,而要先做好裁剪与时长控制。
- 人物参考图像:需要为画面左右两侧的人物各准备图片,且每人要有两张——一张全身照,一张面部特写。
这种"全身 + 特写"的双图策略,目的是让生成模型既能把握人物的整体形态与姿态,又能精准还原面部细节。在人物一致性(character consistency)仍是 AI 视频生成难点的当下,用多角度参考图来锚定人物特征是常见且有效的做法。
核心工具:Fal.ai 上的 Minimax H3 Max
流程的生成环节依托 Fal.ai 平台上的 Minimax H3 Max 模型。作者的操作方式是:将准备好的参考图像与参考视频一并添加到模型中,作为生成的依据。
Fal.ai 作为一个聚合多种生成模型的推理平台,让开发者与创作者可以便捷地调用各类前沿模型,而 Minimax 系列在视频生成领域已有一定口碑。选择支持"参考图像 + 参考视频"多模态输入的模型,是实现这类风格迁移与人物替换效果的技术前提。
Fal.ai 是一个面向开发者与创作者的 AI 模型推理即服务(Inference-as-a-Service)平台,其核心价值在于将来自不同机构的生成模型统一封装成标准化 API,用户无需自行部署 GPU 基础设施即可按需调用。Minimax H3 Max 是 Minimax 公司推出的视频生成模型,支持将静态参考图像与参考视频融合作为条件输入(conditioned generation),从而在保持参考视频运动轨迹的同时,将用户指定的人物外观"迁移"进去。这一技术路径本质上属于视频风格迁移与角色替换(character swapping)的结合——模型需要同时理解"运动从哪里来"与"人物长什么样"两类信息,对多模态对齐能力要求较高。正因如此,参考图像的质量与数量直接影响最终输出的人物一致性。
提示词技巧:明确标注每张图的身份
作者指出,整个流程中"最棘手的部分"是提示词(prompt)的编写。关键在于要清晰地告诉模型每张图片对应的是谁、哪张是特写、哪张是全身照。
具体做法是使用规范的标签(hashtag)来指代不同图片,例如 #image1、#image2、#image3。通过这种编号标注,模型才能正确地把"这是左侧人物的面部特写""那是右侧人物的全身照"等信息对应起来,避免张冠李戴。
这一细节揭示了当前多图输入生成任务的一个通病:模型并不会自动理解图片之间的语义关系,需要创作者用结构化的方式显式说明。清晰的图片-身份映射,是保证输出质量的核心。
迭代生成:一次成功并不现实
作者坦言,这套流程"需要几次生成才能完全调对",但最终应该能得到一个不错的结果。这也是当前 AI 视频生成的普遍现实——很少能一次到位,往往要通过多轮调整提示词、更换参考图或微调参数来逼近理想效果。
对创作者的启示是:不要期待一键出片,而应把 AI 生成视为一个反复试验、逐步收敛的过程。把流程沉淀为可复用的配方,正是为了降低每一轮迭代的成本。
AI 视频生成中需要多轮迭代,根本原因在于当前模型的输出具有随机性(由温度参数与采样策略决定),且多模态条件输入(图像 + 视频)之间的对齐误差会被逐帧放大。实践中常见的调优手段包括:调整提示词中的权重描述(如强调面部特征优先级)、更换光照或角度更佳的参考图、缩短参考视频片段以减少运动歧义,以及在平台支持时调低采样温度以换取更稳定的输出。把每一次迭代的提示词与参数变化记录下来,形成"调参日志",是将个人经验沉淀为下一版配方的有效做法。
小结
这份来自 Reddit 社区的实操分享,虽然篇幅不长,却完整勾勒出了复刻爆款 AI 视频的关键环节:结构化的素材准备、支持多模态输入的生成模型、精确的图片身份标注,以及必要的多轮迭代。它也反映出一个趋势——越来越多创作者正在把复杂的 AI 创作流程封装成"配方",交由 Agent 自动执行,从而实现内容的规模化生产。
需要提醒的是,本文流程基于单一社区来源,其中涉及的工具与模型效果请以实际测试为准。
相关推荐

Firebase AI Logic 实战:让 Gemini 返回结构化 JSON
本教程讲解如何在 Firebase AI Logic 中通过定义响应 Schema,让 Gemini 返回干净、可预测的结构化 JSON。涵盖字段定义、请求配置与解析流程,适用于 API、仪表盘、表单和自动化等场景。

问责机制也能充满乐趣:重塑自律与团队协作的新思路
问责机制常被视为压力与惩罚的代名词,但它其实可以充满乐趣。本文探讨如何通过同伴支持、进展可见化和庆祝小胜利,将问责重构为推动个人成长与团队协作的愉悦力量。

Claude Code 入门:读懂它是什么与多端用法
Anthropic 团队成员 Lydia 主讲的 Claude Code 入门分享:它不只是 CLI,而是可在终端、IDE、浏览器和桌面端运行的 AI Agent。本文梳理其本质定位、多端用法与学习路径。