服务健康但模型出错,谁该为这场事故负责?
模型质量静默下滑时,ML系统缺乏清晰的事故归属与决策机制,这是MLOps的核心权责盲区。
当机器学习系统的延迟、错误率等基础设施指标全部正常,但模型预测质量却悄然变差时,现有的运维体系往往无人"按下回滚按钮"。平台、ML、数据三个团队各自排查各自的环节,却没有人对"继续运行还是立即回滚"这一关键决策负责,形成典型的责任真空。文章围绕一个来自Reddit的真实问题展开,指出分工明确不等于责任明确,并将传统SRE中"事故指挥官"的概念迁移到ML场景,主张将决策权与调查权显式解耦。核心建议包括:由唯一指挥官持有运行/回滚决策权、以快速回滚能力换取调查从容、建立模型质量可观测性体系,以及用客观阈值而非主观判断来界定责任交接时机。
一个被忽视的运维盲区
在生产环境里,我们习惯用延迟、错误率和正常运行时间来判断一个服务是否健康。但机器学习系统有一种令人头疼的失效模式:所有基础设施指标都是绿灯,模型的预测质量却在悄悄变差。
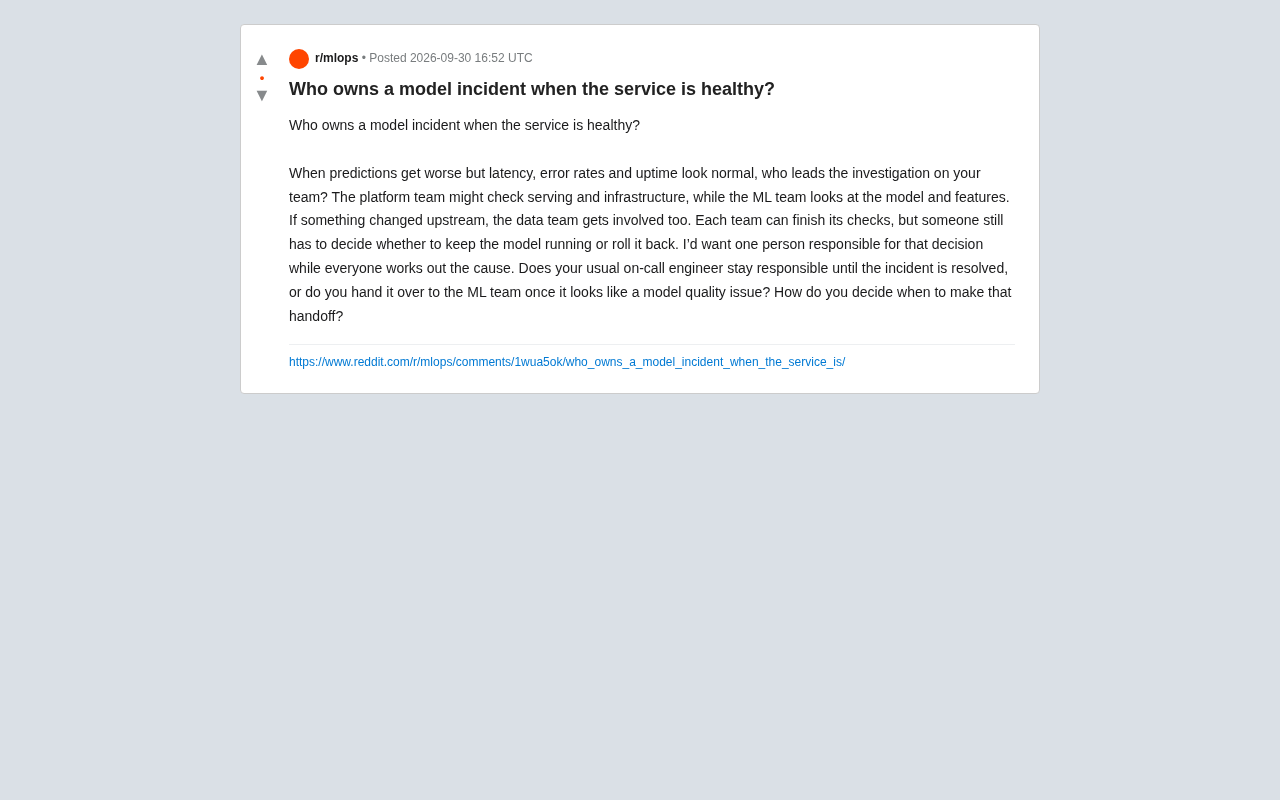
一位 Reddit 用户抛出了这样一个问题——当预测结果明显变糟,而延迟、错误率和 uptime 看起来一切正常时,团队里究竟该由谁来牵头调查?这个看似流程层面的小问题,实际上戳中了现代 ML 运维中权责边界模糊的核心痛点。
为什么模型事故如此难以归属
传统软件事故有清晰的信号:服务宕机、接口报错、响应超时,on-call 工程师立即响应。但模型质量下降是一种"静默故障",它不触发任何告警阈值,却可能在数小时甚至数天内持续损害业务指标。
更棘手的是责任链条的分散。原帖作者准确地描述了三方各自为政的局面:
- 平台团队负责检查 serving 层和基础设施,确认部署、资源、路由没有问题;
- ML 团队排查模型本身和特征,看是否存在数据分布漂移、特征退化;
- 数据团队则在怀疑上游数据管道发生变化时被卷入。
每个团队都能独立完成自己那部分检查,然后得出"我这边没问题"的结论。问题恰恰出在这里——当每个人都完成了检查,却没有人对"是否继续运行模型还是回滚"这个最终决策负责。
分工清晰 ≠ 责任清晰
这是原帖最有价值的洞察:分工明确并不等同于责任明确。三个团队像接力赛一样各跑一棒,但没有人握着指挥棒。
模型事故的调查往往是并行的、探索性的,根因可能藏在任何一环。在因果尚未查明之前,业务仍在承受错误预测带来的损失。此时真正需要的,不是更多的排查人手,而是一个明确的决策人——由他来判断:
是让模型带病运行、等待根因水落石出,还是立即回滚到上一个稳定版本,先止血再追因?
作者明确表达了自己的立场:他希望在所有人协作定位原因的同时,有唯一一个人对这个运行/回滚决策负责。这其实是把"事故指挥官(Incident Commander)"的概念从传统 SRE 领域迁移到了 ML 场景。
「事故指挥官(Incident Commander)」这一角色源自 Google SRE 体系,是大规模生产事故响应的核心设计之一。在传统基础设施事故中,Incident Commander 并不一定是技术最强的人,而是专门负责协调资源、推进决策、维持沟通节奏的角色——他的职责是让事故响应不陷入"会议多、决策少"的泥潭。这一机制之所以有效,正是因为它把"谁在调查"和"谁来拍板"显式地分开了。将这个角色引入 ML 事故场景的难点在于:传统事故有相对清晰的"恢复"定义(服务重新可用),而模型质量事故的"恢复"标准往往模糊——预测质量回升多少才算恢复?由谁来判定?这些问题需要在流程设计时提前约定,否则 Incident Commander 依然会面临无标准可依的困境。
核心争议:交接时机如何界定
原帖真正引发讨论的,是责任交接(handoff)的问题:
- 方案一:让常规的 on-call 工程师从头到尾负责,直到事故彻底解决;
- 方案二:一旦事故看起来是模型质量问题,就移交给 ML 团队。
两种模式各有代价。
如果坚持让 on-call 工程师全程负责,好处是责任主体始终清晰、不会掉链子,但风险是这位工程师可能缺乏诊断模型质量问题的专业能力,容易变成"名义负责、实际抓瞎"。
如果过早交接给 ML 团队,虽然把问题交到了懂行的人手里,却引入了一个危险的空窗期——交接过程本身就可能丢失上下文,而且"看起来像模型问题"的判断未必准确,很多最终被证明是数据管道或 serving 配置导致的。
作者敏锐地追问:到底依据什么来决定何时交接? 这个判断标准本身,往往才是团队流程中最缺失的一块。
一些可落地的思路
虽然原帖是抛出问题而非给出答案,但结合行业实践,可以提炼几条方向:
1. 把"决策权"和"调查权"解耦。 on-call 工程师或指定的 Incident Commander 始终持有运行/回滚的决策权,无论根因在哪一层;各团队只负责提供诊断结论,不各自为政地做决定。
2. 用回滚能力换取调查从容。 如果模型具备快速、可靠的回滚机制,决策人就可以先回滚止血,把"带病运行 vs 回滚"的两难转化为"先回滚、再慢慢查",大幅降低决策压力。
3. 为模型质量建立可观测性。 静默故障之所以危险,正是因为缺少信号。预测分布监控、特征漂移检测、影子流量对比等手段,能让"服务健康但模型失灵"不再是靠业务方投诉才发现。
4. 明确交接的触发条件而非凭感觉。 与其模糊地说"看起来像模型问题就交给 ML 团队",不如事先约定客观标准——比如某项质量指标连续超阈值、基础设施检查全部通过后,才正式移交诊断主导权,但决策权仍留在指挥官手中。
「影子流量(Shadow Traffic)」是一种常见的模型可观测性手段:将线上真实请求复制一份,同时发送给新旧两个模型版本,对比二者的预测分布,但只将正式版本的结果返回给用户。这种方式不依赖标注结果,能实时捕捉新模型在真实流量下的行为异常,是在缺乏即时 Ground Truth 的场景下检测静默退化的有效替代方案。与之配套的「预测分布监控」则追踪模型输出的统计特征(如均值、方差、分位数分布),当分布发生显著偏移时触发告警——这类监控的核心挑战在于设定合理的告警阈值:过于敏感会导致误报疲劳,过于宽松则让真实退化长期潜伏。「特征漂移检测」则更进一步,监控输入特征本身的分布变化,帮助区分根因究竟在数据上游还是模型本身。
写在最后
这个来自 Reddit 的提问之所以值得认真对待,是因为它揭示了 MLOps 成熟度的一个真实短板:我们为服务可用性建立了完善的 on-call 和事故响应体系,却很少为"模型质量事故"设计同等严密的权责机制。
当延迟和错误率都是绿的,而模型正在悄悄犯错时,谁来按下那个回滚按钮?这个问题的答案,或许比任何监控仪表盘都更能反映一个团队的工程成熟度。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。