刚性微分方程求解器能加速神经网络训练吗?

一个被遗忘的90年代思路:用刚性ODE求解器替代普通梯度下降,理论可千倍提速,但被自适应优化器和二阶方法以更实用的形式继承。
本文由一个Reddit问题引出:90年代曾有论文声称用刚性ODE求解器可将神经网络训练提速1000倍,为何此后无人沿用?文章梳理了其数学原理——梯度下降等价于对梯度流ODE做数值积分,普通SGD相当于显式欧拉法,在Hessian条件数极大(刚性)时效率极低;而隐式刚性求解器可用大步长稳定推进。但该方法未流行的原因在于:隐式求解需要昂贵的二阶信息,mini-batch噪声削弱了精确积分的意义,且Adam等自适应优化器已以更廉价的方式缓解刚性。文章最后指出,Neural ODE框架和K-FAC等二阶优化器以不同形态延续了这一思路,提醒读者机器学习的"新"想法往往植根于数十年前的数值分析研究。
一个被遗忘的训练加速思路
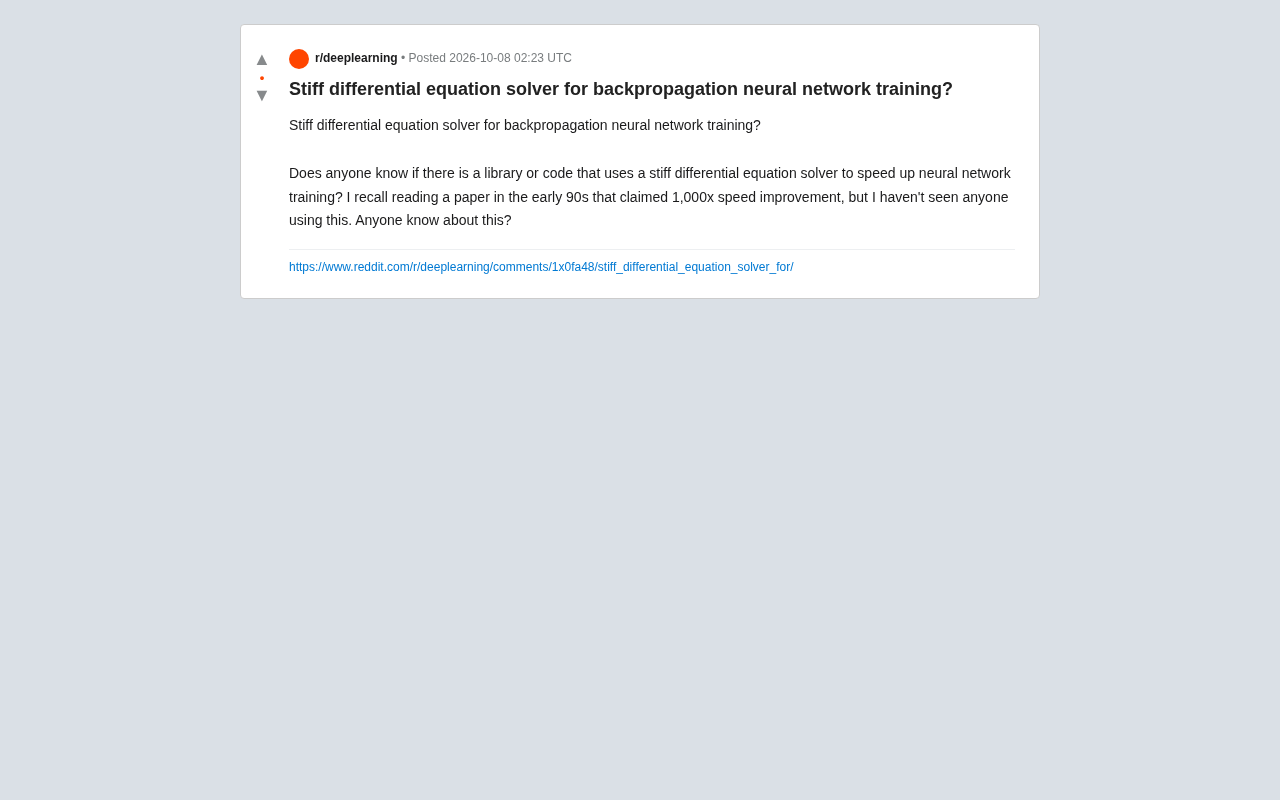
在 Reddit 的机器学习讨论区,一位用户抛出了一个颇具历史厚度的问题:是否存在利用**刚性微分方程求解器(stiff ODE solver)**来加速神经网络反向传播训练的库或代码?提问者回忆,自己在上世纪 90 年代初读到过一篇论文,声称这种方法能带来高达 1000 倍的训练速度提升,但此后再也没见过有人真正使用它。
这个问题看似冷门,却触及了神经网络训练的一个本质视角——把训练过程理解为一个连续动力系统的演化,而非离散的梯度下降步骤。它值得我们认真梳理背后的原理与现状。
为什么训练过程可以看作微分方程
标准的反向传播本质上是梯度下降的离散迭代:参数沿着损失函数负梯度方向一步步更新。如果把学习率看作无穷小的时间步长,这个离散过程就收敛为一个连续的**梯度流(gradient flow)**常微分方程:
dθ/dt = −∇L(θ)
从这个角度看,训练神经网络等价于对上述 ODE 进行数值积分。普通的梯度下降相当于用最朴素的显式欧拉法求解——而数值分析早已告诉我们,欧拉法在面对刚性方程时效率极低,必须用极小的步长才能保持稳定。
什么是刚性问题
所谓刚性(stiffness),指的是系统中同时存在变化尺度差异极大的分量:有的方向收敛极快,有的方向极慢。对损失曲面而言,这对应于 Hessian 矩阵条件数很大、不同参数方向曲率差异悬殊的情形。此时显式方法的步长被最"快"的那个分量卡死,导致整体收敛缓慢。而隐式刚性求解器(如 BDF、隐式欧拉等)能在大步长下保持稳定,这正是"1000 倍加速"说法的理论来源。
一个经典的刚性方程例子是化学反应动力学:反应网络中某些中间物种浓度在微秒内衰减,另一些则需要数小时才达到平衡,两者共存于同一方程组。对神经网络而言,Hessian 矩阵的最大特征值与最小特征值之比(即条件数)就是衡量刚性程度的指标。研究表明,深度网络的 Hessian 条件数可轻易达到 10⁴ 至 10⁶ 量级,这意味着显式欧拉法的步长必须缩小到最快分量所要求的水平,而整个轨迹可能需要数万步才能让最慢分量收敛。BDF(Backward Differentiation Formula) 和 Radau 等隐式刚性求解器通过在每步隐式求解一个方程组来"无条件稳定"地处理快分量,从而允许步长由精度需求而非稳定性需求决定——这正是理论加速比能极高的数学根源。
90 年代那篇论文可能指什么
提问者没有给出论文的确切出处,但从时间和描述推断,这类工作大致属于用常微分方程视角优化神经网络训练的早期尝试。研究者注意到反向传播收敛慢的根源之一就是损失曲面的刚性,于是引入隐式积分或变步长刚性求解器,希望用更大的"时间步"跨越平坦区域。
理论上,如果训练动力学确实高度刚性,隐式方法带来数量级的加速并非天方夜谭。但"1000 倍"这类极端数字通常出现在特定的小规模构造问题上,难以直接推广到真实的大型网络。这也可能是它没有被广泛采用的原因之一。
为什么没有流行起来
从工程现实看,刚性求解器之所以未能成为主流训练方法,有几个关键障碍:
- 隐式求解需要求解线性方程组,每一步都要用到类似 Hessian 的二阶信息或其近似,在百万、十亿参数规模下计算与存储开销巨大。
- 现代深度学习的损失曲面是非凸、高维且随机的,mini-batch 带来的噪声使"精确积分 ODE"的意义被削弱——我们并不需要精确跟踪一条确定性轨迹。
- **自适应优化器(Adam、RMSProp 等)**已经以廉价的方式部分缓解了刚性问题,用逐坐标的自适应步长近似达到了类似效果,工程上更简单。
换句话说,这个思路并非被证伪,而是被更实用、更可扩展的替代方案"绕过"了。
K-FAC(Kronecker-Factored Approximate Curvature) 和 Shampoo 是两种典型的现代二阶/高阶优化器,可作为隐式刚性求解器思路的实用近似。K-FAC 利用 Fisher 信息矩阵的 Kronecker 分解结构,将原本 O(n²) 的曲率矩阵压缩为两个小矩阵的乘积,使预条件步的计算降至可接受范围。Shampoo 则对每个参数张量的各个维度分别维护二阶统计量,同样避免了完整 Hessian 的计算。这些方法在大批量训练场景下往往能以相同计算预算达到更少的迭代步数,与"用大步长跨越刚性方向"的初衷在数学本质上一致。它们的存在也解释了为何专门的刚性 ODE 求解器在优化领域缺乏动力——其核心收益已被以更工程化的方式吸收。
这一思路的现代回响
值得一提的是,把神经网络与微分方程联系起来的研究近年来重新活跃。Neural ODE 将网络的前向传播本身建模为一个连续动力系统,并用成熟的 ODE 求解器(包括刚性求解器)来积分。相关框架如 torchdiffeq、diffrax 中确实内置了刚性求解器选项——不过它们的目标是建模连续动力学,而非直接加速传统反向传播。
从优化角度,二阶方法(如 K-FAC、Shampoo)和各类预条件技术,本质上也在对抗损失曲面的"刚性",与 90 年代那篇论文的动机一脉相承。可以说,提问者记忆中的那个想法,以不同的形态在今天的研究中延续着。
Neural ODE(陈天琦等,NeurIPS 2018)是这一思路现代化最具影响力的体现。其核心思想是将残差网络的逐层变换极限化为连续向量场 dh/dt = f(h,t,θ),网络输出由 ODE 求解器积分得到。梯度则通过伴随方法(adjoint method)反向计算,无需存储中间激活值,内存复杂度从 O(层数) 降为 O(1)。然而当该向量场本身具有刚性时(如建模物理或生化系统),必须切换至刚性求解器(如 diffrax 中的 Kvaerno5 或 torchdiffeq 中的 dopri5 配合刚性检测),否则求解器会陷入步长极小、函数评估次数爆炸的困境。这与 90 年代的问题在技术上完全对称,只是刚性来自被建模的动力学,而非优化轨迹本身。
给提问者的实用建议
如果想实验这一思路,可以从以下方向入手:
- 查阅
diffrax、torchdiffeq等库,它们提供了现成的刚性与隐式求解器接口。 - 在小规模问题上,把训练建模为梯度流 ODE,对比显式欧拉(即标准 SGD)与隐式方法的收敛步数。
- 对那篇传说中的论文,可在 Google Scholar 搜索 "stiff ODE neural network training" 或 "continuous backpropagation" 等关键词,许多 90 年代文献已数字化。
这个问题提醒我们:机器学习的很多"新"思想,其根须往往深扎在数十年前的数值分析与动力系统研究中。重新审视这些被遗忘的角落,有时能带来意想不到的启发。
相关推荐

小米MiMo-V2.6实测:登顶全球开源模型,价格仅为对手几十分之一
小米MiMo-V2.6全模态大模型发布实测:以46分登顶全球开源模型榜单,性能对标Claude、GPT顶级闭源旗舰,而算力成本仅为对手的二十到六十分之一,并同步开源训练环境与代码。本文梳理其跑分、价格、3D推理与开发者实测表现。

20多个孩子背后的代孕黑幕:一对夫妇被捕引发监管拷问
一对夫妇通过代孕生下超过20个孩子,因涉嫌虐童和恐吓证人被捕,保释金2000万美元。案件揭开美国代孕产业监管真空,代孕妈妈Kayla的发现成为关键转折点。

Claude Opus 5.5爆料隐测,直指GPT-6正面对决
Claude Opus 5.5被爆以Cloud Wafer为代号隐蔽测试,表现或超越GPT-6 Sol;同期Grok 4.7短暂上线、智谱ZCode开源整改、硅基流动SIM 4.0开放免费调用、签问Image 2.1许可澄清。本文梳理多条AI动态并厘清传闻与事实边界。