告别参数量依赖:Dirichlet过程实现深度网络无维度PAC-Bayes泛化界

将先验从参数空间移到数据分布空间,用Dirichlet过程构建与参数量无关的PAC-Bayes泛化界。
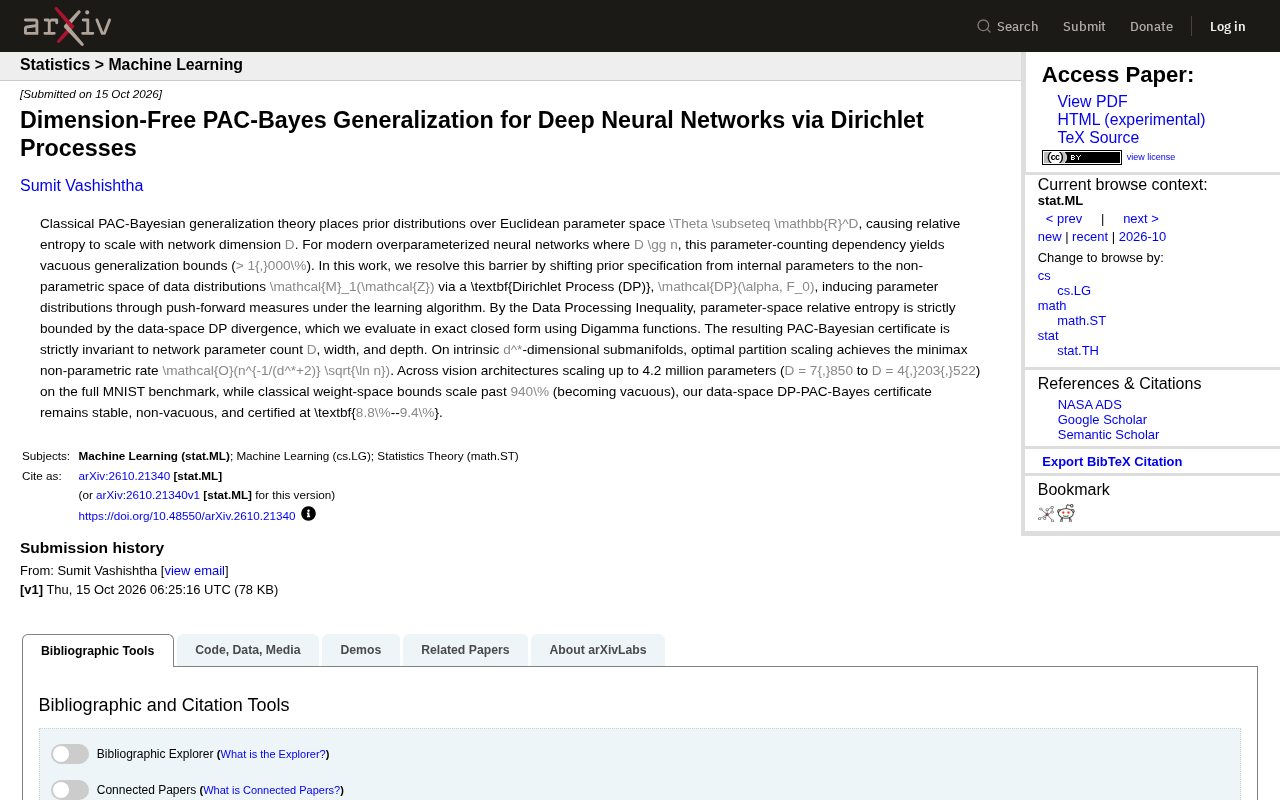
经典PAC-Bayes泛化界因先验定义在参数空间,相对熵随网络维度线性增长,导致过参数化时界超过1000%而失效。该论文提出将先验转移到数据分布空间,采用Dirichlet过程作为非参数先验,并通过数据处理不等式将参数空间相对熵限制在数据空间DP散度内,后者可用Digamma函数闭式计算且不依赖参数维度。理论证明在内在d*维子流形上达到极小极大非参数速率O(n^{-1/(d*+2)} sqrt(ln n))。实验在MNIST上从7,850到420万参数架构验证,新证书稳定在8.8%–9.4%,而经典界超过940%失效。该工作为过参数化深度网络泛化分析开辟了非参数路径,但验证限于较小视觉架构,向Transformer扩展仍需探索。
当参数量成为泛化理论的枷锁
现代深度神经网络动辄数亿参数,远远超过训练样本数量。然而,经典的PAC-Bayes泛化理论却在这样的过参数化场景下举步维艰。问题出在它的起点:先验分布被定义在欧几里得参数空间 $\Theta \subseteq \mathbb{R}^D$ 上,导致相对熵——即泛化界中的关键项——直接随网络维度 $D$ 线性增长。当 $D \gg n$(样本量)时,这个界会迅速膨胀到超过1000%,变得毫无意义。
这并非技术细节,而是范式级的困境。只要先验还锚定在参数空间,任何基于参数计数的复杂度度量都会在过参数化区域失效。要打破这一枷锁,必须将先验的立足点彻底移出参数空间。
PAC-Bayes 泛化界是统计学习理论中一类以概率近似正确(PAC)框架为基础、结合贝叶斯思想的泛化误差上界。其核心形式通常为:以高概率,测试误差不超过经验误差加上一个复杂度项,该复杂度项由后验分布与先验分布之间的 KL 散度(相对熵) 控制。在深度学习中,若先验取为参数空间上的高斯分布,后验为学习算法输出的权重分布,则 KL 项会随参数维度 $D$ 增大而线性增长。这正是过参数化网络下经典 PAC-Bayes 界失效的根源:当 $D \gg n$ 时,复杂度项主导上界,使其迅速超过 100%,失去实际意义。因此,如何设计不依赖参数维度的先验,成为该理论能否适用于现代深度网络的关键。
数据分布空间:先验的新家
这篇论文的核心洞察在于:与其在参数空间设计先验,不如在数据分布空间 $\mathcal{M}_1(\mathcal{Z})$ 上定义先验。具体而言,作者采用Dirichlet过程 $\mathcal{DP}(\alpha, F_0)$ 作为数据分布上的非参数先验,然后通过学习算法的前推测度(push-forward measure)诱导出参数空间的后验分布。
这一转换的妙处在于,它利用了数据处理不等式(Data Processing Inequality):参数空间的相对熵被严格限制在数据空间DP散度的范围内。而数据空间的DP散度可以通过Digamma函数以精确闭式形式计算,完全绕开了参数维度。换句话说,泛化证书现在只依赖于数据分布的内在结构,而与网络的宽度、深度或参数总量无关。
对于在内在 $d^$ 维子流形上运行的学习任务,作者证明最优划分缩放可以达到极小极大非参数速率 $\mathcal{O}(n^{-1/(d^+2)} \sqrt{\ln n})$。这意味着即使在过参数化体制下,泛化误差仍然以样本量的幂律衰减,而非被参数计数所绑架。
Dirichlet 过程(DP) 是定义在概率分布空间上的随机过程,常被用作非参数贝叶斯先验。给定浓度参数 $\alpha > 0$ 和基分布 $F_0$,从 $\mathcal{DP}(\alpha, F_0)$ 中抽取的样本本身就是一个概率分布。它可以看作对“分布”的分布:当 $\alpha$ 较大时,抽取的分布更接近基分布 $F_0$;当 $\alpha$ 较小时,则更倾向于集中在少数几个原子附近。在本文中,DP 被用作数据分布 $\mathcal{M}_1(\mathcal{Z})$ 上的先验,而非传统参数空间上的先验。通过后验集中的离散结构,DP 能够自适应地刻画数据的内在维度,从而使得基于它的泛化复杂度度量不依赖于网络参数量。
数据处理不等式指出:若随机变量 $X \to Y$ 构成马尔可夫链(即 $Y$ 由 $X$ 经某种变换得到),则 $I(X; Z) \ge I(Y; Z)$,其中 $I$ 为互信息。在 PAC-Bayes 框架中,这对应于:从数据空间分布到参数空间分布的前推测度不会增加相对熵。具体地,参数空间后验与先验之间的 KL 散度被数据空间 DP 先验与后验之间的 KL 散度所控制。由于数据空间散度可通过 Digamma 函数精确计算且不显式依赖参数维度,这一不等式成为将泛化界“去维度化”的关键桥梁。
实验验证:从7,850到420万参数,证书稳如磐石
理论推导需要实证支撑。作者在完整的MNIST基准上测试了从 $D = 7{,}850$ 到 $D = 4{,}203{,}522$(约420万参数)的多种视觉架构。结果极具说服力:
- 经典权重空间界:随着参数量增加,泛化界迅速膨胀,在最大模型上超过 $940%$,完全失效;
- 数据空间DP-PAC-Bayes证书:在全部模型规模上保持稳定,非空泛,且认证值位于 $8.8%$–$9.4%$ 区间。
这意味着,当传统方法因维度灾难而崩溃时,新框架依然能给出可靠的泛化保证。更重要的是,这个证书对网络参数数量、宽度和深度是严格不变的——一个真正“无维度”的泛化界。
意义与局限:泛化理论的新坐标
这项工作的价值在于它重新定位了泛化理论的坐标系:不是继续在参数空间修修补补,而是将复杂度锚定在数据分布的内在维度上。这为过参数化深度网络的泛化分析开辟了一条非参数路径,也为理解“为什么大模型能泛化”提供了新的视角——泛化能力或许不取决于参数多少,而取决于学习算法如何在数据分布空间中进行推断。
当然,当前验证仍局限于MNIST和相对较小的视觉架构。DP先验的选取(如浓度参数 $\alpha$ 和基分布 $F_0$)对实际证书紧致度的影响,以及该方法能否扩展到Transformer等更复杂架构,仍需进一步探索。此外,数据空间DP散度的闭式计算虽然优雅,但其数值稳定性在更大规模问题中也有待检验。
无论如何,这项研究指出了一个清晰的方向:要突破深度学习的泛化理论瓶颈,可能需要把先验从参数中解放出来,让数据分布本身来定义复杂度。
极小极大非参数速率是统计估计理论中衡量估计器最优性的基准。对于定义在 $d^$ 维光滑子流形上的非参数回归问题,当真实函数具有某种光滑性时,任何估计器的收敛速度都不可能快于 $\mathcal{O}(n^{-1/(d^+2)})$(忽略对数因子),且存在核方法或局部多项式估计达到该速率。本文证明所提 DP-PAC-Bayes 框架在内在维度 $d^*$ 下达到这一速率乘以 $\sqrt{\ln n}$,这意味着其泛化界在样本量 $n$ 增大时以幂律衰减,而非被网络参数维度 $D$ 所主导。这一结果将深度网络的泛化行为与经典非参数统计理论联系起来,为理解过参数化模型为何仍能泛化提供了定量依据。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。