告别AI Agent技能地狱:4步写出高质量Skill的完整指南

在AI编程的世界里,开发者似乎总能给自己找到新的"地狱"。几年前是"教程地狱"——不断刷教程却拼凑不出完整能力;后来是"框架地狱"——每隔十分钟就冒出一个新的JavaScript框架逼你追赶;而现在,知名工程技能库Matt Pocock Skills的作者Matt Pocock指出,我们迎来了新的困境:技能地狱(Skill Hell)。
从教程地狱到技能地狱的范式迁移: 这一演进路径折射出软件开发工具链三个不同阶段的核心矛盾。教程地狱与框架地狱均属于"信息过载"问题,本质上是人类学习速率跟不上知识生产速率——前者表现为学习路径的碎片化,后者表现为技术选型的决策疲劳。而技能地狱则是一个性质不同的"质量信号缺失"问题:内容本身已足够丰富,GitHub上可以找到数百个Cursor Rules仓库、数千份skill.md文件,但整个生态缺乏可靠的评估机制来区分优劣。这与早期开源软件社区缺乏包质量评估标准的困境颇为相似,只是AI技能的"运行环境"是概率性的语言模型,使得质量评估远比代码库复杂。
什么是"技能地狱"
如今,海量的AI Agent Skill(技能)可以免费下载、贡献和自定义。但问题在于:你根本无法分辨一个技能的好坏,也不清楚这些碎片如何协同工作。人们试图一次性把所有能拿到的技能拼在一起,结果却得不到技能本身承诺的效果。
什么是AI Agent Skill? AI Agent Skill(智能体技能)是现代LLM工具链中的核心抽象层,本质上是一段结构化的Markdown指令文件,被注入到AI Agent(如Cursor、Claude、Windsurf等)的上下文窗口中,用于约束和引导模型的行为模式。这一概念脱胎于早期的System Prompt工程,随着Cursor Rules、Claude Projects等产品形态的普及,逐步演化为可复用、可分发的"行为模块"。与传统软件中的函数库不同,Skill的执行主体是语言模型,其"运行结果"具有天然的概率性和不确定性,这也是为什么技能质量难以用传统软件工程标准衡量的根本原因。值得注意的是,Skill本质上是一种"元指令"——它不直接产生业务输出,而是塑造产生业务输出的模型行为,这使得其效果评估具有明显的滞后性和间接性,需要在真实任务场景中多次运行才能统计出可靠的质量信号。
这种困境不仅存在于个人层面,在组织层面同样严重。企业没有一套方法论去构建优质技能,也不知道如何把自己的标准操作流程(SOP)转化为可用的Agent能力。"再来一个技能就好了,兄弟"——这几乎成了大家的心态。
Matt Pocock坦言自己也有些愧疚,因为他运营着最受欢迎的工程技能库之一。因此,他提出了核心问题:我们缺的到底是什么? 答案是——我们不知道什么样的技能才算优秀。业界没有一套共享的评判标准(rubric),无法看着一个技能就判断它哪里做得好、哪里需要改进。
为此,他提出了一份"技能检查清单",包含四个核心环节:触发(Trigger)、结构(Structure)、引导(Steering)、精简(Pruning)。值得一提的是,他已经把这套方法论本身封装成了一个名为"Writing Great Skills"的技能,放在他的仓库里,用户可以直接下载用来改进自己的技能。
第一步:触发——决定技能如何被调用
技能的调用方式分为两类:用户调用(user-invoked) 和 模型调用(model-invoked)。
任何技能都可以手动调用——技能文件躺在你的文件系统里,你可以直接让Agent读取它。而模型调用的技能则不同:它带有一段description,这段描述会进入Agent的上下文中,Agent可以自行判断"根据这个描述,我该调用这个技能",然后把skill.md文件读入上下文窗口。
这段description本质上是一个"上下文指针",指向存放更多信息的文件。而这个指针是可选的——如果去掉它(设置disable model invocation: true),技能就只对用户可见,成为纯粹的用户调用技能。
两种调用方式的权衡
你可能觉得模型调用更灵活、更好。但Matt Pocock指出,每增加一个模型调用技能,就增加了Agent的"上下文负载"——如果你有100个模型调用技能,那就是100段description常驻上下文,每次请求都在消耗token,也在增加Agent需要思考的负担。
上下文窗口与Token消耗的工程含义: 上下文窗口(Context Window)是大型语言模型一次能处理的最大文本长度,以Token为计量单位。Token并非简单等同于字符——以英文为例,平均每4个字符约等于1个Token;中文则通常每个汉字对应1-2个Token。当前主流模型的上下文窗口已扩展到128K乃至200K Token(如Claude 3.5 Sonnet),但更长的上下文意味着更高的推理延迟、更高的API成本,以及"迷失在中间(Lost in the Middle)"问题——研究表明,模型对上下文中间部分信息的利用率显著低于首尾部分,斯坦福大学2023年的研究显示这一差异可高达20个百分点。因此,精简skill.md的做法,本质上是在对有限的认知带宽做精细化工程管理,兼顾成本控制与模型注意力质量两个维度。
而用户调用技能则带来另一种负载:认知负载。认知负载(Cognitive Load)概念源自教育心理学家John Sweller于1988年提出的认知负荷理论,描述工作记忆处理信息时承受的压力总量。用户调用的技能越多,用户需要在脑子里记住的东西就越多,对使用者的技术要求也越高——这与传统命令行工具"选项越多越难用"的设计困境如出一辙。
对比两大流行技能库:Superpowers主要采用模型调用,赋予Agent"超能力";而Matt Pocock自己的技能库偏爱用户调用,因为这样能把Agent的上下文负载压到最小,代价是自己需要深度理解技能。他偏好用户调用的核心原因在于——模型调用会带来不可预测性:即使某个技能完美契合任务,模型也可能选择不调用它。这种不可预测性会迫使你引入技能评估(eval)流程,非常麻烦;而用户调用则直接消除了这一类问题。
第二步:结构——技能的内部布局
Matt Pocock认为,大多数技能内部由两个基本单元构成:步骤(Steps) 和 参考资料(Reference)。步骤是技能要走完的分步流程,参考资料是支撑这些步骤的辅助信息。
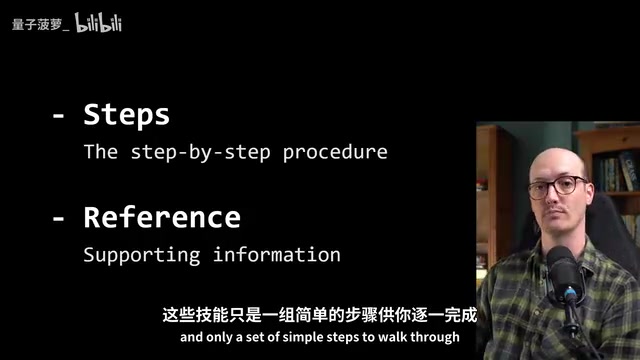
以他的2PRD技能为例,它从当前上下文生成产品需求文档,包含三个步骤:找到相关上下文、与用户确认测试接缝(test seam,一个人在回路的检查点)、撰写PRD。为支撑这三步,它配了两份参考资料:关于"什么是测试接缝"的说明,以及一份PRD模板。
测试接缝(Test Seam)与人在回路(Human-in-the-Loop): 测试接缝这一概念最早由Michael Feathers在《修改代码的艺术》中提出,指代码中可以插入测试观测点的位置。在AI Agent工作流语境下,Matt Pocock将其引申为"人类可以介入检查的断点"——即在Agent自动执行的长链路任务中,刻意设置的人工确认节点。这一设计哲学与工业自动化领域的"人在回路(Human-in-the-Loop,HITL)"高度契合:完全自动化并不总是最优解,在高风险或高模糊性节点保留人类判断权,能显著降低自动化系统的失控风险。在LLM Agent的实践中,合理设置测试接缝尤为重要,因为模型的错误往往具有"自信的错误"特征——它会以同等语气输出正确答案和错误答案,使得无人工干预的全自动流程存在难以察觉的静默失败风险。
让skill.md尽可能精简
每个技能由description、skill.md主文件以及从主文件延伸出的参考资料组成。把skill.md做小有诸多好处:更易维护、更易审计、消耗的token更少。
实现方式是分析技能的"分支"。如果某份参考资料只在一个分支中用到,它就是被移出主文件的候选。以2PRD为例,它只有一条分支,PRD模板每次都要用,所以理应留在skill.md中。
但另一个技能domain modeling则不同——它可能更新本地术语表context.md,也可能创建架构决策记录(ADR),甚至两者都不做。
架构决策记录(ADR)是什么? ADR(Architecture Decision Record)是一种轻量级的技术文档实践,最早由Michael Nygard于2011年系统化提出,用于以结构化文档记录每一个重要的架构决策:包括决策的背景(Context)、被考虑的选项(Options)、最终决定(Decision)以及采纳后果(Consequences)。标准ADR格式通常只有一页纸左右,刻意保持简洁以降低书写门槛。在AI辅助开发的工作流中,ADR具有双重价值:一方面作为人类工程师的决策日志,避免团队成员反复讨论已有定论的问题;另一方面可直接作为AI Agent的"记忆补丁"注入上下文,帮助Agent理解项目的历史约束和技术债务背景,避免每次对话都要重新解释"为什么选PostgreSQL而不是MongoDB"这类问题。随着AI Agent在长周期项目中的深度介入,ADR正从可选的最佳实践演变为必要的工程基础设施。
domain modeling有两到三条分支,因此ADR模板和context.md模板都不该塞进主文件,而应放到独立的markdown文件中,通过"上下文指针"引用。指针只需写一句"如果你需要模板,去这个文件找"。Matt Pocock称之为"外部引用"。
核心技巧:把只属于单一分支的参考资料藏在上下文指针后面。
第三步:引导——让Agent真正照做
这是Matt Pocock认为最重要的一环,它解决了一个经典痛点:你在技能里明明说清楚了,Agent却不照做。
他给出的核心工具叫"引导词(leading words)"。所谓引导词,是那些能在极小空间内塞入大量含义的词汇。它的运作机制很巧妙:你把引导词写进技能文本,Agent会在推理token和思考过程中反复复述这个词,由于不断强化这个词,而它恰好描述了你想要的行为,Agent的输出就随之改变。
推理轨迹(Reasoning Trace)与可观测性: 推理轨迹也称思维链(Chain of Thought,CoT),是指模型在生成最终答案之前产生的中间推理步骤,由Google Brain团队于2022年的论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》系统化提出。以OpenAI o1/o3系列和Anthropic Claude 3.7 Sonnet(Extended Thinking模式)为代表的推理型模型,会在内部生成大量"思考Token",通常以折叠形式对用户可见。Matt Pocock建议"在思考轨迹中观察Agent是否采纳了引导词",本质上是把推理轨迹作为调试界面(Debug Interface)——如果模型在思考过程中复述了引导词,就说明该词已被激活并纳入推理框架,进而影响最终输出。这种基于推理轨迹的可观测性实践,是当前提示工程(Prompt Engineering)向更严谨的"提示调试"方向演进的重要标志,也是区分"随机试错派"提示工程师与"方法论驱动派"的关键分水岭。
引导词实战案例
一个典型问题是:Agent倾向于"逐层编码"——先写完整个数据库层,再写schema,再写API端点,最后写前端。它不像经验丰富的开发者那样先做出一个可运行的小切片、及早获取反馈再迭代扩展。
你当然可以直接说"不要逐层编码,先做一个小切片"。但更好的做法是使用引导词:vertical slice(垂直切片)。
垂直切片的软件工程渊源: 垂直切片(Vertical Slice)是敏捷软件开发中的核心实践之一,与"水平分层(Horizontal Layer)"开发模式相对:水平分层要求先完整实现数据库层、再实现业务逻辑层、最后实现UI层;而垂直切片则要求每次迭代都穿透所有层级,交付一个端到端可运行的最小功能单元(类似MVP思维)。这一术语在Scrum、极限编程(XP)以及吉米·尼尔森(Jimmy Nilsson)等人的领域驱动设计(DDD)实践中均有深入阐述,在专业开发者社区中具有高度的语义共识性。其核心价值在于及早集成、及早暴露风险,避免"最后阶段集成地狱"。Matt Pocock将这一成熟术语作为"引导词"注入AI Agent,利用的正是模型在预训练语料(包含海量技术博客、Stack Overflow讨论和开源项目文档)中积累的大量关于该术语的先验知识,使模型能在无需详细解释的情况下自动映射到正确的行为模式。这也印证了一个更广泛的提示工程原则:使用领域内已有丰富语料支撑的专业术语,往往比临时造词的引导效果更稳定。
这是开发领域公认的术语,会触发Agent的先验知识。你只要在技能中反复使用这个短语,就能在推理轨迹里看到Agent说"我们把它做成一个薄薄的垂直切片"——这就是引导词生效的证据。
Matt Pocock强调,很多开发者其实早就在用类似的短语引导Agent,他的建议只是:在技能中一致地、有力地使用这些引导词,并在思考轨迹中观察Agent是否真正采纳了你的方式。
拆分技能:强制Agent专注当前步骤
另一个解决Agent"偷懒"问题的杠杆是拆分技能。典型案例是plan mode(计划模式):它包含"提出澄清性问题"和"制定计划"两步。但Matt Pocock发现,Agent看到最终目标是制定计划,就会草草问几个问题、急着去做计划,澄清阶段永远做得不够深。
他的解法是将两步拆开:把澄清阶段独立成一个叫grill with docs的技能,把规划独立成2PRD。这样Agent一次只看到一步。通过隐藏未来的目标和步骤,迫使Agent在当前步骤投入足够的精力。 这个技巧在需要深度工作的场景下效果显著,其背后的认知科学依据是"目标梯度效应(Goal Gradient Effect)"——越接近目标,执行主体越倾向于加速而非保持质量,通过截断目标可见性来重置这一效应。
第四步:精简——修剪掉冗余
精简是一组快速排查的"失败模式"清单。核心原则是:不要有臃肿的巨型技能——巨型技能往往是其他问题的外在症状。
失败模式一:重复(DRY)。 每一部分内容都应有单一事实来源。像PRD模板、"什么是测试接缝"这类参考资料,绝不要在多处重复定义。
DRY原则的工程背景: DRY(Don't Repeat Yourself,不要重复自己)是软件工程中最基础的设计原则之一,由Andrew Hunt和David Thomas在1999年的经典著作《程序员修炼之道》(The Pragmatic Programmer)中正式提出,原文表述为"Every piece of knowledge must have a single, unambiguous, authoritative representation within a system"。其核心主张是:系统中的每一份知识都应有单一、明确、权威的表示。违反DRY会导致"知识碎片化"——修改某个概念时,必须同时找到并更新所有副本,极易遗漏,形成"一致性债务"。将DRY应用于AI技能文档有其特殊挑战:文档维护通常是分布式、异步进行的,且缺乏传统代码库中的静态分析工具(如重复代码检测器)支持,使重复问题更难被自动发现。此外,多个技能文件同时被注入上下文时,重复内容会造成Token双重消耗,加剧上下文窗口的压力。
失败模式二:沉积(Sediment)。 当多人协作同一份文档时,每个人都往里加内容,却没人敢删改别人的东西,最终堆积出大量不相关的"沉积物"。这一现象在社会工程学层面有深刻根源:修改他人贡献内容的心理阻力(源于对贡献者劳动成果的尊重以及引发冲突的顾虑)远大于添加新内容,与代码库中的"破窗效应(Broken Window Theory)"高度类似——质量一旦开始下滑,便会随时间单向衰退,无人干预时最终趋向混乱。应对方法是先审视结构:判断新增内容是否与所有分支相关,不相关就移到正确分支,彻底无关或过时的就直接删掉。建立定期"技能审计"的工程文化,比依赖个人自觉更具可持续性。
失败模式三:空操作(No-ops)。 这在Agent自动生成技能时尤其常见——某段描述看似在约束行为,实则删掉它也不影响Agent的输出质量。比如让Agent"写一条详细的commit信息",但即使删掉这句,Agent照样会写出不错的commit信息。空操作指令的危害不只是浪费Token,更在于它稀释了技能文档中真正有效指令的信号密度,类似于噪音干扰信号的传播。Matt Pocock透露,他的技能之所以如此精简,靠的正是不断做"删除测试":把意图压缩进引导词、清除无关内容和沉积物。系统化的"消融测试(Ablation Test)"方法——逐条删除指令后对比输出质量——是识别空操作最可靠的实证手段,这也借鉴自机器学习领域评估各组件贡献度的标准方法论。
总结:四步框架速览
这套框架完整覆盖了写好AI Agent Skill的全流程:
- 触发:确认技能在正确时机被调用,权衡施加上下文负载(模型调用)还是认知负载(用户调用)。
- 结构:拆分为步骤与参考资料,把只属于单一分支的材料移出主文件,让skill.md保持精简。
- 引导:用引导词把意图压缩成可复用的关键词,并在推理轨迹中验证;必要时拆分技能,强制Agent专注当前阶段。
- 精简:做最后一遍修剪,警惕沉积、冗余,重点排查空操作。
最好的上手方式,就是去Matt Pocock的仓库下载"Writing Great Skills"技能,用它来审查和改进自己的技能,甚至评估社区贡献的技能是否真的可靠。在AI编程日益依赖Agent技能的今天,掌握辨别好坏技能的能力,正变得越来越关键。
核心要点
核心要点
相关推荐
Vibe Coding是什么?程序员必须掌握的AI编程能力
Vibe Coding(AI编程)到底是什么?本文解析AI编程如何重塑研发流程、为何传统程序员面临淘汰、Cursor与Claude Code两大工具,以及程序员、PM、运营等岗位为何都该掌握这项能力。
让石头思考:生成式AI与信息压缩的哲学思考
从Reddit热帖「让石头思考」出发,探讨生成式AI的信息论本质:为何压缩等价于理解,巴别图书馆式的可能性空间思辨,以及语义压缩、Hutter Prize与AI原理的深层联系。
让Claude"浪费"额度:一场AI创造力的意外实验
一位Reddit用户让Claude用剩余额度"做件荒唐的事",结果AI生成了监控一块石头的企业级平台RockOps。本文分析这一趣味案例背后的AI创造力与产品设计能力。