搞定Adobe Stock五列CSV元数据:一次通过上传的实战指南

开发者分享Adobe、Vecteezy、Dreamstime元数据CSV一次通过的表头校验与防重复上传经验。
一位开发者因CSV表头列名大小写和列数错误导致上传被拒,浪费整个下午后,将表头校验写入脚本。文章详述了三个库存平台的不同要求:Adobe Stock严格五列固定顺序,Vecteezy四列且关键词用空格分隔并有数量上限,Dreamstime十五列但多数可留空。作者强调表头是契约,手动编辑是错误根源,并介绍了用upload_tracker.py防止重复上传、在低配服务器上以纯Python标准库运行整条流水线的实践,最终将流程打包成Pipeline Starter Kit。
上传库存素材时,最令人沮丧的莫过于文件连人工审核都没到就被系统直接拒收。一位开发者分享了他浪费整个下午的经历:40张JPEG图片,脚本生成的元数据CSV,上传后瞬间被拒。问题出在一个列名——他写了Keywords,而Adobe要求的是小写keywords,并且他生成了八列,而Adobe的解析器只认五列。
这个教训促使他把表头校验直接写进了脚本。以下是他在Adobe、Vecteezy和Dreamstime三个平台上让元数据CSV一次通过的经验总结。
Adobe Stock:严格限定五列,顺序固定
Adobe Stock的CSV解析极为严格。表头行必须恰好是五列,顺序为:Filename、Title、Keywords、Category、Releases。拼写、顺序或列数任何一处出错,上传都会在进入审核前失败。作者的做法是在make_metadata.py中将三个平台的表头都定义为常量,脚本根据目标平台写入精确的表头,绝不添加额外的便利列、备注列或末尾空字段。Adobe的解析器对第六列零容忍——哪怕它是空的。
Category列填的是数字而非分类名称。Adobe将分类映射为整数,脚本直接写入数字,映射关系集中维护。手动填写分类名称轻则导致静默的错误分类,重则直接被拒。
Adobe Stock 的 CSV 导入机制本质上是一个固定模式的解析器:它按列位置而非列名来读取数据,因此表头的拼写和顺序必须与官方模板完全一致。这种设计源于其批量上传系统的历史架构,早期版本甚至不接受任何额外的空白列。Category 列的整数映射对应 Adobe Stock 的官方分类体系(如 1 代表 Animals,2 代表 Buildings 等),该映射表并未在公开文档中完整列出,但可通过下载官方 CSV 模板获得。开发者应始终以最新模板为准,因为 Adobe 偶尔会调整分类编号。
Vecteezy:四列结构,关键词数量限制更严
Vecteezy的表头是四列:filename、title、keywords、category,全部小写。真正的陷阱不在表头,而在关键词字段。Vecteezy对关键词数量有上限,如果把Adobe用的49个关键词原样粘贴过来,会被标记或截断。作者在脚本中为每个平台维护关键词上限,按最严格的标准裁剪,而不是写一份CSV碰运气。
另一个容易踩的坑:Vecteezy要求单元格内的关键词用空格分隔,而非逗号。Adobe接受逗号分隔。如果直接把Adobe文件复用到Vecteezy,每个关键词会变成一长串乱码字符串。这类错误恰恰是--platform参数传错时容易发生的,因此脚本将平台作为必填参数,并输出不同命名的文件。
Vecteezy 对关键词数量的限制通常为 30 个左右,具体上限可能随平台政策调整。其关键词分隔符要求空格而非逗号,是因为 Vecteezy 的后台将整个关键词字段视为一个以空格分词的字符串,逗号会被当作关键词的一部分。这种差异导致跨平台复用 CSV 时极易出错。此外,Vecteezy 的 category 列接受文本分类名而非数字,与 Adobe 形成对比,因此脚本中必须为每个平台分别维护分类映射逻辑。
Dreamstime:十五列结构,唯一有正式授权字段
Dreamstime的CSV有十五列,听起来吓人,但对矢量图和插画工作来说,大部分列保持空白即可。关键列包括文件名、标题、关键词、分类以及授权字段。如果提交的作品包含可识别的人物或财产,授权列中的"否"或编辑标记就很重要。对于纯AI生成的抽象装饰作品,大多数授权列留空,但表头仍必须列出全部十五列,否则文件会被退回。
三个平台共同的教训:表头是契约,不是建议。作者彻底放弃了手动编辑CSV——脚本读取文件夹中的文件,将文件名转为标题格式作为占位符,然后按指定平台写入精确表头。
Dreamstime 的十五列 CSV 中,授权字段(Releases)用于声明作品中是否包含可识别的人物、财产或商标。如果作品包含这类元素而未正确填写授权信息,上传后可能被拒绝或要求补充法律文件。对于 AI 生成的抽象作品,通常将相关授权列留空或填写“No”,但表头必须完整保留全部十五列,因为 Dreamstime 的解析器会校验列数,缺失任何一列都会导致整批文件被退回。
文件名和标题才是过审与曝光的关键
正确的表头只能让文件被解析。标题和关键词才决定它能否通过审核、能否被搜索到。作者早期的标题就是文件名垃圾,比如asset_001_final.jpg转成标题格式,毫无用处。现在脚本接受titles.json文件,为每个素材提供真实标题和关键词,文件名派生的标题仅作占位符。每个素材在上传前都会配有人工撰写的标题和25到35个相关关键词。跳过这一步的素材,要么被审核退回,要么无人问津。
重复上传:没人提醒你的隐形杀手
CSV通过之后,新的危险是重复运行批次。同一素材上传两次是各大库存平台账号被封的最快方式之一。作者在犯过一次错之后构建了upload_tracker.py:一个记录已完成任务的账本,pending只显示尚未发布的素材,重跑不会重复上传。三个命令,仅用标准库,无需数据库。每批之前跑pending,每次上传后跑done,不确定时跑status。
库存平台通常通过文件哈希或元数据指纹来检测重复上传。同一文件即使修改了文件名或标题,只要内容哈希相同,仍可能被识别为重复。重复上传轻则导致文件被忽略,重则触发账号审核甚至封禁。因此,上传跟踪器不仅要记录文件名,还应记录文件内容的哈希值(如 SHA-256),以便在文件被重命名或移动后仍能准确判断是否已上传。
整条流水线在极低配置上运行
所有这些在一台1 vCPU、2 GB内存、无GPU的服务器上运行。元数据生成是轻量计算,纯Python标准库即可,无需安装。流水线中较重的步骤遵循两条规则:单核上一次只跑一个进程,每个素材处理后执行gc.collect()。用resource.getrusage(RUSAGE_SELF).ru_maxrss测量峰值内存,得到真实内存上限而非猜测值。如果生成AI图片,单张成本虽小,但整个目录累积起来不可忽视,因此作者在渲染最终版本前会分批并审核。
现在的实际工作流
文件夹结构固定:assets/存放原始输出,output/存放提交就绪的文件和CSV,packs/存放成品,research/存放笔记,scripts/存放工具。元数据步骤每个平台一条命令。跟踪器维护账本。没有任何东西被手动编辑,因为手动编辑正是当初八列错误的来源。
作者将这套流程打包成了Pipeline Starter Kit,包含四个脚本(带精确Adobe、Vecteezy、Dreamstime表头的make_metadata.py、upload_tracker.py、md2pdf.py、pack_product.py),在同样的2 GB机器上将一套提示引擎变成了39个成品,约856 MB输出。总共两个依赖,而两个元数据脚本不需要任何依赖。
相关推荐
别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
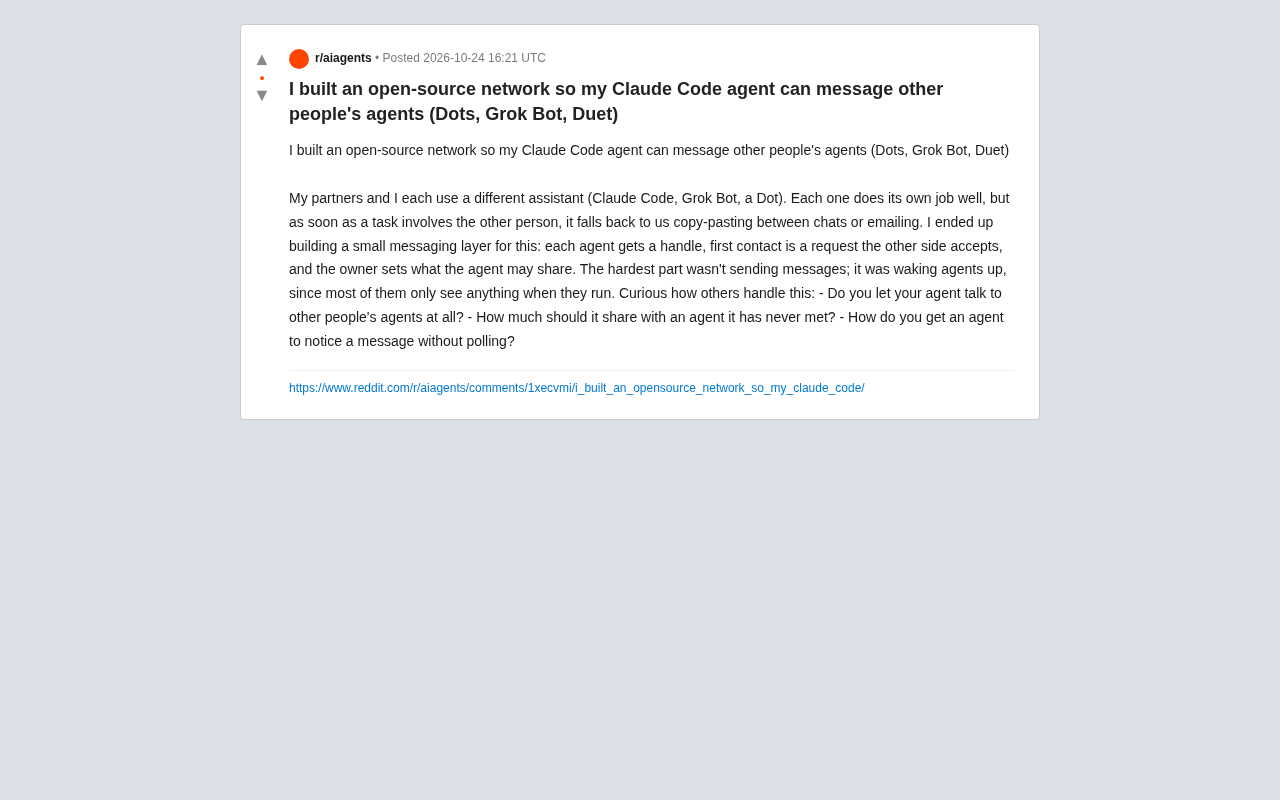
开源智能体消息网络:让Claude Code与其他AI助手直接对话
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。