高频交互数据建模人类快速反应:EMBER与ORBIT模型解析
研究利用CS2毫秒级遥测数据构建Ego-Knowledge框架,训练EMBER和ORBIT模型识别快速战或逃反应,准确率超LLM。
该研究探索能否从高频数字交互数据中建模人类快速反应。作者利用《反恐精英2》毫秒级遥测数据,提出“自我知识”框架,基于可见性和伤害触发事件生成60–120毫秒窗口的“战或逃”标签,并训练梯度提升模型EMBER和Transformer模型ORBIT。在验证集上,EMBER和ORBIT准确率分别为73.5%和71.2%,显著超越多数类基线(51.5%)和最强LLM基线(62.7%),且推理成本低数个数量级。引入触发后短窗口后,任务转为早期反应识别,准确率单调升至85.15%。作者强调神经科学解释为假设生成性,生理验证和逆向推断局限仍是开放问题。
人类在高压环境下的快速反应——比如电竞比赛中瞬间的闪避或反击——能否通过高频数字交互数据被建模甚至预测?一篇最新探索性研究给出了初步答案。研究者利用《反恐精英2》(Counter-Strike 2)的毫秒级遥测数据,构建了“自我知识”(Ego-Knowledge)框架,并训练了两个原生遥测模型,尝试从可见性和伤害触发事件中识别类似“战或逃”的快速行为签名。
研究背景与核心问题
传统反应时间研究多依赖实验室环境下的受控实验,生态效度有限。而高频数字交互数据——特别是竞技游戏中的遥测记录——提供了近乎连续的行为流,其中包含丰富的感知-动作耦合信息。研究者提出的核心问题是:能否在这些数据中识别出 limbic-like(类似边缘系统)的快速、显著性驱动的行为特征?
为此,他们引入了“自我知识”(Ego-Knowledge)概念,指对每位玩家可能感知状态的低泄漏重建。这依托于一个毫秒级精度的可见性引擎和一个以反应为中心的提取流水线,确保标签生成过程尽可能贴近真实感知事件。
边缘系统(Limbic System) 是大脑中与情绪、动机和生存行为密切相关的神经结构集合,包括杏仁核、海马体、下丘脑等。其中杏仁核在威胁检测和“战或逃”(fight-or-flight)反应中起关键作用:当个体感知到显著威胁时,杏仁核可绕过高阶皮层,通过快速皮下通路触发即时生理与行为反应,这一过程通常在数十至百余毫秒内完成。研究者所谓“limbic-like”特征,即指数据中表现出的快速、显著性驱动、低意识参与的行为模式,而非直接测量边缘系统活动。
方法:从战或逃标签到遥测原生模型
研究采用神经科学动机的 60–120 毫秒时间窗口,从可见性和伤害触发事件中衍生出粗略的“战或逃”标签。背部受到伤害的案例允许进行受限反应时间分析,并辅以人工标签检查。基于这些标签,团队训练了两个仅使用触发时刻可得信息的遥测原生模型:
- EMBER:梯度提升模型(gradient boosting)
- ORBIT:自定义 Transformer 模型
两者均不依赖任何未来信息或事后数据,确保预测的因果性。
梯度提升(Gradient Boosting) 是一类集成学习方法,通过逐轮训练弱学习器(通常为决策树),每轮拟合前一轮的残差,最终加权组合成强模型。其优势在于能自动捕捉特征间的非线性交互,对表格型遥测数据尤为高效,且推理速度快、可解释性较好。Transformer 则基于自注意力机制,能建模序列中任意位置间的依赖关系,适合处理高频交互事件流。两者在本研究中的对比,体现了传统机器学习与深度序列模型在毫秒级行为建模上的不同权衡。
McNemar 检验 是一种用于配对二分类数据的统计检验,通过比较两个模型在同一批样本上预测不一致的分布,判断其准确率差异是否显著。本研究中 p 值远小于 0.05,表明 EMBER 和 ORBIT 优于 LLM 基线的结果不太可能由随机波动导致,增强了结论的统计可信度。
主要结果:显著超越基线与 LLM
在完整验证集上,EMBER 达到 73.5% 的准确率,ORBIT 为 71.2%,而多数类基线仅为 51.5%。两个模型均能泛化到未见过的玩家。更引人注目的是与大型语言模型(LLM)的对比:在 1,000 个验证案例上,最强 LLM 基线准确率为 62.7%,而 EMBER(73.6%)和 ORBIT(70.9%)表现更优,McNemar 检验 p 值分别为 1.3e-9 和 1.5e-6,统计显著。同时,这两个模型的推理时间和成本比 LLM 低数个数量级——尽管作者谨慎指出,该比较并非算力匹配。
从预测到识别:引入触发后窗口
当在触发时刻之后加入一个短时间窗口,任务从“预测”转变为“早期反应识别”,准确率单调上升至 85.15%。研究者提出,这条准确率随窗口延长的变化曲线可作为从快速控制向审慎控制过渡的候选探针。但他们也坦承,每 tick 收益大致均匀,并不能确证这一解释。
开放问题与未来方向
作者强调,神经科学框架是假设生成性的,而非机制性的。生理 ground truth、合适的控制分布以及逆向推断的局限性仍是未解难题。未来工作将扩展到听觉重建、更大规模数据集,以及原生遥测基础模型。
这项研究展示了高频交互数据在建模人类快速反应方面的潜力,也为认知科学与游戏数据的交叉研究提供了新工具。尽管离机制性理解尚有距离,但 EMBER 和 ORBIT 的表现为后续探索奠定了可复现的基准。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
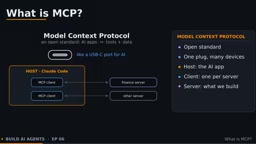
30行Python自建MCP服务器并接入Claude Code
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。