高斯过程Bandit优化黑盒杠杆约束
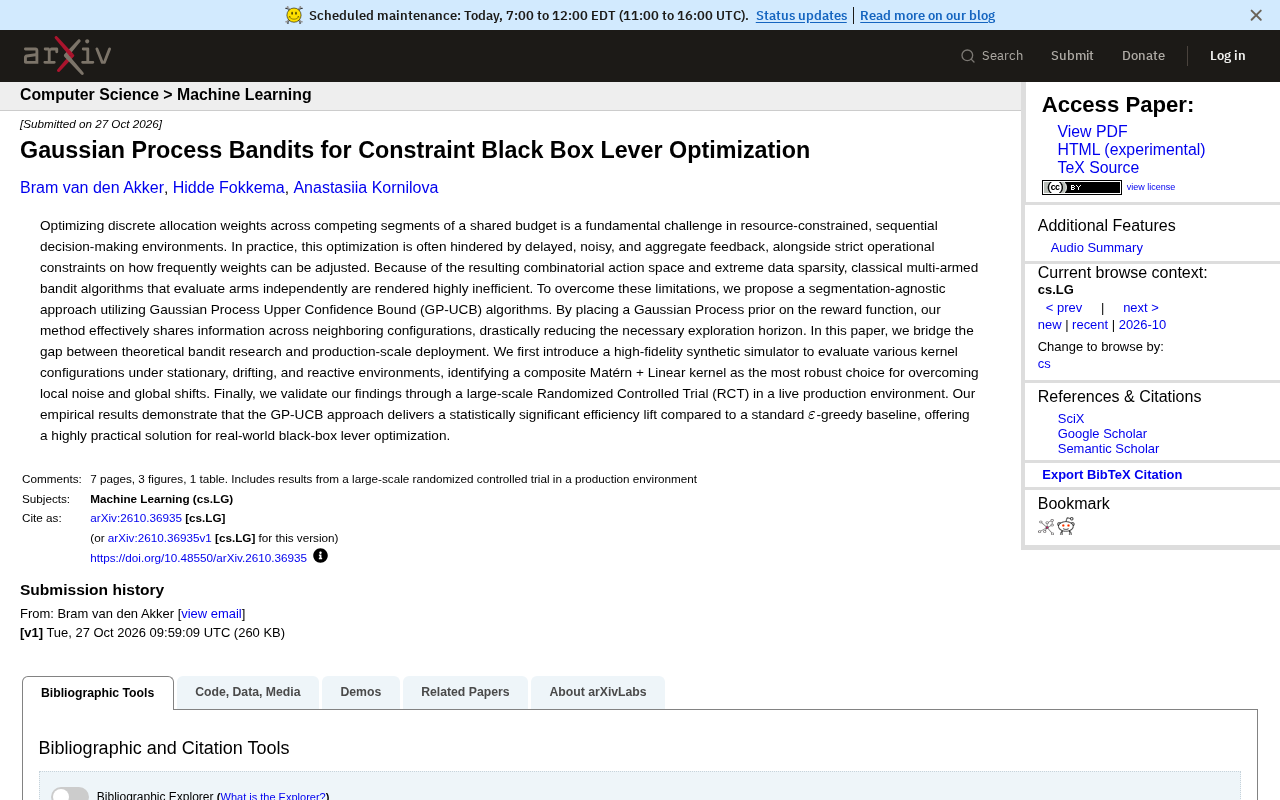
GP-UCB利用高斯过程在相邻配置间共享信息,显著提升共享预算下离散权重分配的序贯决策效率。
本文探讨在共享预算下为竞争性细分市场分配离散权重的序贯决策问题。面对组合动作空间、延迟噪声反馈和调整频率约束,经典多臂Bandit算法因独立评估每个臂而效率低下。作者提出采用高斯过程上置信界(GP-UCB)方法,通过高斯过程先验在相邻配置间共享信息,大幅减少探索周期。研究构建高保真合成模拟器,在静态、漂移和反应性环境中测试核配置,确定复合Matérn+Linear核最为稳健。最后通过大规模生产环境随机对照试验验证,GP-UCB相比ε-greedy基线在统计上显著提升效率,展示了从模拟器到生产RCT的完整验证链条。
在共享预算下,如何为相互竞争的细分市场分配离散权重,是资源受限的序贯决策环境中的一个根本性挑战。现实中的优化往往受到延迟、噪声和聚合反馈的阻碍,同时权重的调整频率还面临严格的运营约束。由此产生的组合动作空间和极端的数据稀疏性,使得独立评估每个臂的经典多臂Bandit算法效率低下。为了克服这些限制,研究者提出了一种与细分无关的方法,利用高斯过程上置信界(GP-UCB)算法。通过在奖励函数上放置高斯过程先验,该方法能够在相邻配置之间有效共享信息,从而大幅减少所需的探索周期。
从理论到生产:GP-UCB的桥梁
这篇论文的核心贡献在于弥合了理论Bandit研究与生产规模部署之间的差距。作者首先引入了一个高保真合成模拟器,用于在静态、漂移和反应性环境中评估各种核配置,并确定了复合的Matérn + Linear核是克服局部噪声和全局偏移的最稳健选择。最后,他们通过一个大规模随机对照试验(RCT)在真实生产环境中验证了研究发现。实证结果表明,与标准的ε-greedy基线相比,GP-UCB方法在统计上显著提升了效率,为现实世界的黑盒杠杆优化提供了一个高度实用的解决方案。
问题背景:为什么经典Bandit不够用
在共享预算分配的场景中,决策者需要将有限的资源分配给多个竞争性细分,每个细分获得的权重是离散的。反馈信号往往是延迟的、带有噪声的,并且是聚合层面的——你无法立即知道某个具体权重调整带来的精确收益。更麻烦的是,运营上对权重调整的频率有严格限制,不能频繁试错。
这种设定下,动作空间是组合爆炸的:假设有K个细分,每个细分的权重从M个离散值中选择,那么总的配置数量就是M^K。经典的多臂Bandit算法(如ε-greedy)把每个配置当作一个独立的臂,需要逐个探索,在数据稀疏的情况下效率极低。因为相邻配置之间其实存在相似性,独立评估完全忽略了这种结构信息。
多臂Bandit问题是序贯决策中的经典框架:决策者在每一轮从若干个“臂”中选择一个拉动,获得随机奖励,目标是在探索(尝试未知臂以获取信息)与利用(选择当前看来最优的臂)之间取得平衡,以最大化累积奖励。经典算法如ε-greedy以概率ε随机探索、以概率1-ε选择当前估计最优的臂;UCB(Upper Confidence Bound)则基于置信上界选择臂,在理论上具有对数级的遗憾界。然而,这些算法通常假设每个臂的奖励分布独立,且动作空间规模较小。当动作空间呈组合爆炸(如M^K个配置)且反馈稀疏时,独立评估每个臂会导致探索成本随动作数线性增长,无法利用动作之间的结构相似性,因而效率急剧下降。
GP-UCB如何共享信息
GP-UCB的核心思想是利用高斯过程先验来建模奖励函数。高斯过程假设相邻配置的奖励是相关的,通过核函数定义这种相关性。这样一来,对一个配置的观测可以同时更新对邻近配置的信念,信息在配置空间上平滑传播。相比独立评估每个臂,GP-UCB只需要探索更少的配置就能找到接近最优的解。
论文中特别强调了核函数的选择。他们构建了一个高保真合成模拟器,在三种环境下测试了不同的核配置:静态环境(奖励分布不随时间变化)、漂移环境(奖励分布缓慢变化)和反应性环境(奖励分布对决策做出反应)。结果表明,复合的Matérn + Linear核表现最为稳健。Matérn核擅长捕捉局部变化,Linear核则能建模全局趋势,两者结合既能对抗局部噪声,又能适应全局偏移。
高斯过程(Gaussian Process, GP) 是一种定义在连续域上的随机过程,任意有限个点的函数值服从联合高斯分布。它由均值函数和核函数(协方差函数)完全确定,核函数编码了不同输入点之间函数值的相关性——距离越近的点,函数值越相似。在贝叶斯优化中,GP常被用作目标函数的代理模型:给定已观测点,可解析地计算出任意未观测点的后验均值和方差,分别代表预测值和不确定性。GP-UCB将这一后验不确定性纳入决策,选择“后验均值 + β×后验标准差”最大的点作为下一个探索目标,其中β控制探索的激进程度。这一策略在理论上保证了次线性遗憾,并且通过核函数实现了信息在连续空间上的传播,从而避免了对每个离散配置的独立探索。
Matérn核与Linear核是高斯过程中两种常用的核函数。Matérn核通过参数ν控制样本路径的平滑度,较小的ν允许函数较快变化,擅长捕捉局部波动和噪声,其常见形式包括ν=1/2(指数核)、ν=3/2和ν=5/2。Linear核(线性核)形式为k(x,x')=σ²·xᵀx',它假设目标函数近似线性,能够建模全局趋势和偏移。将两者复合(通常为相加)后,核函数同时具备局部适应性和全局趋势捕捉能力:Matérn成分负责解释局部非线性变化,Linear成分负责吸收整体漂移,从而在静态、漂移和反应性环境中都表现出稳健性。核函数的选择和超参数校准是GP-UCB部署中的关键环节,通常通过最大化边际似然或交叉验证在模拟器中完成。
生产环境RCT验证
理论分析和模拟器实验之后,研究团队在一个真实的生产环境中进行了大规模随机对照试验。他们将GP-UCB方法与标准的ε-greedy基线进行对比,衡量指标是效率提升。结果显示,GP-UCB在统计上显著优于基线,验证了该方法在实际部署中的有效性。这一结果的意义在于,它不仅证明了GP-UCB在合成环境中的优势,还展示了其在真实业务约束下的可操作性。
论文没有披露具体的效率提升数值,但强调了“统计显著”这一结论。对于实践者而言,这意味着GP-UCB可以作为黑盒杠杆优化的一种可靠选择,尤其是在反馈延迟、噪声大、调整受限的场景中。
对实践者的启示
如果你正在处理类似的资源分配问题——比如广告预算分配、推荐系统流量调控、或任何需要在离散动作空间中进行序贯决策的场景——GP-UCB提供了一条值得考虑的路径。关键点在于:不要独立对待每个动作,而是利用动作之间的结构相似性来加速学习。复合核函数的选择(Matérn + Linear)在稳健性上表现突出,可以作为默认起点。当然,部署前需要在模拟器中针对你的具体环境进行校准,因为核函数的表现可能因环境特性而异。
论文的另一个启示是方法论上的:从模拟器到生产RCT的完整验证链条,是工业级Bandit算法落地的标准范式。先在高保真模拟中快速迭代核配置,再用RCT在生产中确认效果,这种组合既控制了风险,又保证了结论的可信度。
相关推荐
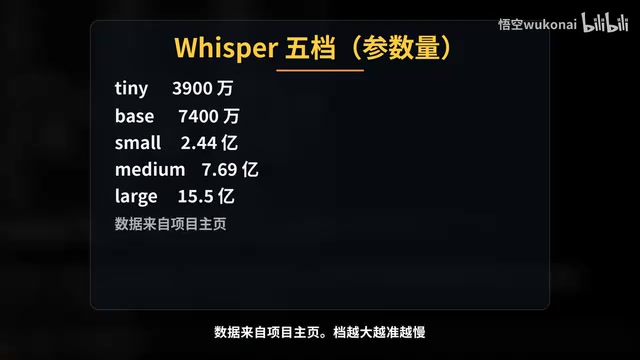
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
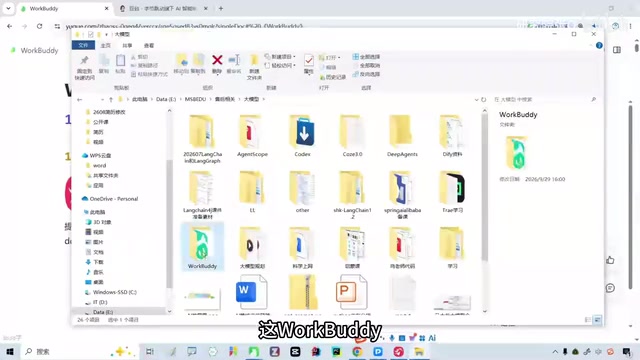
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。