高斯泼溅EBM:AUROC媲美kNN密度估计,推理快3.9倍

高斯泼溅EBM在文本异常检测中与kNN密度估计AUROC打平,但评分更快、内存恒定且支持生成与组合。
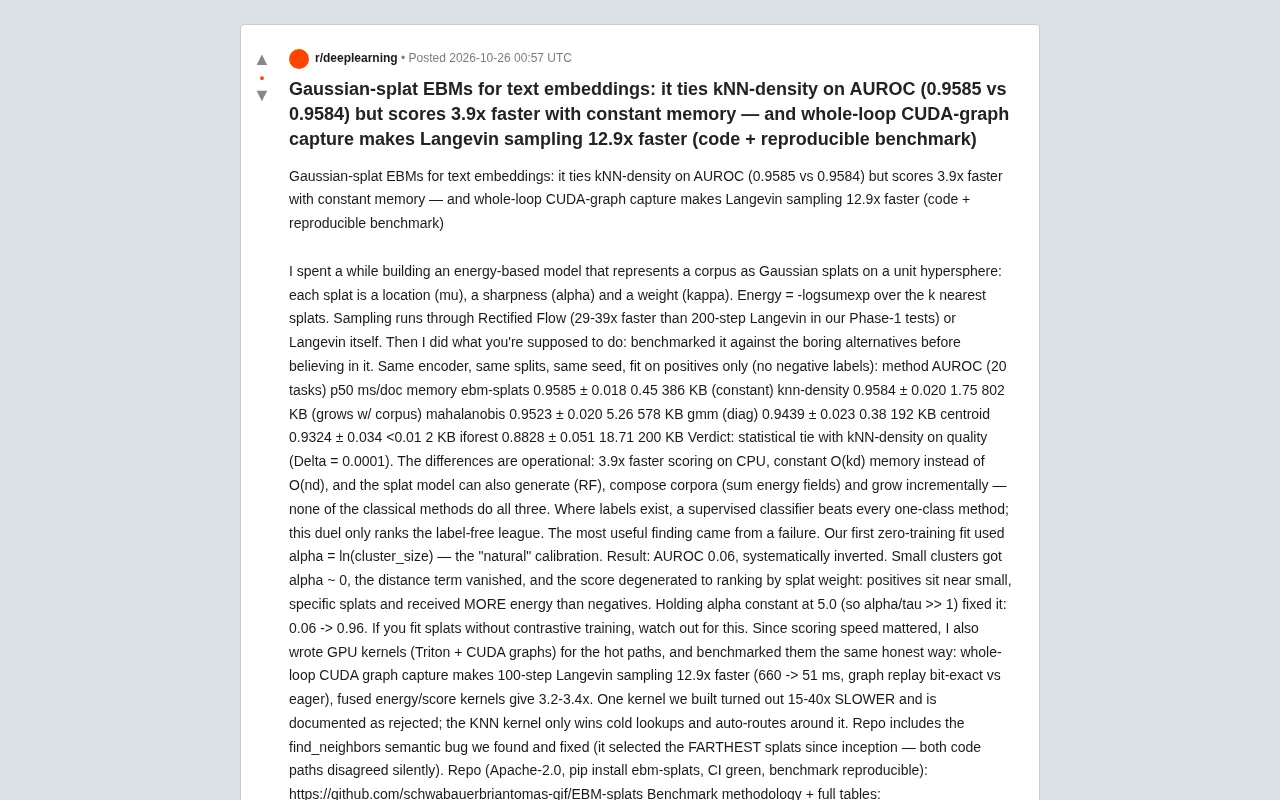
开发者构建的高斯泼溅能量模型(Gaussian-splat EBM)在20项文本嵌入异常检测任务上,AUROC与经典kNN-density几乎持平(0.9585 vs 0.9584),但评分速度快3.9倍、内存占用恒定且不随语料增长。模型将语料表示为球面上的高斯泼溅,通过logsumexp聚合最近邻能量,支持Rectified Flow和Langevin两种采样方式,具备生成、语料组合和增量生长能力。基准测试还揭示了一个关键失败:初始alpha校准导致AUROC仅0.06,固定alpha=5.0后修复至0.96。GPU内核优化方面,CUDA图捕获使100步采样加速12.9倍,融合内核加速3.2-3.4倍。代码以Apache-2.0开源,包含可复现基准和已修复的语义错误。
在文本嵌入的异常检测领域,基于密度的经典方法(如kNN密度估计)长期占据主导地位。但一位开发者构建的高斯泼溅能量模型(Gaussian-splat EBM)在20项任务上的AUROC与kNN-density几乎持平(0.9585 vs 0.9584),却在评分速度、内存占用和功能扩展性上展现出明显优势。这一结果来自Reddit上分享的完整基准测试,代码与可复现实验均已开源。
模型设计:球面上的高斯泼溅能量场
该模型将整个语料库表示为嵌入空间中的一组高斯泼溅。每个泼溅由三个参数定义:位置(mu)、锐度(alpha)和权重(kappa)。能量函数定义为对最近的k个泼溅做logsumexp运算的负值。这种设计使得模型能够以紧凑的参数存储整个分布,而不需要保留全部原始嵌入。
采样支持两种方式:Rectified Flow和Langevin动力学。据开发者报告,在Phase-1测试中,Rectified Flow采样比200步Langevin快29-39倍。这种生成能力是kNN-density等传统方法所不具备的。
能量模型(EBM) 是一类通过能量函数为数据点分配标量值的生成模型,能量越低表示样本越可能来自真实分布。与传统概率模型不同,EBM 无需显式归一化常数,训练和采样常借助 Langevin 动力学等马尔可夫链方法。本文的高斯泼溅 EBM 将每个泼溅视为嵌入空间中的局部能量井,通过 logsumexp 聚合最近邻泼溅的能量,从而以紧凑参数表示整个语料分布。这种设计使模型既能作为单类分类器进行异常评分,又保留了生成和组合能力。
logsumexp 是一种平滑的最大值近似操作,定义为 (\log \sum_i \exp(x_i))。在能量函数中,对最近 k 个泼溅的能量做 logsumexp 负值,相当于取这些泼溅能量的软最小值,使得评分对局部密度变化敏感且数值稳定。相比硬取最小值,logsumexp 可微且避免梯度消失,适合基于梯度的采样和优化。
Rectified Flow 是一种基于常微分方程(ODE)的生成采样方法,通过将噪声分布与数据分布之间的直线路径进行修正,实现少步数高质量采样。与 Langevin 动力学需要数百步迭代不同,Rectified Flow 通常只需几十步甚至几步即可生成样本,因此在本工作中实现了 29-39 倍的加速。Langevin 动力学则是一种基于随机梯度下降的采样方法,通过向能量梯度中注入噪声来探索分布,理论上收敛到目标分布但速度较慢。两者结合使模型既能快速生成,又能精确采样。
基准测试:统计平局,但运营优势显著
开发者使用相同的编码器、数据划分和随机种子,仅用正样本拟合(无负标签),在20项任务上对比了多种单类方法。以下是关键结果:
| 方法 | AUROC (20任务) | 每文档中位耗时 (ms) | 内存占用 |
|---|---|---|---|
| ebm-splats | 0.9585 ± 0.018 | 0.45 | 386 KB(恒定) |
| knn-density | 0.9584 ± 0.020 | 1.75 | 802 KB(随语料增长) |
| mahalanobis | 0.9523 ± 0.020 | 5.26 | 578 KB |
| gmm (diag) | 0.9439 ± 0.023 | 0.38 | 192 KB |
| centroid | 0.9324 ± 0.034 | <0.01 | 2 KB |
| iforest | 0.8828 ± 0.051 | 18.71 | 200 KB |
从质量上看,ebm-splats与kNN-density的差异仅为0.0001,属于统计平局。但运营层面的差异更为关键:CPU评分速度快3.9倍,内存复杂度为O(kd)而非O(nd),这意味着内存不随语料规模增长。此外,泼溅模型还支持生成(通过Rectified Flow)、组合多个语料(能量场相加)和增量生长,而经典方法无法同时做到这三点。
需要明确的是,当存在标签时,有监督分类器会击败所有单类方法。这项对比仅针对无标签场景下的方法排名。
一个失败带来的关键教训
最有价值的发现来自一次失败。开发者最初采用alpha = ln(cluster_size)作为“自然”校准,结果AUROC仅为0.06,系统性地反转了。原因在于:小簇的alpha趋近于0,距离项消失,评分退化为按泼溅权重排序。正样本靠近小而具体的泼溅,反而获得了比负样本更高的能量。
将alpha固定为5.0(使alpha/tau远大于1)后,AUROC从0.06跃升至0.96。开发者提醒:如果在没有对比训练的情况下拟合泼溅,必须警惕这一陷阱。
AUROC(Area Under the Receiver Operating Characteristic Curve)是异常检测中常用的评估指标,衡量模型在不同阈值下区分正负样本的能力。AUROC 为 0.5 表示随机猜测,1.0 表示完美区分。当 AUROC 低于 0.5 时,说明模型系统性地将正负样本评分反转,即正样本获得了比负样本更高的异常分数。本文中 alpha 校准失败导致 AUROC 仅 0.06,正是典型的评分反转现象,提示模型参数设置对排序方向有决定性影响。
GPU内核优化:CUDA图捕获与融合内核
由于评分速度至关重要,开发者还为热点路径编写了GPU内核(Triton + CUDA图),并进行了同样诚实的基准测试。
全循环CUDA图捕获使100步Langevin采样加速12.9倍(从660毫秒降至51毫秒),图重放与即时执行逐位精确一致。融合的能量/评分内核带来3.2-3.4倍的加速。
并非所有尝试都成功:一个构建的内核最终慢了15-40倍,已被记录为拒绝方案;KNN内核仅在冷查找时胜出,系统会自动路由绕过它。
CUDA 图捕获 是一种将一系列 GPU 内核启动及其参数打包成单个图结构的技术,通过一次提交即可重放整个计算序列,从而消除多次内核启动的 CPU 开销和驱动延迟。对于包含大量小内核的迭代算法(如 Langevin 采样),图捕获能显著提升吞吐量。本文中全循环 CUDA 图捕获将 100 步采样从 660 毫秒降至 51 毫秒,且图重放与即时执行逐位精确一致,证明了该技术在不改变数值结果的前提下实现大幅加速的可靠性。
开源代码与可复现性
仓库以Apache-2.0协议开源,可通过pip install ebm-splats安装,CI通过,基准测试可复现。开发者还记录并修复了一个名为find_neighbors的语义错误:该函数自诞生起就选择了最远的泼溅,两条代码路径静默地不一致。
仓库地址:https://github.com/schwabauerbriantomas-gif/EBM-splats
基准测试方法论与完整表格见benches/ONECLASS_DUEL_RESULTS.md,内核对比见benches/bench_headtohead.py。
为何保留这个“仅仅打平”的模型
尽管在AUROC上与kNN-density打平,开发者仍选择保留该模型,原因在于运营优势:恒定内存、更快评分、生成与组合能力。这些特性使得模型在实际系统中更具扩展性和灵活性。对于需要增量更新、多语料组合或生成采样的场景,高斯泼溅EBM提供了经典方法无法覆盖的能力。
这一工作也展示了诚实基准测试的价值:通过公开失败案例和拒绝方案,为社区提供了可复用的经验教训。
相关推荐

私钥设为4?CA机构低级错误致TLS体系裸奔
CA机构eMudra将私钥设为数字4等极小值,导致TLS证书可被暴力破解。Computerphile视频演示了从提取公钥到伪造证书的完整过程,并探讨了PKI信任链的脆弱性。

Gen如何用ChatGPT Work把数据变决策
OpenAI用户案例中,企业领导者Gen分享用ChatGPT Work将数据转化为决策的实践:产品上线几小时内即可判断集成与引导流程是否有效,决策迭代从上百次试错变为快速反馈闭环。

ChatGPT与Claude深度对比:编程强但研究弱,如何弥补?
用户考虑从ChatGPT转向Claude,发现Claude编程更强但研究较浅。本文分析两者差异,并提供让Claude研究更深入的实用技巧,帮助您做出明智选择。