高温长文本生成崩溃?采样器才是关键

研究发现高温下采样器的候选池大小决定长文本生成成败,top-nsigma远优于top-p。
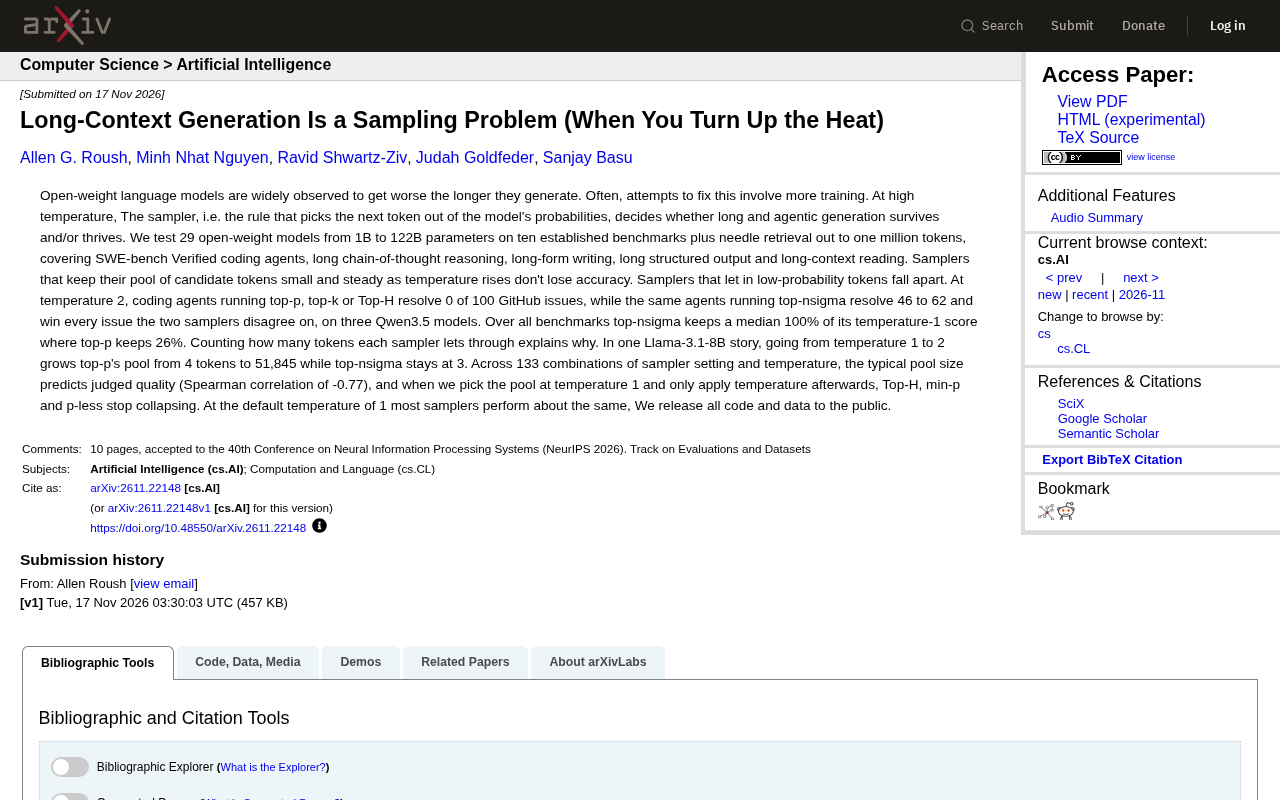
一项针对29个开源模型(1B至122B参数)的系统研究揭示,开放权重语言模型长文本生成退化未必源于模型能力不足,而可能与推理阶段的采样器选择密切相关。研究覆盖SWE-bench编码智能体、长链推理、长文写作、结构化输出与百万token针检索等场景,发现温度升高时,能维持候选token池小而稳定的采样器(如top-nsigma)不损失准确率,而允许低概率token进入候选池的采样器(如top-p、top-k、Top-H)表现急剧恶化。温度设为2时,top-p等在100个GitHub issue中解决数为0,top-nsigma则解决46至62个。候选池大小与生成质量的Spearman相关系数为-0.77。默认温度1下多数采样器表现相近,差异只在高温探索场景中凸显。
开放权重语言模型在生成长文本时表现变差,这几乎是共识。但常见的应对思路——加大训练量——可能忽略了推理阶段的一个关键变量:采样器。近期一项研究系统测试了29个开源模型(1B到122B参数),在十个基准任务以及百万token级别的针检索任务上,揭示了采样策略与长文本生成质量之间的强关联。
采样器如何决定长生成的成败
研究覆盖了SWE-bench Verified编码智能体、长链思维推理、长文写作、长结构化输出和长上下文阅读等场景。核心发现是:随着温度升高,那些能够保持候选token池小而稳定的采样器,不会损失准确率;而允许低概率token进入候选池的采样器,表现会急剧恶化。
在温度设为2时,使用top-p、top-k或Top-H的编码智能体在100个GitHub issue中解决数为0;而同样条件下,top-nsigma解决了46到62个,并且在两个采样器意见不一致的issue上全部获胜(基于三个Qwen3.5模型)。跨所有基准,top-nsigma保持了温度1时成绩的中位数100%,而top-p仅保持26%。
温度(temperature)与采样器的关系
温度是语言模型解码时对 logits 分布进行缩放的超参数:温度 T 将原始 logits 除以 T 后再做 softmax。T<1 使分布更尖锐(更确定、更保守),T=1 保持模型原始分布,T>1 则使分布更平坦,让原本低概率的 token 获得更多被选中的机会。因此温度本身并不直接决定采样结果,它改变的是概率分布的形态,而真正的"筛选规则"由采样器承担。
常见的采样器包括:top-k(只保留概率最高的 k 个 token)、top-p / nucleus sampling(保留累计概率达到 p 的最小 token 集合)、min-p(保留概率不低于最高概率某比例的 token)、Top-H(基于熵动态确定候选集大小)以及本文讨论的 top-nsigma(按与均值的标准差倍数确定候选池)。不同采样器在温度升高时的行为差异很大:有些会把候选池迅速扩张到数万个 token,有些则能维持在小规模稳定集合。这正是本文发现"采样器决定长生成成败"的机制基础——温度只是放大器,候选池的实际大小才是直接作用于生成质量的因素。
候选池大小解释了崩溃原因
研究通过统计每个采样器放行的token数量,给出了直观解释。在一个Llama-3.1-8B的案例中,温度从1升到2,top-p的候选池从4个token膨胀到51,845个,而top-nsigma始终保持在3个。
在133种采样器设置与温度的组合中,典型候选池大小可以预测评判质量,Spearman相关系数为-0.77。更关键的是,如果在温度1时确定候选池,之后再调整温度,Top-H、min-p和p-less不再出现崩溃。
Spearman 相关系数的含义
Spearman 秩相关系数是一种非参数统计量,用于衡量两个变量单调关系的强弱,取值在 -1 到 +1 之间。它不要求数据服从正态分布,也不假设线性关系,而是先把两组观测值分别转换为排名(秩),再计算秩之间的 Pearson 相关。本文报告候选池大小与评判质量的 Spearman 相关系数为 -0.77,意味着二者存在很强的负向单调关系:候选池越大,生成质量排名越靠后。这一数值接近 -1,说明仅凭候选池大小这一个简单统计量,就能相当准确地预测不同采样器配置下的质量排序,而无需依赖复杂的模型内部指标。对于工程实践而言,这意味着可以把"温度升高时候选池是否膨胀"作为选择采样器的快速诊断信号。
默认温度下的表现与启示
在默认温度1下,大多数采样器表现相近,这意味着日常使用中采样器的影响被掩盖。但一旦提高温度以增加多样性或探索性,采样器的选择就变得至关重要。
这项研究传递出一个明确信号:长上下文生成退化不一定是模型能力不足,采样策略可能是更直接、更低成本的干预点。团队已公开所有代码和数据。对于依赖高温采样的智能体应用,重新审视采样器设计,或许比追加训练更有效。
相关推荐
通往轨道的路:发射巨构如何终结火箭时代
从质量驱动器、天钩、发射环到轨道环,SFIA 长视频系统梳理通往轨道的发射巨构谱系,揭示交通量如何决定技术选择,以及这些方案为何终将拼成一张运输网络而非彼此竞争。
戈登·拉姆齐对决米其林父子:加利西亚美食寻味记
戈登·拉姆齐深入西班牙加利西亚,与米其林两星主厨佩佩·维埃拉展开美食对决。从死亡海岸的鹅颈藤壶到传统石炉面包,探索加利西亚独特的饮食文化与食材故事。

Soundcore Liberty 5 Pro降至历史低价:通勤通话首选真无线耳机
Soundcore Liberty 5 Pro真无线耳机降至129.99美元历史低价,原价169.99美元。这款Anker旗下声阔耳机以通话质量见长,在Amazon、Best Buy和Walmart同步促销,提供四种配色,适合通勤和线上会议用户。