高校GPU排队3天,实习生偷用公司算力搞科研可行吗

高校GPU排队3-4天,实习生想借公司算力跑论文,社区共识是别偷跑但可以去谈。
一位PhD学生在Reddit吐槽学校GPU集群排队要3到4个工作日,而实习公司的算力却闲置,于是发问能否用公司GPU跑自己的学术研究。文章指出,这轮高校算力荒源于生成式AI爆发后GPU需求整体抬高,而高校采购流程缓慢,老卡扛新负载,学生迭代周期被拉长十倍。公司算力在技术上与学术实验高度重合,但多数平台有审计日志,任务用途、时长和数据流向会被记录,私自使用风险不小。评论区形成两种立场:反对者强调实习合同的资源使用条款风险不对等,支持者建议走正式沟通,把算力使用变成有记录的协作,甚至让公司以合作方身份换取署名或致谢。文章还给出争取校内优先级、申请外部学术算力计划、用量化和梯度检查点压缩实验需求等务实建议,强调核心不是不能碰公司算力,而是有没有事先获得明确授权。
“我们学校的GPU集群已经变成度假村了——提交一个只要两块GPU的任务,光排队就要等3到4个工作日。”这是一位Reddit上PhD学生的原话。更让他坐不住的是,实习公司的算力集群就摆在眼前,空着也是空着,于是他在论坛上抛出了一个近似于“自首”的问题:能不能用实习公司的GPU跑自己的学术研究?
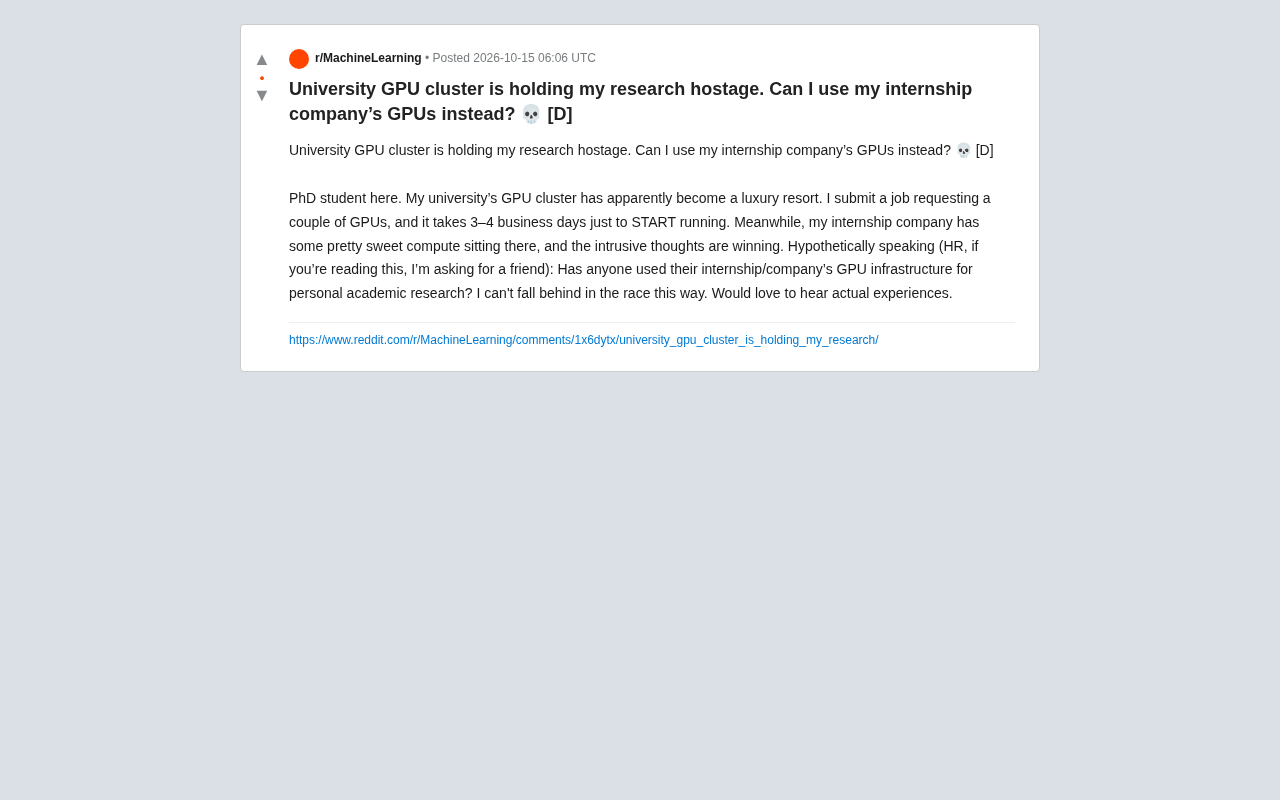
帖子被标注为[D](Discussion),讨论热度不低。我翻完了评论区和相关讨论,发现这不是一个孤立的吐槽,而是学术圈算力供需失衡的一个切面。
高校GPU集群为什么突然不够用了
这轮排队潮和2023年生成式AI爆发后的算力挤兑是同一根链条。大模型训练把GPU需求的基准线整体抬高了:H100、A100的现货价格和租赁价格一路走高,高校采购预算根本追不上。
一位在评论区自称做系统管理的用户提到,他们学校集群里V100和A100的利用率常年维持在九成以上,但采购新卡要经历预算审批、招标、到货安装的漫长流程,一年能落地一批已经算快。结果是老卡扛着新负载,排队时间从“小时级”滑向“天级”。
这种背景下,学生的时间成本被直接拉长。一个需要反复调参的实验,如果每次都要等3天起步,迭代周期会被拉长十倍。对赶毕业、赶投稿的博士生来说,这种等待比算力不够本身更致命。
H100 与 A100 是什么
H100 和 A100 是 NVIDIA 面向数据中心的两代旗舰计算卡,也是这轮高校算力荒中被反复提及的两款硬件。A100 于 2020 年发布,采用 Ampere 架构,配备 40GB 或 80GB HBM2e 显存,是 ChatGPT 之前大模型训练的主力硬件;H100 于 2022 年发布,采用 Hopper 架构,配备 80GB HBM3 显存,并针对 Transformer 类结构加入了 FP8 计算和专用加速单元,训练同规模模型的吞吐普遍能达到 A100 的数倍。
两者在高校集群中的意义不只是性能差异,更在于可获得性。A100 曾经是多数高校能负担得起的“标配”,但在生成式 AI 爆发后,云厂商和大企业大量扫货,现货价格和租赁价格被整体抬高。H100 则因为产能和出口管制等因素,单卡价格长期维持在高位,一批采购往往就要消耗掉整个院系数年的设备预算。这直接解释了评论中提到的现象:学校只能用 V100、A100 这些老卡继续扛新负载,而新卡到货周期被拉长到以年为单位。
公司GPU算力的灰色吸引力
实习生能接触到公司算力,通常是因为团队本身在做模型训练或推理服务,手上有闲置或弹性资源。从纯技术角度看,跑学术实验和跑业务任务对GPU的要求高度重合,迁移摩擦很低。
问题出在权限和合规上。评论区里有一位在大厂做基础设施的工程师补充了一个关键细节:多数公司的算力平台都有审计日志,绑定了员工账号的任务会被记录用途、时长和数据流向。如果实验数据涉及论文中未公开的成果,或者跑的是和公司业务无关的模型,日志里会留下清晰痕迹。
换句话说,技术上能跑通,不等于安全能落地。
审计日志为什么能“锁定”用途
评论区提到的审计日志,指的是企业算力平台对每一次任务提交自动记录的元数据,通常包括提交账号、任务启动与结束时间、占用的 GPU 型号和数量、容器镜像、命令行参数,以及在条件允许时记录的数据挂载路径和网络出口。这些日志的设计初衷是成本分摊、故障排查和安全审计,但客观上形成了一条可追溯的证据链。
对实习生来说,风险点不在于“跑了一次任务”这个动作本身,而在于日志中留下的语义信号:任务名里出现论文相关关键词、挂载的数据集来自个人存储、运行时段集中在非工作时段、模型结构与公司业务毫无关联。任何一条异常都可能在季度审计、离职审查或安全事件复盘时被单独调出来。更关键的是,这类日志通常由平台团队而非直属主管掌握,实习生往往意识不到自己留下的痕迹会被谁在什么场景下查看,这也是“技术能跑通、安全难落地”的根源。
学术圈的隐形规则:公司算力换作者署名?
评论中形成了两种主要立场,分歧相当明确。
第一种是“别拿,风险不对等”:一旦被公司发现,轻则失去实习机会,重则触及学术诚信和公司合规问题。有用户直接指出,实习合同里几乎都有“公司资源仅用于公司业务”的条款,用公司GPU跑个人学术项目属于典型的条款覆盖盲区——你没被授权,就默认禁止。
第二种是“可以谈,但要走明路”:建议学生主动和公司导师、学术导师分别沟通,把“用公司算力跑论文实验”变成一个有正式记录的协作。如果论文方向与公司业务沾边,甚至可以考虑让公司作为合作方参与,把算力投入换成一个合作署名或致谢。
这后一条路径在工业界实验室里其实是有先例的。据多位做过产研合作的研究者反馈,公司与高校的联合研究项目里,公司提供算力和数据、高校提供人力和理论,署名规则在项目启动前就会谈清楚,避免事后扯皮。
联合研究与署名规则的基本约定
在正规的产研合作中,算力、数据和署名之间的对应关系一般会在项目启动前以合同或合作备忘录的形式固定下来。常见的做法是:公司提供算力额度和可能的数据接口,高校团队负责方法设计和实验执行,论文的通讯作者通常由高校导师担任,公司一侧的对接人视贡献程度进入作者列表或致谢部分。有些企业还会要求在投稿前进行一轮内部合规审查,确认论文中不包含敏感数据或业务信息。
这套流程的核心逻辑是“贡献可追溯、授权可举证”。学生如果想把公司算力用于论文实验,最稳妥的路径就是把自己嵌入到这样一个已有的合作框架里,而不是依赖个人账号的灰色操作。即便最终只是致谢而非署名,一份由双方导师确认的算力使用说明,也足以在事后审计或学术诚信核查时提供保护。相比之下,口头允许或默认不追究,在论文公开后几乎起不到任何防护作用。
高校算力荒下,学生能做的几件事
抛开灰色地带,这位PhD学生的困境在学术圈其实已经催生了一些更稳妥的应对方式。
其一是争取校内的优先级。不少高校集群对“即将投稿”或“毕业冲刺”的任务有加速通道,只是信息不透明,需要主动问系里或集群管理员。评论区有用户分享了自己通过导师出面申请临时额度的经历。
其二是借用学术合作方的算力。国内外的超算中心、国家实验室、以及一些企业开放的学术算力计划,都提供面向高校研究者的免费或低价额度,申请门槛不算高,只是周期较长。
其三是把实验做得更省卡。4-bit量化、梯度检查点、小规模代理模型预实验,这些手段能在排队期间把实验的GPU需求压下来,等真正拿到卡时减少试错次数。
一个没有标准答案的问题
这位PhD学生最后收到的最多回复,可以概括成一句话:不要偷跑,但可以去谈。
公司算力不是不能碰,关键在于有没有事先获得明确授权,以及授权范围是否覆盖你的学术用途。偷偷跑一次也许没人发现,但一旦论文进入公开发表流程,或者实验数据触及公司敏感边界,这件事的性质会立刻改变。
高校GPU排队的结构性压力短期内不会消失。在算力真正变便宜之前,学生需要的可能不只是更快排队,而是一套能在合规框架内调动外部资源的沟通能力。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。