个人数据训练15个血糖预测模型:一次硬核的自我量化实验
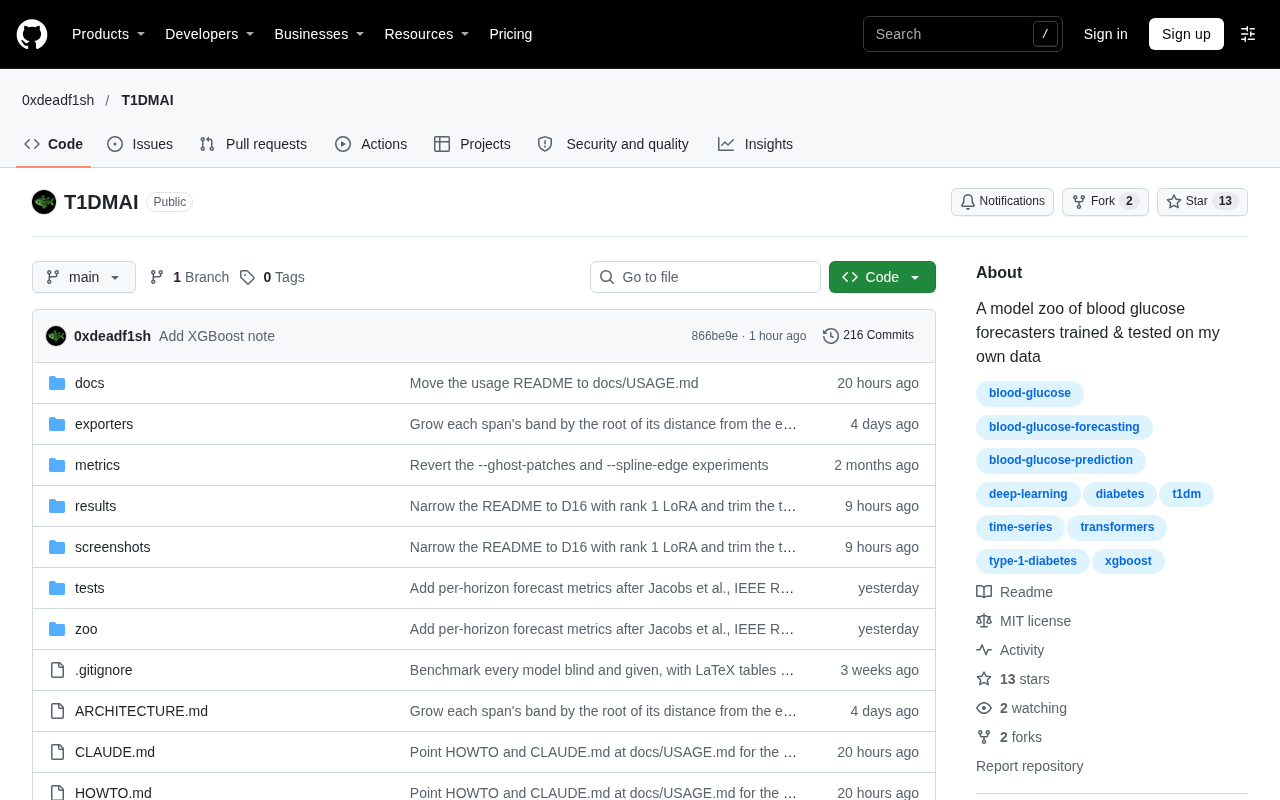
开发者用个人CGM数据训练15个血糖预测模型,展示自我量化从记录走向预测的工程模板。
一位开发者在Hacker News分享用个人连续血糖监测(CGM)数据训练15个血糖预测模型的项目,引发对个体用机器学习预测自身生理数据的关注。文章指出,CGM让分钟级血糖曲线变得可获取,但血糖受饮食、运动、药物等多因素影响,仅凭历史序列预测存在明显上限。个人数据的优势在于捕捉高度个性化的模式,代价是样本量有限、过拟合风险高,交叉验证设计尤为关键。作者认为,这类草根实验的示范意义大于热度,但个人模型不具备医疗诊断价值,未来值得探索多模态特征融合、预测时长取舍与可解释性等方向。
一位开发者在Hacker News的Show HN板块分享了自己的项目:他用个人连续血糖监测(CGM)数据训练了15个血糖预测模型。这条帖子本身信息量有限,但它触及了一个正在升温的趋势——个体用机器学习工具对自己的生理数据做预测建模,把“自我量化”从记录推进到预测。
从记录到预测:自我量化的下一步
过去几年,连续血糖监测设备的普及让普通人能够以分钟级的粒度获取血糖曲线,不再只依赖指尖血和糖化血红蛋白这类滞后指标。数据有了,问题就变成:这些曲线能否被用来预测未来?
这位作者的答案是训练模型。15个模型不是一个小数目,它意味着系统性的横向对比,而不是随便跑一个回归。对于个人项目而言,这种“多模型基准测试”的思路本身值得注意——它把医学预测问题当作工程问题来处理:准备数据、切分训练与验证集、对比不同算法的误差。
连续血糖监测(CGM)通过植入皮下的微型传感器,每隔数分钟测量组织液中的葡萄糖浓度,并将数据实时传输到手机或接收器。与传统指尖采血只能获取离散时间点不同,CGM 能生成全天候的血糖曲线,揭示夜间低血糖、餐后峰值等容易被遗漏的动态。临床上,CGM 已被用于评估血糖波动性和指导胰岛素调整;而在个人量化社区,它成为可被导出、分析与建模的生理数据源。理解 CGM 数据的采样频率、延迟与噪声特性,是判断血糖预测模型可行性的前提。
为什么血糖预测特别难
血糖不是一条平滑的时间序列。它受饮食成分、进餐时间、胰岛素或药物、运动强度、睡眠、压力乃至个体差异的共同影响,而这些变量里有很多在CGM数据中根本不存在。仅凭历史血糖值做外推,模型能捕捉到短期趋势,却很难预判一次碳水摄入带来的陡升。
这解释了为什么“15个模型”这个数字既是亮点也是局限:模型数量多,说明作者在算法层面做足了功夫;但如果特征工程只依赖血糖序列本身,模型之间的差距可能远小于数据的限制。真正决定预测上限的,往往是输入里有没有餐食、胰岛素和活动数据。
过拟合是指模型在训练数据上表现很好,却无法泛化到新数据上的现象。在个人血糖预测场景中,由于单个体的数据天数有限,15 个模型很容易记住训练集里的偶然波动而非真实规律。交叉验证是缓解过拟合的常用手段:将时间序列按时间顺序切分为多段,轮流用一部分训练、另一部分验证,从而更可靠地估计模型在未见数据上的误差。对于血糖这类具有强时间依赖的数据,还需要避免随机切分造成的信息泄漏——即未来数据混入训练集,导致评估结果虚高。
个人建模的独特价值
与学术研究相比,个人项目有它在数据上的优势。公开的糖尿病数据集通常样本量大但个体间差异被平均掉,而单一个体的长期CGM数据能捕捉到非常个性化的模式——某个人对特定食物的反应、夜间血糖的稳定区间、运动后的延迟效应。用作者自己的话说,模型是在“自己的数据”上训练的,这天然避开了跨个体泛化的问题。
代价是样本量。单一个体的数据天数有限,15个模型在这样的数据上很容易过拟合,交叉验证的设计就显得关键。原帖没有披露具体的评估方法,这也是社区通常会追问的地方。
开源与分享的溢出效应
这条帖子只有寥寥数点,但它的示范意义大于热度。把血糖预测做成一个可复现的个人项目,意味着更多糖尿病患者或健康关注者可以照着思路尝试:导出CGM数据、构造特征、跑几个基线模型。相比等待商业产品,这种草根实验积累的经验往往更直接。
当然,需要明确的边界是:个人训练的预测模型不具备医疗诊断价值,不能替代医生建议。它的意义在于帮助个体理解自己的血糖动态,而不是做出治疗决策。
值得关注的几个方向
从这类项目可以延伸出几条有价值的路径。一是多模态特征融合:把饮食记录、胰岛素剂量、运动手环数据接入模型,通常会比纯血糖序列带来质的提升。二是预测时长的取舍:预测15分钟和预测60分钟是完全不同的问题,前者更可行,后者更有临床意义。三是可解释性:比起只给出一个预测值,告诉用户“模型认为接下来会上升是因为刚才的碳水”,对自我管理更有帮助。
这位开发者的15个模型是一个起点,它展示了一个模板:用公开工具和自有数据,把健康预测从概念变成可以亲手验证的东西。
可解释性(Explainable AI)指让模型的预测逻辑对人类可理解,而非仅输出一个黑箱数值。在血糖预测中,可解释性意味着模型能指出哪些输入特征(如上一餐碳水、胰岛素剂量、近期运动)对预测上升或下降贡献最大。常用的方法包括特征重要性排序、局部解释(如 SHAP 值)以及注意力权重可视化。对个人健康管理而言,可解释的预测比单纯准确的预测更有行为指导价值,因为它能帮助用户建立“什么导致我的血糖变化”的因果直觉。
相关推荐

智能体与工作流:LangGraph 工作流编排的核心概念解析
基于B站老肖的LangGraph教程,解析工作流与智能体的本质区别:编排权归属、复杂业务选型、StateGraph三大组件及构建流程,帮助开发者合理选择架构方案。
LangGraph工作流与智能体:企业级AI编排新解
LangGraph工作流与智能体的核心区别是什么?本文解析状态图三要素(状态、节点、边),探讨工作流如何编排复杂AI业务,以及LangChain 1.0企业级应用中的协同策略。

4个习惯正在偷走你的Claude Code额度(附诊断提示词)
Claude Code额度消耗过快?本文拆解4个常见烧额度习惯:模糊需求、冗长日志、随意开子代理、长会话不切换。附一个能扫描最近七天日志、自动找出你个人耗电前三名的提示词,并给出针对性修正规则。