给AI Agent加上「情景记忆」:CtxVault开源记忆层解析

CtxVault为Agent新增带双时间轴的情景记忆,让事实变迁可追溯、可审计。
CtxVault是MIT协议、本地运行的Agent记忆层,在语义记忆和技能记忆之外新增情景记忆。每条事实携带「现实为真时间段」与「记忆学习时间」两个日期,并提供supersede、revise、invalidate、confirm、dispute五个原语,保留事实变迁历史、标记冲突而不强行裁决。其核心能力是valid_at与known_at双时间轴查询,能区分「当时世界为真」与「当时记忆已知」。项目通过MCP标准协议接入LangGraph,服务端按--agent参数做vault级访问控制。当前不支持图记忆、文件系统自动同步和对话事实自动抽取,作者对是否增加抽取层仍在权衡。
为什么Agent需要「情景记忆」
长期运行的AI Agent有个尴尬的现实:它记不住自己曾经相信过什么。一个事实改变了,Agent在记忆里直接覆盖旧值,一个月后没人能说清它当时是怎么想的、为什么那么做。向量存储没有「这条为真直到四月」的概念——这正是Reddit用户Filippo Venturini在其开源项目CtxVault中试图解决的问题。
CtxVault是一个MIT协议、本地运行的Agent记忆层。作者此前发布过只含语义记忆和程序性记忆的版本,这次补上了第三种:情景记忆(episodic memory)。它的核心不是存更多,而是存「时间」。
情景记忆(episodic memory) 这一概念源自认知科学,指对特定时间、地点和情境下发生事件的记忆,与存储一般知识的语义记忆相对。在AI Agent语境下,情景记忆特指记录「某个事实在何时为真、又是何时被系统习得」的时序化记忆结构。它与传统向量数据库的关键差异在于:向量库通常只保留最新状态,旧值被覆盖后无法追溯;而情景记忆为每条事实附加有效时间区间和记录时间戳,支持对历史状态的查询与审计,从而让Agent的决策过程可解释、可复盘。
三种记忆,一套文件夹
CtxVault把所有记忆组织成一组文件夹,称为「vaults」,每个vault属于三种类型之一:
- 语义记忆(semantic):文档、本地嵌入、按含义检索。
- 技能记忆(skill):Markdown写成的流程说明,Agent按名字读取。
- 情景记忆(episodic):带有两个日期的事实——它在现实世界中为真的时间段,以及记忆学习到它的时间。
作者最在意的是第三种。它让「当时为真」和「当时已知」成为两个可以分别查询的维度,而不是一个被反复覆盖的当前状态。
情景记忆的五个原语
CtxVault为情景记忆设计了几个操作原语,覆盖事实变迁的常见模式:
- supersede(取代):事实变了。旧事实在新事实起点处关闭,两条都保留并建立链接。
- revise(修订):世界没变,只是措辞变了。新文本继承旧文本的确认记录。
- invalidate(失效):某日起不再为真,没有替代者。
- confirm(确认):第二个来源同意,事实权重提高。
- dispute(争议):两个来源冲突,两条都保持开放并标记,不强行选边。
这套原语的价值在于可审计。Agent做决策时依据的是哪一版事实、来自几个来源、是否存在未解决的冲突,都能回溯,而不是只看到一条被覆盖后的最终值。
双时间轴查询:valid_at 与 known_at
情景记忆真正的杀手锏是两种时间查询:
valid_at="2026-03-02":那天世界上什么是真的?known_at="2026-03-02":那天记忆知道什么?
这两个问题经常给出不同答案,而传统向量库根本无法区分。比如某条政策在三月生效但系统四月才学到,用valid_at查三月能拿到正确事实,用known_at查三月则应该返回「当时还不知道」。对需要复盘或合规审计的Agent场景,这个区分相当关键。
底层实现上,CtxVault在vault文件夹内放一个SQLite文件,没有引入额外服务依赖,保持了本地优先的定位。
双时间轴(bitemporal)建模 是数据库领域的成熟概念,指同时追踪数据的「有效时间」(valid time,事实在现实世界中为真的时段)和「事务时间」(transaction time,数据被录入系统的时刻)。CtxVault的valid_at与known_at分别对应这两个维度。这种模型能精确回答两类问题:某历史时点世界上什么是真的,以及某历史时点系统知道什么。二者常不一致,例如政策三月生效但系统四月才录入。双时间轴使Agent能区分「事实本身的变化」与「认知的滞后」,在合规审计、事后归因等场景中尤为关键。
接入LangGraph:走MCP,不写私有胶水
CtxVault与LangGraph的集成完全通过MCP完成,没有自定义适配层。示例代码用langchain_mcp_adapters加载工具,启动一个stdio MCP服务端,再把工具交给create_agent:
from langchain_mcp_adapters.tools import load_mcp_tools
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

params = StdioServerParameters(command="ctxvault-mcp", args=["--agent", "support-bot"])
async with stdio_client(params) as (r, w), ClientSession(r, w) as s:
    await s.initialize()
    tools = await load_mcp_tools(s)
    agent = create_agent(ChatOpenAI(model="gpt-4o-mini"), tools)
--agent参数是访问控制的锚点:每个vault声明哪些Agent可以访问,校验在服务端完成。这意味着两个Agent即使共享同一个记忆文件夹,也不能越权读到对方的vault。对多Agent协作场景,这是一个务实的安全边界。
MCP(Model Context Protocol) 是由Anthropic提出并开源的标准化协议,用于让AI应用以统一方式连接外部工具与数据源。它定义了一套客户端-服务端交互规范,支持stdio、HTTP等多种传输方式。在CtxVault的集成中,langchain_mcp_adapters充当桥梁,将MCP服务端暴露的工具自动转换为LangChain可调用的Tool对象,再交给create_agent构建Agent。这种设计的好处是解耦:记忆层只需实现MCP接口,就能被LangGraph、Claude Desktop等任何兼容MCP的宿主复用,无需为每个框架编写私有适配代码。
界面与现状
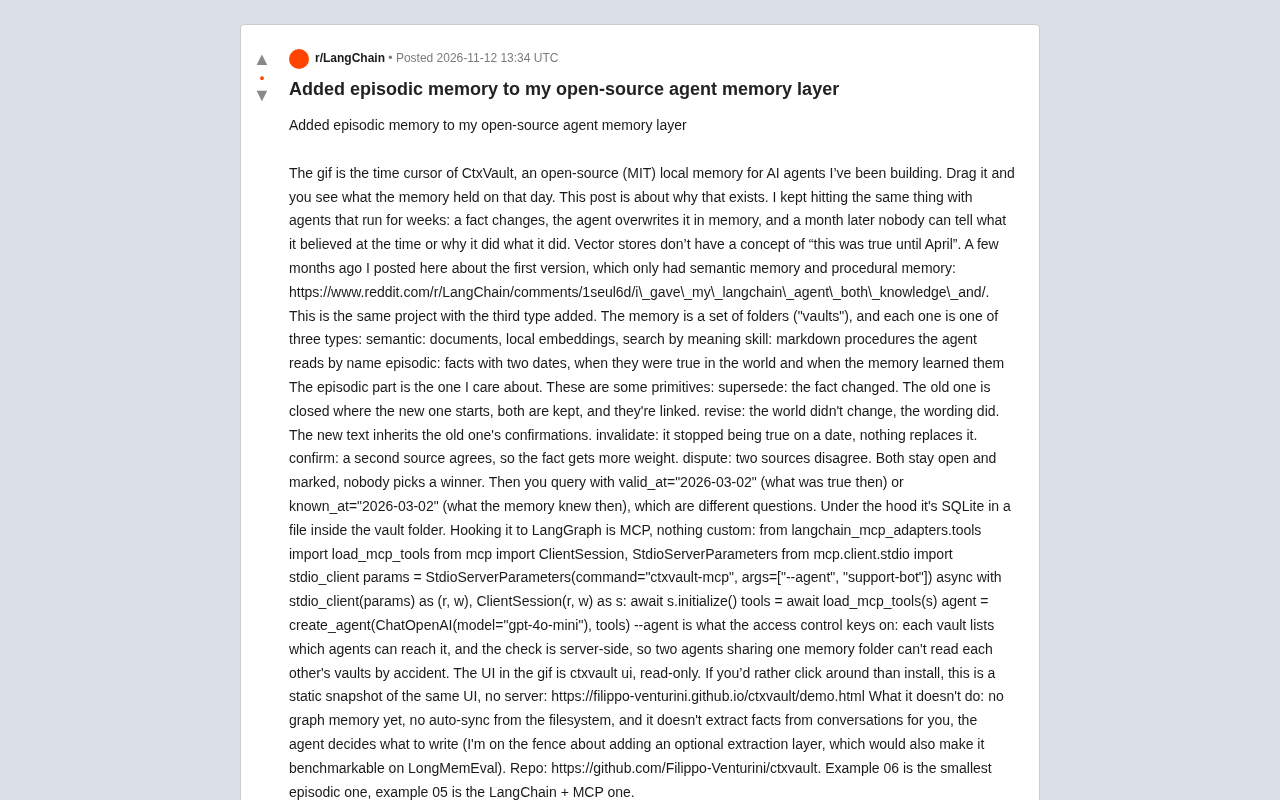
作者提供的UI即gif中的时间游标,拖动即可查看某一天记忆中存了什么,只读模式。不想安装的话,项目还提供了同一UI的静态快照,无需服务端即可点点看。
坦率地说,CtxVault目前的能力边界也很清晰:没有图记忆,没有文件系统自动同步,也不会自动从对话中抽取事实——写什么由Agent自己决定。作者对是否增加可选的抽取层仍在犹豫,因为那会让项目能在LongMemEval这类基准上被评测。这是个值得关注的取舍:自动抽取能提升可用性,但也会引入抽取错误和评测与真实使用之间的落差。
仓库地址为github.com/Filippo-Venturini/ctxvault,示例06是最小的情景记忆示例,示例05是LangChain + MCP集成示例。
LongMemEval 是一个专门评测长期记忆能力的基准数据集,包含多轮对话中的信息提取、多会话推理、时间推理、知识更新和 abstention(拒绝回答)等任务类型。它之所以被提及,是因为CtxVault当前不自动从对话中抽取事实,无法直接在该基准上端到端评测。若增加自动抽取层,项目就能参与此类基准比较,但也会引入抽取错误、评测指标与真实使用场景之间的偏差等新问题。这一取舍反映了Agent记忆系统在「可用性」与「准确性/可审计性」之间的普遍张力。
一点观察
Agent记忆正在从「更大的向量库」转向「更好的时间语义」。CtxVault的双时间轴和保留冲突的设计,思路更接近数据库领域的时间维度建模,而不是检索增强的放大版。对需要长期运行、事后可解释的Agent来说,这类原语可能比多存几百万条嵌入更有价值。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。