给DeepSeek Harness装记忆:OpenViking实测Token降91%

字节开源的OpenViking为AI编程工具提供文件系统式跨会话记忆,官方数据显示Token降幅34%-91%,但实测四成检索零命中。
DeepSeek Harness(DSH)等AI编程工具长期存在换会话即失忆的痛点,OpenViking通过将AI记忆组织为Agent/Resources/User三层文件系统,并引入L0摘要→L1概览→L2全文的渐进式加载机制,在官方测试中实现了输入Token下降34%-91%、Claude Code记忆准确率从57%升至80%的效果。然而,UP主在自己机器上的1257次实测显示,约40.3%的检索返回零结果,命中率高度依赖使用者对目录结构的合理组织。项目可通过插件或MCP协议接入DSH,开源且附带复现脚本,对深受失忆问题困扰的开发者而言是接入门槛较低的补丁方案,但并非装上即见效的银弹。
大模型的健忘症与OpenViking的解法
DeepSeek广告 Harness(下文简称DSH)是不少人日常使用的AI编程工具,但它有一个绕不开的痛点:换个会话就失忆。同一个项目,每开一次新对话都得从头把背景、目录结构、需求重新交代一遍,效率被反复的上下文重建拖垮。
针对这个问题,B站UP主给DSH接入了一个叫 OpenViking 的记忆层。这是字节跳动开源的上下文数据库项目,目前在GitHub上已积累约 37900 星。装完之后,同一个项目不必再从头交代,AI能够在跨会话之间保留记忆。
它的核心思路并不复杂:把AI需要记住的东西组织成一个文件系统。顶层只有三个目录——Agent、Resources、User。你可以直接用命令行去翻,ls、tree、find 这些熟悉的命令都能用。每个目录上都挂着一段摘要,这正是它节省Token的关键所在。
三层加载:Token省下来的秘密
OpenViking省Token的机制在于分层加载内容,而不是一次性把全部信息塞进上下文窗口。
- L0:一句话摘要,先用来判断这块内容与当前任务相不相关;
- L1:概览层,用于规划任务;
- L2:全文,只有真正需要精读的时候才会加载。
这种由粗到细的渐进式读取,避免了把无关的大段全文一股脑喂给模型。据官方实测数据,输入Token下降幅度在 34% 到 91% 之间,波动区间较大,取决于任务类型和检索命中情况。
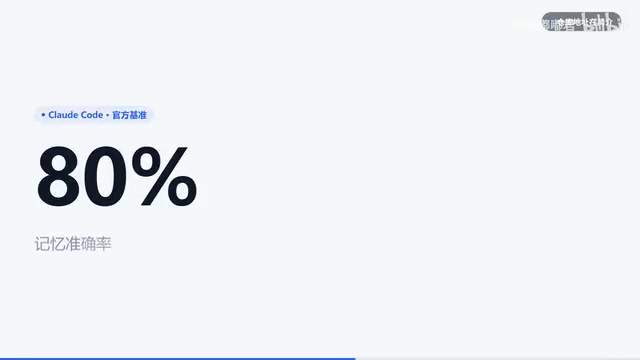
除了省钱,记忆准确率也有提升。官方给出的数据显示,在Claude Code(视频中口述为“Cloud Code”)上,记忆准确率从 57% 涨到 80%。需要提醒的是,这些都是官方自己发布的数据,仓库里附带了复现脚本,感兴趣的读者可以自行验证。
上下文窗口(Context Window)是指模型在单次推理时能够"看到"的最大文本长度,以Token数量计量。Token并非等同于字符,中文一个汉字通常对应1-2个Token,英文一个单词大约1-1.5个Token。主流模型的上下文窗口已从早期的4K扩展到128K乃至更长,但更大的窗口并不意味着无限免费——商业API通常按输入Token收费,而且窗口越满,模型在长距离信息上的注意力分散问题也会加剧,导致"看了等于没看"的检索失效现象。OpenViking的分层加载机制本质上是在窗口之外做了一层手动检索与裁剪,只把与当前任务相关的内容片段放入窗口,从而在控制成本的同时维持模型对关键信息的注意力密度。
真实机器上的实测:四次里有一次白找
UP主没有停留在复述官方数据,而是在自己的机器上跑了一轮实测。结果值得关注:在 1257 次检索中,有 40.3% 是零结果——也就是说,差不多四次检索里就有一次“白找”,什么都没检索到。
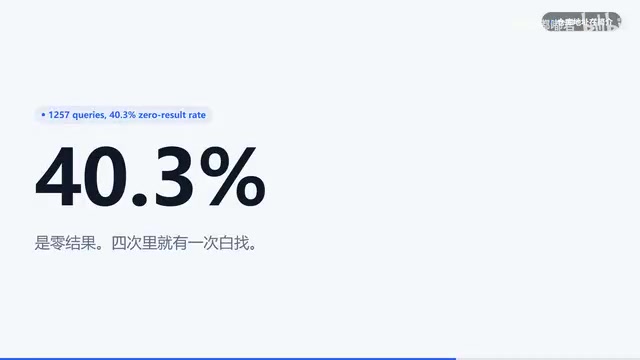
这个数字提示了一个现实:OpenViking并不是装上就万事大吉的银弹。零结果比例的高低,很大程度上取决于你自己的目录结构是否合理。库里当前的规模是约 5270 个项目、三个挂载点(这一数据同样由作者自报,未经修饰)。换句话说,检索命中率需要使用者花心思去维护和组织,工具本身只是提供了机制。
作者在这里的态度相当克制:既没有夸大官方的降本数据,也如实点出了自己遇到的高零结果比例,这种“不美化”的呈现方式对读者更有参考价值。
如何接入DSH
把OpenViking接到DeepSeek Harness上,官方提供了两种方式:
- 插件方式;
- MCP(Model Context Protocol)方式。
两种接法各有适用场景,具体的仓库地址在视频简介中给出。对于已经在用DSH、又深受“换会话失忆”困扰的开发者来说,这是一个成本不高、值得一试的补丁。
不过要清醒地认识到它的边界:OpenViking解决的是跨会话记忆持久化和上下文压缩的问题,它治不了的地方作者也说得很明白——检索白找的比例,最终还得靠你自己把目录结构设计好来压下去。工具给了骨架,血肉要靠使用者自己填。
MCP(Model Context Protocol)是Anthropic于2024年底推出的开放协议,旨在为AI模型与外部工具、数据源之间建立标准化的通信接口。可以把它理解为AI领域的"USB接口"——只要工具和宿主都遵循这一协议,接入和切换就不需要各自定制适配层。目前Claude、Cursor、Windsurf等主流AI编程环境均已支持MCP,生态正在快速扩张。相比插件方式,MCP接入的优势在于互操作性更强:同一个OpenViking MCP服务,理论上可以同时被多个支持MCP的客户端调用,不必为每个工具单独维护一套集成代码。对于已经在多个AI编程环境之间切换的开发者,MCP方式的长期维护成本通常更低。
小结
OpenViking把AI记忆抽象成一个可用命令行操作的文件系统,配合L0/L1/L2三层渐进加载,在官方数据上实现了34%~91%的Token下降和记忆准确率的明显提升。但真实使用中约四成的零结果比例说明,它的效果高度依赖使用者对目录结构的组织能力。对于DSH用户,这是一个开源、可复现、接入门槛不高的记忆增强方案,值得根据自己的项目情况尝试。
相关推荐

智能体变慢或出错时,用Traces在Foundry中精准排查
智能体响应慢或输出错误时该从哪排查?本文详解 Microsoft Foundry 的 Traces 追踪功能,涵盖连接 Application Insights、读懂 span 层级、查看元数据与多种视图,帮助开发者高效定位 AI 智能体问题。
18亿美元全球承诺:为AI准备生物数据意味着什么
一项18亿美元的全球资金承诺瞄准AI-ready生物数据,旨在解决AI驱动生命科学中的数据瓶颈。本文解析这笔投资的意义、潜在影响与现实挑战。

开源本地化照片管理工具:免费替代Adobe Lightroom
一款免费开源、完全本地化运行并集成AI的Adobe Lightroom替代工具在Hacker News发布。本文解析其本地化优势、AI照片管理能力及开源替代品面临的机会与挑战。