Gemini 3.1 Pro编程实测:跑分第一实战第三,与Claude和GPT真实对比
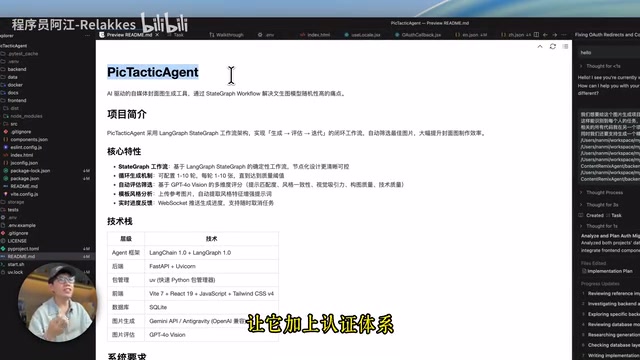
Gemini 3.1 Pro实测编程能力不及Benchmark表现,复杂任务翻车
一位开发者用两道真实编程题(跨项目认证迁移和CLI转Web UI)对比测试Gemini 3.1 Pro、Claude Opus 4.6和GPT 5.3 Codex。尽管Gemini在Benchmark上领先,但在实测中表现不佳:任务一花了五轮对话才勉强完成,存在Prompt理解错误和实体混淆问题,暴露了其在复杂上下文推理中的短板。
引言:Benchmark第一就是编程最强吗
谷歌近期发布的Gemini 3.1 Pro在各项Benchmark上表现亮眼,编码能力评分几乎在所有维度都处于领先地位。但跑分终究只是跑分,真实编程场景下的表现才是开发者最关心的问题。
AI编程能力的Benchmark体系通常包括HumanEval、MBPP、SWE-bench等标准测试集。HumanEval由OpenAI提出,包含164道Python编程题,主要测试函数级别的代码生成能力;SWE-bench则更接近真实场景,要求模型解决GitHub上的真实Issue。然而这些测试集存在共同局限:题目相对独立、上下文简单、不涉及多文件协作和跨项目理解。真实开发场景中,开发者面对的往往是数千行的既有代码库、复杂的依赖关系和模糊的需求描述,这些维度在标准Benchmark中几乎缺席。
本文基于一位开发者的实测对比,使用完全相同的Prompt和真实项目,将Gemini 3.1 Pro与Claude Opus 4.6、GPT 5.3 Codex进行横向对比。两道编程考题涵盖了跨项目迁移、架构适配、全栈开发、流式输出等多个维度,最终结果出乎意料。
测试方案:两道真实编程题的设计思路
为了保证测试的公平性和可复现性,测试采用了与之前完全一致的Prompt,不做任何修改:
任务一:跨项目迁移认证体系
- 将完整的用户认证系统(Email、Google、GitHub登录)迁移到图片生成Agent项目中
- 同时为项目制作一个落地页
- 考验能力:代码理解、架构适配、工程规范
任务二:CLI Agent转Web UI
- 将终端CLI Agent工具改造为Web聊天页面
- 保留Syncing、工具调用、流式输出等功能
- 考验能力:全栈开发、流式输出、UI/UX交互
任务一实测:Gemini 3.1 Pro复杂项目迁移翻车
Gemini的五轮修复过程
Gemini 3.1 Pro在第一个任务上表现不佳,总共花了五轮对话才勉强完成任务,且最终效果仍有明显问题:
- 第一轮对话:代码生成完毕,但项目无法启动
- 继续修复后:项目能跑起来,但页面跳转存在问题
- 核心Bug:登录认证成功后,未能正确跳转到图片生成Agent的主页面
- 严重理解错误:落地页完全套用了参考项目的内容,而非基于当前项目生成
这个错误暴露了Gemini 3.1 Pro在Prompt理解质量上的短板。Prompt理解质量是区分AI编程助手能力层级的核心指标之一,其背后涉及模型的指令跟随能力(Instruction Following)和上下文推理能力(Contextual Reasoning)。高质量的Prompt理解要求模型不仅能解析显式指令,还能推断隐式约束——例如"将认证系统迁移到目标项目"这一指令隐含了"落地页内容应基于目标项目而非参考项目"的约束。研究表明,模型在处理包含多个实体引用的复杂Prompt时,容易出现实体混淆(Entity Confusion)问题,即将不同上下文中的相似概念错误地映射到同一对象,这在代码生成场景中尤为致命。
跨项目代码迁移本身也是软件工程中公认的高难度任务。模型需要同时理解源项目和目标项目的架构,区分哪些是可复用的通用逻辑,哪些是需要适配的项目特定实现。认证系统通常与数据库Schema、Session管理、路由守卫、环境变量等深度耦合,任何一个环节的误判都会导致运行时错误。Gemini出现的"套用参考项目内容"问题,本质上是模型在长上下文推理中发生了"注意力漂移"——无法精准区分两个项目的边界,这在学术上被称为"Lost in the Middle
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。