Gemini 3.5 Flash深度测评:Pro级性能,Flash级价格

Google在I/O大会上将Gemini 3.5 Pro推迟到6月发布,转而将Flash模型推上主舞台。经过一周的深度使用测试,这款模型在Gemini应用、AI Studio、Workspace扩展等多个场景中的表现令人惊讶——Flash悄然取代了Pro级模型的地位。


多模态视觉:冰箱食材识别测试
在Gemini应用中上传一张半空冰箱的照片,要求模型识别所有食材并给出晚餐食谱,同时列出需要额外购买的材料。测试的关键在于冰箱后方有两个相互遮挡的罐子——Flash准确识别了两者,并将它们纳入食谱建议中。
这并非简单的视觉任务。大多数模型要么遗漏被遮挡的物品,要么凭空捏造不存在的东西。Flash的输出干净利落:完整的食谱步骤加上精确的购物清单,只包含实际缺少的食材,没有添加任何不存在的物品。相比2.5 Pro在同一测试中的表现,Flash更快且输出更清晰。
原生视频理解:长视频分析与数据可视化
第二个测试将一段完整的长视频直接拖入聊天窗口——无需转录步骤,无需外部工具。提示词要求模型提取前五个核心洞察并附带精确时间戳,然后找到23分钟处的数据表格并用Python重新绘制图表。
界面中会出现一个可展开的"分析视频"模块,可以实时观察模型扫描内容的过程。经过验证,返回的时间戳准确度在20秒以内。更令人印象深刻的是,Python图表直接在聊天窗口中渲染——Flash从23分钟标记处提取数据并在同一响应中完成可视化,无需复制粘贴或打开外部笔记本。
这得益于64K token的输出窗口——代码、图表和完整分析在一个连续响应中完成,不会被截断。
核心参数与价格:Flash的成本优势有多大
Gemini 3.5 Flash配备100万token上下文窗口和64,000 token输出限制。单次响应获得64K token是最大的实用性变化——早期模型在复杂任务中会中途截断,Flash则能完整输出。
价格对比令人震撼:
- Gemini 3.5 Flash:$1.50/百万输入token,$9/百万输出token
- Claude Opus 4.7:$5输入,$25输出
- GPT 5.5:$5输入,$30输出
Flash不是略微便宜,而是处于完全不同的成本区间。在生产环境中,输出token是主要开支,$9对$25的差距在规模化时影响巨大。Google已将Flash设为Google搜索AI Mode的全球默认模型。
思考级别切换:合同分析实战
在AI Studio中测试了一份40页B2B合同PDF的分析。提示词要求模型以合同律师身份审阅全文,标记所有隐藏费用、自动续约条款和客户可能遗漏的罚则。
整份文档轻松放入Flash的上下文窗口。关键发现在于思考级别的切换效果:
- 低思考级别:响应快速,结果尚可
- 高思考级别:展开思维链模块,可观察模型逐条分析条款并交叉引用各章节
高思考级别额外捕获了两个罚则条款和一个自动续约触发器,这些在低思考级别中完全被遗漏。对于合同、法律文件和财务报告,当错误答案代价高昂时,应将思考设为高级别。反之,快速摘要或邮件草稿用低级别即可。
Vibe Coding实测:手绘草图变React应用
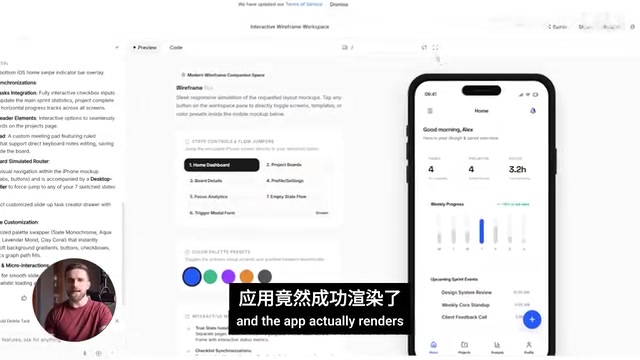
跳过Wireframe工具和Figma,直接拍摄手绘应用布局照片,要求Flash构建一个采用Tailwind和Apple风格设计的React组件。
输出流式传输数百行完整React代码,没有触及截断限制。早期模型在这种规模的组件中会中途断开,需要再次提示继续。Flash一次性完成。将代码粘贴到AI Studio内置的实时预览面板中,应用直接渲染——按钮可点击,布局正确呈现,无需离开AI Studio。
结构化数据提取:15张多语言收据批量处理
上传15张来自不同国家、不同语言和格式的收据照片,目标是提取干净的结构化数据。AI Studio提供专用的结构化输出面板,可视化定义schema(商户名、日期、总金额、币种、明细项),无需编写任何代码。
一次请求处理全部15张收据,输出为有效JSON。Flash自动处理语言切换,每张收据无论语言如何,都以相同schema返回正确字段。整个过程不到2分钟,此前需要付费OCR API才能完成的工作,现在原生完成且无额外成本。
Workspace代理链:一句话驱动多应用协作
启用Workspace扩展后(Drive、Docs、Gmail、Calendar),用单条提示词完成:在Drive中找到5月销售报告→创建新的摘要文档→起草包含链接的团队更新邮件。
Gemini依次打开Drive查找文件、读取内容、创建新Docs文件并撰写摘要、最后起草Gmail并嵌入链接。三个Google产品通过一条提示词串联完成,全程无需手动操作任何应用。这是真正的代理式AI——不再是文本生成器,而是在实际工具中执行多步骤工作的操作者。
Gemini 3.5 Flash的三个已知问题
大多数评测不会提到的三个问题:
- 长上下文检索退步:Flash在MRCR V2基准测试(128K token上下文)中比Gemini 3.1 Pro低7.6分,精确信息检索能力有所下降
- 输出冗长:在推理密集型任务中,Flash使用的token量约为早期模型的两倍
- 默认思考级别静默降级:从2.5 Pro迁移到3.5 Flash时,Gemini应用中的默认思考级别从高降为中等,Google未公告此变更。建议立即检查设置并手动调回高级别
总结:Flash值得替代你的Pro订阅吗
Flash在其价格点上表现出色。对于大多数生产工作流,它以Flash定价提供Pro级结果,这是AI规模化运营经济学的真正转变。但对于精确的长上下文检索任务,仍需配合人工验证步骤。
如果你正在同时为多个AI订阅付费,Flash的性价比优势值得认真考虑——它不是妥协方案,而是在大多数场景下的最优选择。
相关推荐

Felix Rieseberg 个人主页
Felix Rieseberg 个人主页在 Hacker News 引发关注。本文介绍这位 Slack 工程师的技术背景、nativefier 项目的兴衰,以及开发者个人主页作为技术名片的价值。

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。