Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
谷歌正用Flash的极致性价比重新定义大模型竞争规则:从比智能转向比单位成本产出。
谷歌近期出现反常信号:旗舰模型Gemini 3.5 Pro迟迟未发布,而Flash系列却在六周内连更三版。文章认为这背后是谷歌对大模型战争的重新理解——竞争重心正从"谁的模型最聪明"转向"每一美元、每一度电能产出多少有效智能"。Gemini 3.8 Flash智力评分虽非第一,但输出速度达302 Token/秒、单任务成本仅约0.58美元,相比高分竞品低出数倍。这一逻辑对谷歌尤为关键:几十亿存量用户既是最大优势,也意味着AI高频调用将带来天量算力账单,而其自研TPU系统能效约为主流英伟达方案的1.7倍,恰好为成本优势提供了硬件基础。大模型战争正从军备竞赛演变为工业竞赛。
旗舰模型延期、核心人才出走,Flash却在疯狂加速——谷歌身上最近出现了一组反常信号。到底是它在这场大模型战争中掉队了,还是它对这场战争的理解正在发生根本性的变化?
反常的信号:Pro难产,Flash狂飙
原本万众期待的 Gemini 3.5 Pro,几个月前还说下个月上线,结果一直拖到现在迟迟没有正式发布。但另一边,谷歌却在疯狂迭代 Flash——从 3.5 Flash、3.6 Flash、3.7 Flash 一路来到最新的 3.8 Flash,短短六周连续更新三个版本。
更微妙的是,就在模型路线发生变化的同时,谷歌 AI 核心团队也经历了一轮明显震荡。Demis Hassabis 卸下 DeepMind 的日常管理职责,转任主席兼 Alphabet 首席科学家;Jeff Dean、Sanjay Ghemawat 等重量级人物调整了角色;AlphaFold 核心研究者 John Jumper 也一度传出转投 Anthropic 的消息。表面上看,这像是谷歌的旗舰模型在掉速。
但如果把模型的智能、速度、任务成本,再和谷歌自己的 TPU 算力放在一起看,你会发现一件更有意思的事:谷歌可能正在重新定义这场大模型战争到底应该比什么。
从比智能到比成本:战争规则正在改写
过去大家比的是谁的模型最聪明、谁的 Benchmark 更高、谁的推理能力更强、谁能拿下更多榜单第一。但谷歌现在似乎开始比另外一件事:每一亿美元、每一度电,到底能生产多少有效智能。
先看一组很有意思的数据。在这组模型对比里,Gemini 3.8 Flash 的 AI 智力分数大约是 59 分,这并不是最高的——最高一档大约 66 分,另外几个主流模型在 60 到 63 分左右。所以如果只看谁更聪明,3.8 Flash 并不是绝对的第一名。
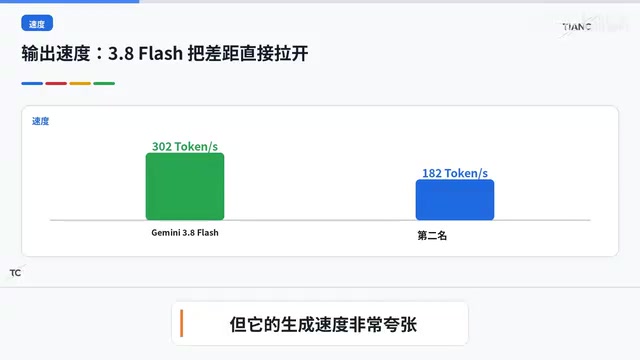
但把视线移到速度这一栏,情况就完全不一样了。Gemini 3.8 Flash 的输出速度达到大约 302 Token/秒,排名第一,第二名大约是 182 Token/秒。也就是说,它虽然不是最聪明的模型,但生成速度非常夸张。
真正关键的是第三个指标——Cost Per Task,即完成同等智能任务的加权平均成本。Gemini 3.8 Flash 大约只需 0.58 美元,而另一头一些模型完成类似任务的成本已经到了 2.34 美元甚至 3.69 美元。
这意味着什么?59 分对 63 分、66 分,看上去差距并不巨大。但如果它完成任务的成本只有对方的几分之一,速度还更快,放到真实业务里,这点差距就会被成倍拉开。实验室只是跑一遍测试,现实中的 AI 服务是全天候不停跑,每秒都在产生大量调用。
Benchmark(基准测试)是衡量大模型能力的标准化评测集,常见的包括 MMLU(多学科知识)、HumanEval(代码生成)、MATH(数学推理)等。过去两年,各家公司将 Benchmark 排名作为核心营销指标,"榜单第一"几乎等同于技术领先的象征。然而 Benchmark 存在几个已被广泛讨论的局限:测试集可能被有意或无意地"刷分";实验室环境的静态题目难以反映真实业务中的长尾需求;更关键的是,它只衡量正确率,完全忽略延迟和成本。文中用"AI 智力分数"描述的指标,本质上是对多个 Benchmark 加权聚合后的综合得分,谷歌用它与速度、成本并列呈现,正是在有意引导外界用"单位成本产出多少智能"来替代"谁的分数更高"作为评价框架。
主力工作模型:为 Agent 时代而生
这也是为什么谷歌把 3.8 Flash 定义成一个非常关键的角色——主力工作模型。它重点强化的不是单纯的聊天体验,而是 Coding、Agent、多步骤推理和工具调用。因为未来真正带来海量调用的,很可能就是这些工作。
设想一个 Agent 帮你完成任务:它可能先读取文件,然后搜索网页,再调用工具、写代码、运行测试,发现错误后重新推理、修改、再运行。这意味着一个完整任务可能需要调用几十次甚至上百次模型。到了这个阶段,企业真正关心的就不再是「你的模型是不是比我高三分」,而是「完成同样一份工作,你要花多少钱」。
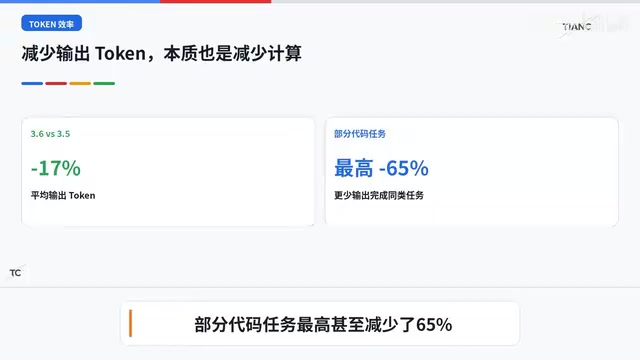
目前 3.8 Flash 每百万输入 Token 价格大约 0.75 美元,输出 3.75 美元,和 3.7 Flash 首发价格保持一致。而此前 3.6 Flash 相比 3.5,平均输出 Token 减少了大约 17%,部分代码任务最高甚至减少了 65%。
这里有一个容易被忽略的变化:谷歌优化的并不只是速度,它还在想办法让模型输出更少但更有效的 Token,用更少的计算完成同样的任务。所以从 3.5 一路到 3.8,Flash 真正优化的是一个越来越重要的指标——单位智能成本。
Agent(智能体)是指能够自主规划、调用工具并连续执行多步骤任务的 AI 系统,与传统单轮问答模式有本质区别。在单轮问答中,用户提问、模型回答,一次交互消耗一次推理算力;而 Agent 模式下,模型需要反复"思考—行动—观察",每一轮循环都触发新的模型调用。例如一个自动化编程 Agent 可能在完成一个 bug 修复任务时,依次调用代码阅读、网络搜索、代码生成、单元测试运行、错误分析等工具,整个流程产生几十次独立的 API 请求。这意味着 Agent 场景下的计算成本远高于普通聊天,单次任务的花费可能是聊天场景的数十倍。正因如此,模型的推理延迟和单 Token 价格在 Agent 场景中被急剧放大,"速度快、成本低"的模型在工程落地层面的吸引力远超"略微更聪明"的竞争对手。
几十亿用户,是优势也是成本压力
为什么谷歌尤其在意这个指标?因为它最大的优势,同时也是 AI 时代最大的成本压力之一,就是那几十亿存量用户。
过去用户做一次谷歌搜索,过程很简单:输入关键词、理解意图、检索网页、排序结果、放进广告,计算成本相对有限,却能产生很高的商业价值。可是 AI 搜索完全不同。比如你问「帮我规划一个日本七天旅行」,它可能需要搜索大量网页、整理酒店和路线、调用地图、比较交通,再进行多步骤推理。用户表面上只问了一句话,后台可能已经发生了几十次模型调用。
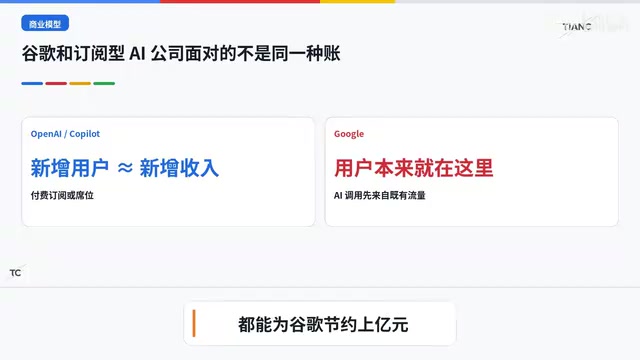
于是问题来了:谷歌的用户规模越大、AI 越好用、调用次数越多,背后的算力账单也越来越大。这和 OpenAI、Anthropic 不完全一样——OpenAI 增加一个付费用户通常意味着多一份订阅收入,微软卖出一个 Copilot 席位也能直接产生新增收入。但谷歌的问题是,这些用户本来就是它的。当谷歌把 AI 能力塞进 Search、Android、YouTube 以及整个生态后,大量调用可能首先来自原本就存在、甚至原本免费的流量。
现在头部大模型 API 日调用普遍数亿到十几亿次,每降低 0.01 美元都能为谷歌节约上亿元,这比疯狂加大资本开支划算多了。
更深一层的压力是:AI 可能反过来改变谷歌最赚钱的那台机器——搜索广告。如果用户直接接受 AI 生成的答案,不再点击传统搜索结果,广告放在哪里?广告主为什么还要为这些流量付那么多钱?所以谷歌一边要承担 AI 新增的算力成本,另一边又不能让 AI 把自己原来的利润机器吃掉,这才是它最难的一道题。
TPU 的关键作用:每兆瓦电能产多少智能
到了这里,TPU 的重要性就出来了。现在看 AI 芯片,已经不能只看单颗芯片有多快,真正重要的是一个更现实的问题:每一兆瓦电力到底能生产多少 AI 算力。
根据 Epoch AI 的一组测算,如果统一换算成 H100 等效算力,谷歌的 TPU 方案大约可以做到 2039 个 H100 等效算力/兆瓦;对比英伟达 B200、B300 整套方案大约是 1175 个 H100/兆瓦。注意这是整套数据中心的系统能效,并非单颗芯片直接对比。机构同时预估,谷歌作为单一厂商,持有全球大约四分之一的 AI 总算力。
谷歌真正想做的,是每花一美元、每用一度电,到底能生产多少 Token、多少任务、多少有效智能。当你拥有几十亿用户时,真正巨大的竞争优势未必只是「我有世界上最强的模型」,还可能是「我能不能把每一次模型调用的成本再降低一点」。这个差距听起来很小,但乘以每天几十亿次调用,就是一个非常巨大的数字。
TPU(Tensor Processing Unit,张量处理器)是谷歌自研的 AI 专用芯片,从 2016 年第一代起已迭代至第六代(Trillium)。与英伟达 GPU 的通用并行计算架构不同,TPU 从设计之初就针对矩阵乘法和神经网络推理进行了深度定制,因此在运行 Transformer 类大模型时,在特定工作负载下能效比更高。更重要的是,谷歌将 TPU、自研网络互联(ICI)、数据中心冷却和电力管理作为一个整体系统进行协同优化,而不是简单堆叠第三方芯片。这种垂直整合策略使谷歌能够在系统级别而非单芯片层面获得能效优势——文中 Epoch AI 的数据(2039 vs 1175 H100等效/兆瓦)衡量的正是整套数据中心方案的综合能效,而非芯片裸性能的直接对比。对于拥有巨量自有调用流量的谷歌而言,这种系统级能效优势可以直接转化为更低的每次推理边际成本。
从军备竞赛到工业竞赛
这样再回头看 Gemini 3.5 Pro 延期、3.8 Flash 疯狂迭代,逻辑就完全不一样了。谷歌当然不能放弃 Pro,因为 Pro 守住的是智能上限——如果最复杂的推理、科研、Coding 任务长期都输给 OpenAI 和 Anthropic,它一样会掉队。旗舰模型依然非常重要。
但另一边,最强的模型不一定是调用量最大的模型,也不一定是最赚钱的模型。未来的 Agent 时代尤其如此,绝大多数实际业务追求的就是够用、便宜、速度快。谁把这些做到位,谁就能拿到大量业务。
这并不是谷歌一家公司的变化。微软、OpenAI、Anthropic,包括国内很多大模型公司,都在越来越重视高性价比模型、模型分层和推理成本。过去的大模型战争更像军备竞赛——谁的模型最强、参数最大;下一阶段可能越来越像工业竞赛——谁能用最低成本完成最高价值的任务。
谷歌恰恰是最不能忽视这个问题的公司。别人很多时候还在想办法寻找用户,而谷歌真正需要担心的是:如果几十亿用户真的开始高频使用 AI,我怎么付得起这张账单。它真正的问题不是没有技术、没有算力、没有用户,恰恰相反,是它的用户太多了。当每一次推理成本哪怕只降低一点点,乘上巨大的调用规模,最后影响的都是真金白银的利润。
相关推荐
Vercel AI SDK 更新:@ai-sdk/xai 新增 Grok 模型支持
Vercel AI SDK 发布 @ai-sdk/xai@3.0.134 补丁更新,新增对新版 Grok 模型 ID 的支持,并同步升级 provider-utils 与 openai-compatible 依赖。本文解读更新内容及开发者应对建议。

Gemini Pro 订阅方案对比:Pixel 失效后如何选择
Gemini Pro 订阅方案最新对比:Pixel 渠道被谷歌封控失效,学生优惠认证收紧仅推荐老账号,Jio 渠道虽便捷但存在掉订阅与价格波动风险。一文看懂如何选择合适的 Gemini Pro 订阅渠道。
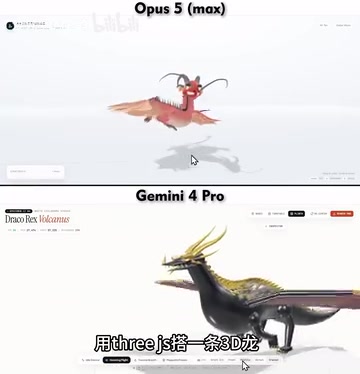
Gemini 4 Pro对决Opus 5 Max:Three.js建3D龙谁更强?
Gemini 4 Pro 与满血 Opus 5 Max 用同一条提示词、通过 Three.js 搭建 3D 龙的横向对比测试。结果显示未发布的 Gemini 4 Pro 竟能与满配 Opus 5 打成平手,本文解析这场 AI 编程能力对决的看点与意义。