Gemini 3.8 Live 推出 Live Avatar:谷歌 AI 有了会说话的脸

谷歌为Gemini推出实时动画虚拟形象Live Avatar,支持唇形同步与表情变化,目前仅向企业客户开放。
谷歌在Gemini 3.8 Live版本中推出Live Avatar功能,让AI拥有能够实时唇形同步、动态呈现面部表情的动画形象,将人机交互从「听觉」延伸至「视觉拟人化」层面。该功能目前仅向Gemini Enterprise企业客户开放,主要面向客户服务、虚拟接待、培训助手等场景,支持在97种形象与状态之间切换,具备较高的定制灵活度。从行业背景看,此举折射出多模态交互竞争的升温——在大模型语言能力趋于同质化的当下,「如何让AI看起来更可信、更易沟通」正成为新的差异化战场。与此同时,拟人化AI也带来过度信任、情感依赖及隐私边界等潜在风险,如何把握拟人化的分寸将是长期课题。
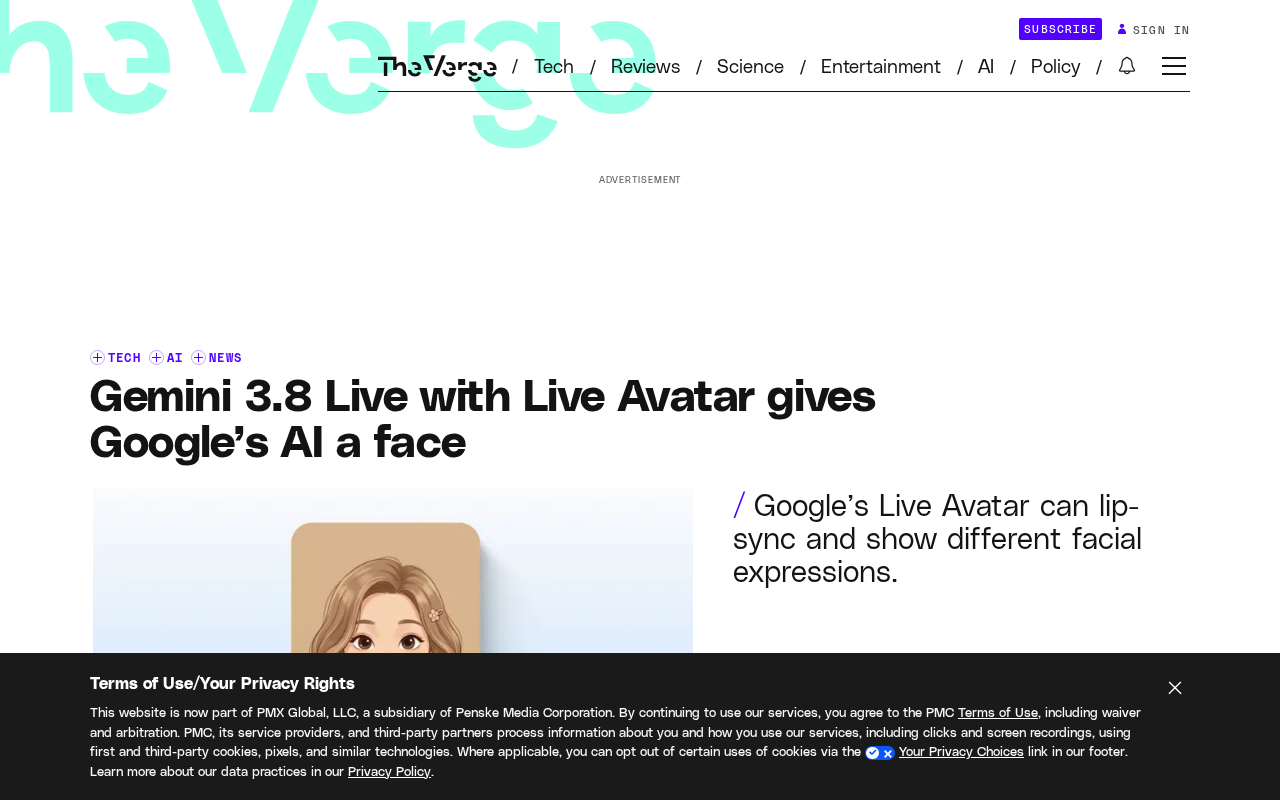
谷歌为 Gemini 带来了一个颇具想象力的更新。最新的 Gemini 3.8 Live 版本引入了名为「Live Avatar」的功能,让用户在与模型对话时,能够看到一个实时响应的动画 AI 形象。这标志着谷歌在语音交互之外,进一步向拟人化、可视化的 AI 交互形态迈进。
Live Avatar 到底是什么
简单来说,Live Avatar 是一个能在对话中实时做出反应的动画 AI 角色。它不只是一张静态头像,而是会随着对话内容进行唇形同步(lip-sync),并展现不同的面部表情。换句话说,当你和 Gemini 交谈时,屏幕上的这个虚拟形象会像真人一样张嘴说话、变换神情,而不是只有一段声音在播放。
这类拟人化设计的核心目标,是降低人机交互的距离感。相比纯文本或纯语音,带有表情和口型的可视化形象能让对话显得更自然、更具亲和力,尤其在需要长时间交流或情感化沟通的场景中,视觉反馈往往能显著提升用户的沉浸感。
唇形同步(lip-sync)技术在 AI 领域的实现,通常依赖将语音的音素序列与对应的面部肌肉动作(称为「viseme」,即视觉音素)进行对齐映射。传统影视后期制作中这一过程需要人工逐帧调整,而现代 AI 驱动的实时唇形同步则通过深度学习模型,在毫秒级延迟内完成音频特征到面部动作的预测与渲染。谷歌在此基础上叠加了情感表情的动态变化,使虚拟形象不只是「嘴在动」,而是能够根据对话语气和内容呈现出皱眉、微笑等情绪反馈,这对实时推理和渲染能力都提出了较高要求。
目前仅面向企业客户开放
需要说明的是,Live Avatar 当前并未向所有用户开放,而是仅提供给 Gemini Enterprise(谷歌的企业级 Gemini 服务)客户使用。这一定位透露出谷歌的思路:先在企业场景中验证这类功能的实际价值。
企业场景对虚拟形象有着天然的需求,比如客户服务、虚拟接待、培训助手、内部知识问答等。一个能够实时应答并带有表情的 AI 形象,可以承担部分传统上需要真人完成的沟通工作。从商业逻辑看,先在企业市场落地,也更容易形成付费闭环,而非直接面向海量消费者铺开。
97 种形象之间的切换能力
根据谷歌的说明,Live Avatar 能够在 97 种(不同的形象/状态)之间进行切换。虽然原始信息在此处有所省略,但这一数字本身已经说明谷歌为该功能预设了相当丰富的表现维度——无论是不同的角色形象,还是多样化的表情与状态过渡,都意味着这套系统在视觉呈现上具备较高的灵活度。
这种切换能力对企业用户尤其有意义。不同的品牌、不同的应用场景可能需要不同风格的虚拟形象,而丰富的可选项让企业能够根据自身需求进行定制化配置,从而让 AI 形象更贴合品牌调性与使用语境。
为什么「给 AI 一张脸」值得关注
从行业趋势看,AI 交互正在经历从「文本」到「语音」再到「视觉化拟人」的演进。文本交互效率高但缺乏温度,语音交互更自然但仍是单向的听觉体验,而带表情、能唇形同步的虚拟形象则补上了视觉与情感表达这一环。
谷歌此举也反映出大厂在多模态交互上的竞争正在升温。当模型的语言能力逐渐趋于同质化,交互体验——包括如何让 AI「看起来」更可信、更易于沟通——可能成为下一个差异化的战场。给 AI 一张会说话的脸,既是技术能力的展示,也是产品体验层面的一次押注。
不过,拟人化 AI 也伴随着值得警惕的问题。当 AI 拥有了逼真的表情和形象,用户可能更容易对其产生信任甚至情感依赖,这对信息真实性、隐私边界以及使用规范都提出了新的要求。如何在提升体验的同时把握好拟人化的分寸,将是包括谷歌在内的所有厂商需要长期面对的课题。
心理学中有一个相关概念叫「拟人化效应」(Anthropomorphism Effect):人类天生倾向于将具有人类特征(面孔、声音、肢体语言)的对象视为有意图、有情感的社会主体,并对其产生更高程度的信任与情感共鸣。研究表明,相比纯文字或语音助手,带有人脸的虚拟代理能显著提升用户的配合度与满意度,但同时也更容易触发「过度信任」——用户可能因为形象的逼真程度而高估 AI 的能力或可靠性。这也正是「恐怖谷」(Uncanny Valley)之外另一个值得关注的风险维度:不是太像人让人不适,而是太像人让人放松了本应有的批判性审视。
小结
Gemini 3.8 Live 的 Live Avatar 功能,让谷歌的 AI 从「能听会说」进一步走向「有脸有表情」。目前它仅限企业客户使用,支持多达 97 种形象/状态的切换,并具备实时唇形同步与表情变化能力。这一更新的意义不仅在于功能本身,更在于它折射出的方向:AI 交互正在加速可视化、拟人化,而体验层面的竞争才刚刚开始。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。