Gemini 3.8 TTS 上手:2000+ 语音与多角色对话实测
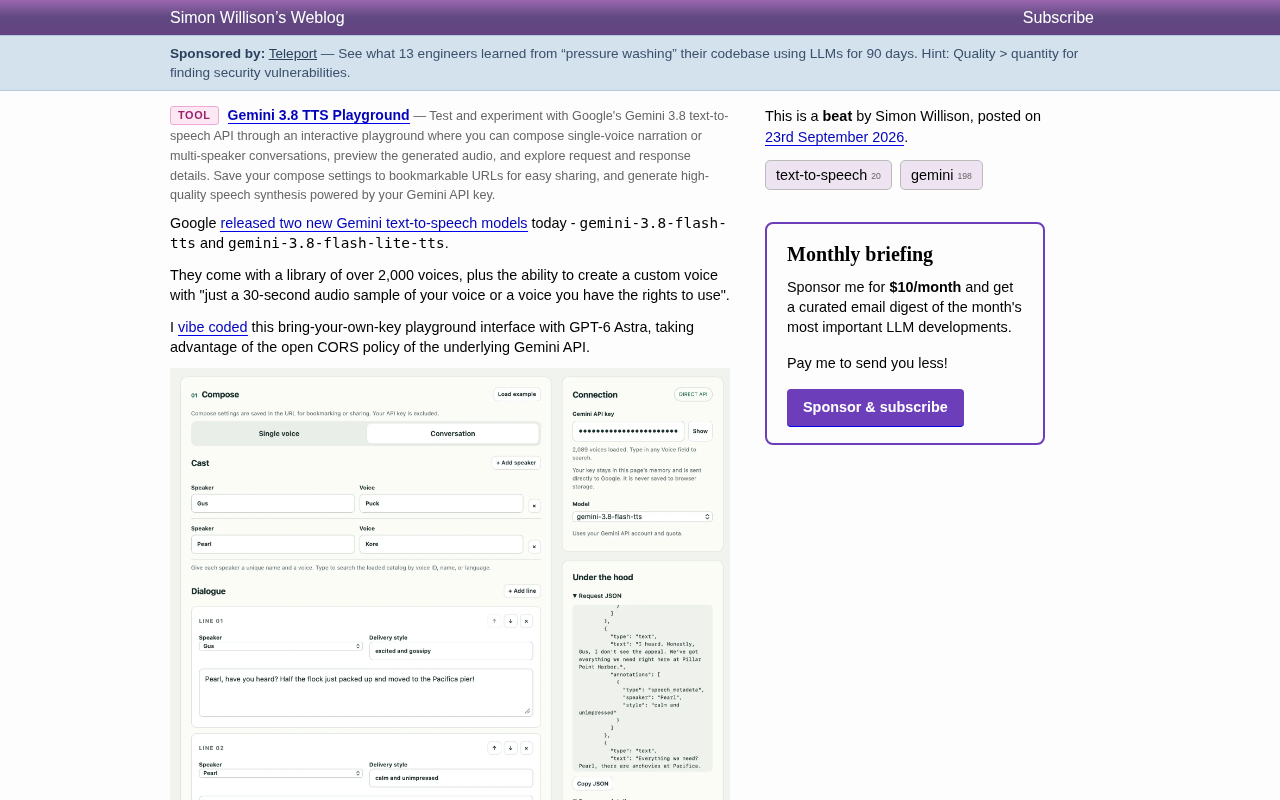
Google 推出超两千音色、原生多角色对话的 Gemini 3.8 TTS 模型,配合开发者 Playground,成本低至每分钟音频约 2 美分。
Google 发布了 gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts 两款文本转语音模型,内置超过 2,000 个音色,并支持用 30 秒音频样本克隆自定义声音。最突出的能力是原生多角色对话:开发者可为不同角色分配音色与情绪风格指令,模型在单次推理中统一处理整段对话的节奏与情绪过渡。开发者 Simon Willison 借助 CORS 开放策略,以 vibe coding 方式快速搭建了一个纯前端、自带密钥的 Playground,密钥仅存于页面内存,不落盘也不经过第三方服务器。实测生成 1 分 18 秒多角色音频仅需约 20 秒,成本为 2.74 美分,高性价比使语音合成具备规模化生产的可行性。
Google 最新发布的两款文本转语音模型 gemini-3.8-flash-tts 和 gemini-3.8-flash-lite-tts 把 TTS 能力推向了新的高度。开发者 Simon Willison 基于这两个模型 vibe code 出了一个自带密钥(bring-your-own-key)的 TTS Playground,让我们得以直观体验它们的实际表现。
两款新模型带来了什么
Google 此次一口气发布了两个语音合成模型:性能更强的 gemini-3.8-flash-tts,以及成本更低的 gemini-3.8-flash-lite-tts。它们最大的亮点在于自带一个超过 2,000 个语音的语音库,覆盖多种语言与音色。
更进一步,模型还支持自定义语音克隆——官方说明只需「一段 30 秒的音频样本」,无论是你自己的声音,还是你拥有使用权的声音,都能被复刻。这意味着 TTS 不再局限于预设音色,个性化语音生成的门槛被大幅拉低。
一个开箱即用的 Playground
Simon Willison 利用 Gemini API 开放的 CORS 策略,借助 GPT-6 Astra vibe code 出了一个纯前端的 Playground 界面。它的设计相当克制:用户自带 Gemini API key,密钥只保存在页面内存中,直接发送给 Google,从不写入浏览器存储,也不会被工具本身保留。
界面分为左右两栏。左侧 Compose 面板负责内容编排,支持「单一语音」和「对话」两种模式;右侧 Connection 面板显示「DIRECT API」直连标识,并提示已加载 2,089 个语音可供搜索。此外还有一个「Under the hood」面板,可以展开查看完整的 Request JSON 和 Response 细节——对想了解 API 调用结构的开发者很友好。
值得一提的是,Compose 的设置会被保存进 URL,方便收藏或分享,而 API key 会被排除在外,兼顾了便利与安全。
「Vibe coding」是近年流行的一种 AI 辅助开发方式,指开发者以自然语言描述需求、由 AI 模型(如 GPT、Claude 等)直接生成可运行代码,开发者主要负责方向把控与结果验证,而非逐行编写。这种方式大幅降低了原型开发的时间成本,尤其适合快速验证 API 能力。Simon Willison 此次使用的 GPT-6 Astra 即属于此类工具,整个 Playground 从界面到逻辑均由 AI 生成,作者本人只需审查最终效果是否符合预期。CORS(跨域资源共享)策略的开放,则是这种纯前端方案得以实现的技术前提——Google 允许浏览器直接向 Gemini API 发起请求,无需中间服务器转发,从而实现了零后端部署。
多角色对话是真正的杀手锏
这套 API 一个突出的能力,是可以轻松定义多个角色之间的完整对话,每个角色拥有不同的音色和语音风格指令(delivery style)。
Simon 用一段两只鹈鹕争论是否搬去 Pacifica Pier 的对话做了演示。角色 Gus 使用 Puck 音色,语气是「excited and gossipy(兴奋又八卦)」;角色 Pearl 使用 Kore 音色,语气则是「calm and unimpressed(冷静而不以为然)」。剧本由 Claude 4.5 Opus 生成,并直接输出一个可用于渲染的 URL——从写脚本到生成音频,整个链路几乎完全由 AI 驱动。
这种「一个人给多个角色配不同声音和情绪」的能力,对播客制作、有声内容、游戏配音等场景来说,是极具想象空间的。
传统 TTS 方案若要实现多角色对话音频,通常需要对每段台词分别调用 API、手动拼接音频片段,且不同角色的语速、停顿节奏往往难以自然衔接。Gemini 3.8 TTS 的多角色原生支持意味着模型在单次推理中即可感知整段对话的上下文,角色切换时的节奏感和情绪过渡由模型统一调度,而非拼接后期处理。「Delivery style」(播报风格)指令是另一个关键维度,开发者可以用自然语言描述角色说话时的情绪状态——如「anxious and whispering」或「boisterous and loud」——模型会将其映射到语速、音调起伏、停顿节拍等声学特征上,无需调整任何底层音频参数。
速度与成本实测
性能数据也很直观:使用 Gemini 3.8 Flash TTS(注意不是更便宜的 Flash-Lite),生成 1 分 18 秒的音频只花了约 20 秒,成本为 2.74 美分。
换算下来,一分多钟的多角色对话音频,成本不到 3 美分、耗时不到半分钟。这样的性价比让高质量语音合成从「偶尔尝鲜」变成了可以规模化使用的生产工具。如果换用 Flash-Lite 版本,成本还会进一步下降。
小结
Gemini 3.8 TTS 的组合拳——超两千音色、30 秒语音克隆、原生多角色对话、低廉的成本——把文本转语音的实用性拉高了一个台阶。而 Simon Willison 这个自带密钥的 Playground,则提供了一个零后端、可分享、透明可查的实验入口,是想快速上手这套 API 的人值得一试的工具。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。