Gemini 4 Argon 实测:12个演示展示3D世界与游戏生成能力

Gemini 4 Argon 在 3D 与游戏生成上表现惊艳,物理模拟仍是短板,Google 重回第一梯队。
Gemini 4 Argon 正式发布后,一位 B 站创作者通过 12 个实测案例展示了其能力边界。3D 世界生成表现突出,可将油画、户型图转化为可漫游空间,但需使用结构化提示词避免触发图像生成。游戏生成是强项,一句话即可生成可玩原型乃至内含 20 个应用的虚拟电脑。物理模拟是明显短板,5000 块砖场景出现悬浮与自行崩塌。实用任务中,Google 生态的原生集成(搜索+Sheets)成为相对 Claude 和 ChatGPT 的差异化优势,但新 Tasks 功能稳定性不足。与 Claude Opus 对比,同一 3D 场景构建速度快约 10 倍。中国用户可通过 API 折扣、Antigravity 平台和 Gemini Skills 跟进,但需评估网络与账号条件。
Gemini 4 Argon 正式发布,Google 在 AI 竞赛中重新找回节奏。一位获得早期访问权限的 B站创作者用连续数天的实测,展示了这款新模型在 3D 世界构建、物理渲染、游戏生成和实用任务上的 12 个案例。以下是这些演示的核心看点与中国用户的实用参考。
3D 生成:从一张油画到可漫游空间
最直观的跃升体现在 3D 世界生成上。创作者上传了一幅梵高画作,要求将其转化为可交互的 3D 房间。模型不仅构建出可自由行走的空间,还把画作中的粒子漂浮效果还原到了三维场景中,细节密度超出预期。
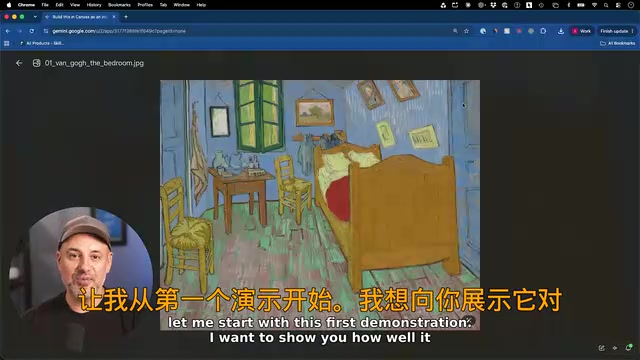
这里有一个值得注意的提示词技巧:直接用简单描述会触发内置的 nano banana 图像生成能力,模型会不断输出静态图片而非可交互应用。创作者改用"在 canvas 中构建交互式应用并在此预览"的结构化指令后,才得到理想的 3D 场景。类似的案例还包括将平面户型图转化为可第一人称漫游的 3D 房屋,屏幕上叠加大户型图并实时标注当前位置,甚至支持夜间模式。
这种能力对室内设计、游戏原型和空间规划类工作流有直接价值。
文中提到的「nano banana 图像生成能力」值得展开说明。据目前公开信息推测,nano banana 是 Google 内部为 Gemini 系列配备的轻量级图像生成模块,定位类似辅助渲染器:当模型判断任务属于「静态图像产出」而非「可执行代码」时,会自动调度它来快速出图。这种自动路由机制的好处是响应快、视觉质量稳定,但副作用也很明显——用户想要可交互应用时,模型却不停返回图片。因此创作者总结出的「在 canvas 中构建交互式应用并在此预览」这类结构化指令,本质上是在强制模型选择代码生成路径,而非图像生成路径。理解这一机制,有助于开发者在实际使用中通过提示词工程稳定控制输出类型。
物理模拟:进步明显,但仍有硬伤
物理渲染是本次测试中最能体现 Gemini 4 边界的地方。创作者要求生成一座城市并用拆楼锤击碎建筑,设定 5000 块砖的物理量。结果并不理想:砖块悬浮、锤子尚未挥动城市已自行崩塌,物理引擎的表现明显失控。
改用更简单的第二版后,悬浮砖块消失、物理表现有所改善,但仍未达到可用水准。值得一提的是,简化版本支持切换视角,甚至能从街道视角观察,交互设计反而更完整。
结论很明确:Gemini 4 在 3D 场景生成上令人惊艳,但在真实物理模拟上仍需等待下一轮迭代。如果你的项目依赖精确物理反馈,现阶段不建议直接用于生产。
「物理引擎表现失控」并不等同于模型本身具备真实的物理仿真能力。当前大模型生成 3D 场景中的物理效果,通常是靠生成 JavaScript 物理库(如 Cannon.js、Rapier)的调用代码,而非模型内部建立了精确的物理世界模型。砖块悬浮、未击中即崩塌,往往源于模型对碰撞体尺寸、质量、约束条件的代码参数估计错误,而非引擎本身的缺陷。这也解释了为何简化场景后表现明显改善:物体数量减少,模型需要推理的约束关系随之下降,出错概率自然降低。换言之,物理模拟的短板更多是「代码生成精度」问题,而非「理解物理」问题,随着模型推理能力提升,这一短板有望较快改善。
游戏生成:一句话生成可玩原型
游戏生成是 Gemini 4 的强项。创作者将手绘草图交给模型,要求生成与草图一致的可玩游戏。第一次用简单提示词,模型又走了图像生成的老路,输出了一张漂亮但无法游玩的图片。改用结构化提示后,模型准确还原了草图布局,角色可以像马里奥一样跳跃移动。
另外几个游戏案例包括:一键还原的三阶魔方、带速度调节的过山车园区、以及能生成原创曲目的音乐工作室应用。最极端的测试是要求构建一整台虚拟电脑,内含 20 个可用应用——文件管理器、画图工具、计算器、贪吃蛇、扫雷等,全部支持多窗口同时打开。
Google 同步在 labs.google/playground 上线了游戏创作空间,用户可以直接浏览他人作品或创建自己的游戏。
实用任务:Google 生态的原生优势
在一项规划派对的任务中,模型调用搜索能力,对比了五家场地并自动生成 Google Sheet。
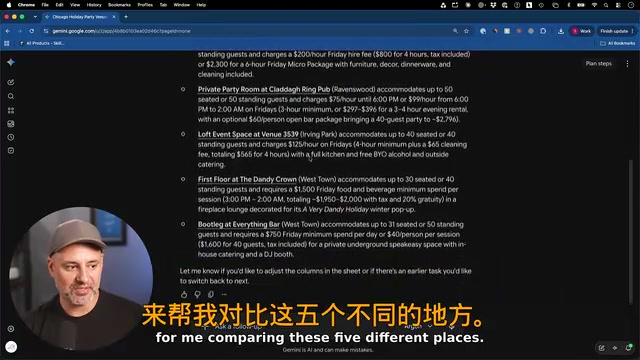
这是 Gemini 相对 Claude 和 ChatGPT 的独特优势:由于同属 Google 生态,Docs、Sheets、Drive 的调用是原生集成,无需第三方连接器,体验更顺畅。不过创作者也遇到问题:用新的 Tasks 功能处理多格式文件时,运行 30 分钟仍未产出演示文稿;改用普通对话模式,一分钟内就完成了任务。Tasks 的稳定性还有待观察。
Gemini Skills 是 Google 此前推出的可复用指令集机制,可理解为面向重复性任务的「技能包」:开发者或用户把一类任务的提示词、工具调用流程、输出格式固化成模板,之后只需触发技能名即可复用。与 Gemini 4 组合使用时,Skills 能显著降低提示词调试成本,尤其适合文档处理、数据分析、日程规划等高频场景。文中提到的 Tasks 功能则更偏向「自动多步执行器」,负责把复杂任务拆解为子步骤并依次调用工具。两者定位不同:Skills 侧重固化流程,Tasks 侧重自主编排。目前 Tasks 的稳定性问题提示,自主编排类功能在复杂多格式输入下仍易失控,而 Skills 这类确定性更强的机制反而更可靠,值得优先尝试。
与 Claude 的对比:速度差距悬殊
创作者用同一个古罗马 3D 场景做了跨平台对比。Gemini 4 大约 5 分钟完成构建,Claude(Opus 版本、思考等级调至最高)耗时超过一小时,相差约 10 倍。
功能丰富度上 Gemini 版本也更胜一筹,支持光照切换和快速旅行,而 Claude 版本缺少部分设置项。不过创作者也指出,Claude 版本的画面风格同样出色。速度与功能上的综合优势,是 Gemini 4 本轮竞争中最具说服力的卖点。
「思考等级调至最高」指的是 Claude 系列提供的扩展思考(extended thinking)能力。用户可以为模型分配一段额外的内部推理预算,让它先进行更长的逐步思考再给出结果。提高思考等级通常能提升复杂任务的准确率,代价是响应时间显著拉长,因此一小时完成一个 3D 场景并不意外。Gemini 4 约 5 分钟完成同类任务,可能得益于更高效的推理调度或更激进的并行策略,但也可能牺牲了部分深度校验。因此「10 倍速度差距」的对比需要放在各自默认的推理配置下理解:若把 Gemini 4 的推理强度调到同等水平,差距可能缩小。开发者在选型时应结合自身对速度与精度的实际需求,而非单纯看单次对比数据。
中国用户如何跟进
对中国开发者而言,几个实际信息值得关注:Gemini 4 已同时接入 Gemini App 和 API,API 目前处于折扣定价阶段;模型已集成到 Google 的编程平台 Antigravity;此前发布的 Gemini Skills 体系可与 Gemini 4 组合使用,帮助固化重复性任务的指令集。
需要提醒的是,创作者的部分演示依赖 Google AI Pro 或 Ultra 订阅,且大量功能深度绑定 Google 自有生态。国内用户若想复用这些工作流,需要自行评估网络与账号条件的可行性。
从这批演示看,Gemini 4 Argon 最大的突破集中在代码生成与 3D 建构,物理模拟仍是短板。Google 重新回到第一梯队的信号很明确,但距离全面领先还有距离。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。