Gemini 4 Argon 实测:写网文能碾压其他AI模型?

Gemini 4 Argon网文实测表现出色,但结论依赖特定工具链,稳定性与长期能力仍待验证。
本文结合B站UP主的实测视频,从生成质量、工作流整合与实际限制三个维度评估Gemini 4 Argon的网文写作能力。开篇生成测试显示,模型在对话节奏、爽点密度和天赋设定展开上确有明显进步,500字内节奏紧凑,网感接近人类作者水平。视频还展示了星月协作的完整章纲流工作流,串联脑洞生成、黄金开篇、大纲续写、角色卡与知识库联动,形成章纲到正文的循环迭代。但文章同时提示若干保留意见:自审评分存在天然偏差、效果高度依赖特定工具链、模型上线初期算力表现可能回落、短期样本不足以验证长篇的伏笔回收与节奏把控。总体判断是AI写网文已进入工作流竞争阶段。
Gemini 4 Argon 上线,AI写小说的能力真的断档了吗?
B站UP主发布了一段关于Gemini 4 Argon(视频称"真人类4.0")的实测视频,展示了这款新模型在网文创作场景下的生成效果。视频中的核心结论相当有冲击力:UP主认为Gemini 4 Argon在网文写作上的表现"碾压其他所有模型",成品几乎不需要怎么修改就能达到可发布水平。
这个评价是否经得起推敲?本文结合实测内容,从生成质量、工作流整合和实际限制三个维度展开分析。
黄金开篇实测:网感和节奏到底如何?
UP主在星月协作工具中使用"黄金开篇生成器"进行测试,输入了一段相对简单的提示词:悬疑脑洞文开局,十个神奇天赋中选三个,出现一个可爱女角色,无系统搞笑风格,穿插威胁事件,结尾留钩子。
在完全不关联任何外部文本、仅依靠提示词的情况下,Gemini 4 Argon一次性生成了开篇正文。UP主特别指出,光是"高台之上一个满脸横肉的拍卖师正唾沫横飞的敲着铜锤"这一句,就足以看出它跟上一代模型(视频中称为"真人3.1pro")的写作风格完全不同。
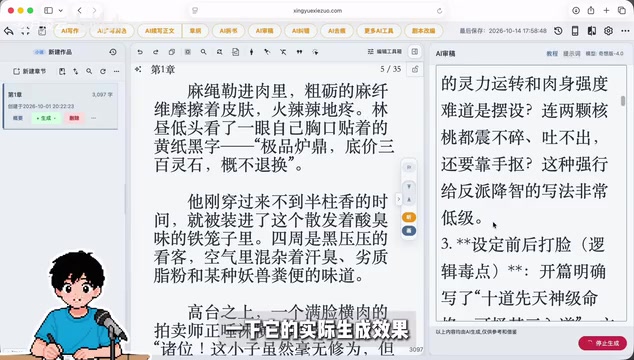
对话生成是这段测试中最出彩的部分。拍卖师的对白——"诸位这小子虽然毫无修为但天生纯阳绝脉乃是黑风寨大当家亲自从乱葬岗刨出来的活宝谁拍下他今晚就能直接加锅炖了"——加上台下哄堂大笑和"张老魔你牙口不好不如买回家去给你家老祖当夜壶"的调侃,确实呈现出了相当自然的网文对话节奏。
主角自白和金手指的切入也非常迅速。UP主强调,这是在没有任何增添删改和修改的情况下直接生成的,前500字的剧情节奏已经非常紧凑。天赋实现三、迅速扫过十块十倍、独尊万古长青、天生魅魔、百分百空手接白刃等设定也按需求依次展开。
模型自审稿:AI给自己打分能说明什么?
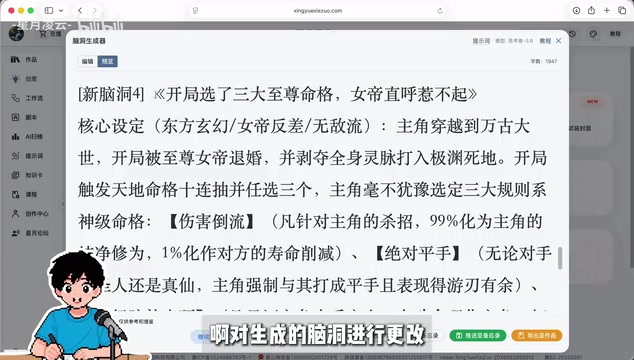
一个有意思的环节是UP主使用了星月协作内置的AI审稿功能,让Gemini 4 Argon对自己的生成内容进行评分。审稿结果给出了七个章节名备选,以及章节评分和详细评语。
评语中提到"开篇切入迅速没有冗长的背景介绍,直接将主角放在黑风寨拍卖场的铁笼子里,危机感营造到位"。
需要客观看待的是,让模型自审本质上是用同一个模型做自我评价,其评分的参考价值有限。但审稿功能中"问题语句"的识别和读点分析,对实际创作者来说确实有实用价值。
LLM-as-a-Judge 是近两年评测领域常用的方法,即用一个能力较强的语言模型去给另一个模型(或自己)的输出打分、排序或写评语。它成本低、速度快,能在没有人工标注的情况下做大批量筛选。但它有两个公认的缺陷:一是自我偏好偏差(self-preference bias),模型倾向于给风格与自己相似的输出更高分;二是位置偏差和长度偏差,同一段内容换个顺序或加长篇幅,评分就可能波动。因此业界更稳妥的做法是让评审模型与生成模型分属不同家族,或者引入人工抽检做校准。回到本文场景,让 Gemini 4 Argon 审自己的稿,本质上更接近"能力演示"而非"质量认证",它的价值在于能快速指出病句、节奏拖沓、钩子不足等结构性问题,而不是那个总分。
章纲流工作流:从脑洞到正文的完整链路
视频后半段展示了星月协作的完整创作流程,这套工作流的设计思路值得关注。
脑洞生成与筛选
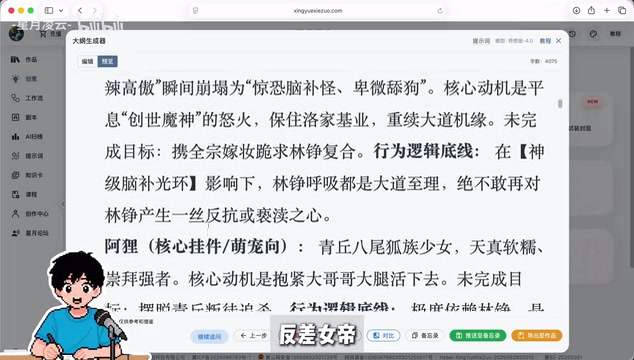
用户可以先通过脑洞生成器生成多个方向的创意,视频中生成了五个脑洞供选择,包括"开局选了三大至尊命格女帝直呼惹不起"的女帝退婚流,以及"神级脑补光环"的迪化文。不同提示词模板会产出不同风格的脑洞,创作者可以从中选取或混搭。
黄金开篇到章纲落地
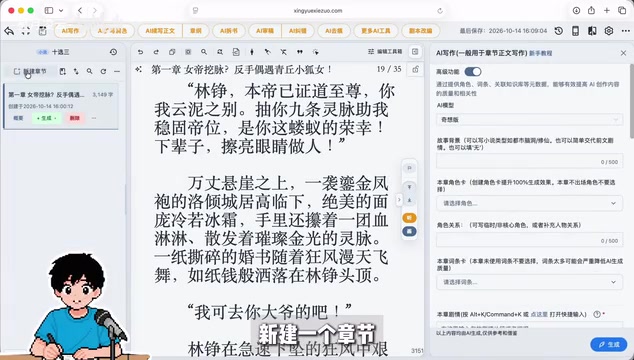
选定脑洞后,将其填入黄金开篇生成器的补充信息区域,生成第一章正文。随后通过大纲生成器,关联已创建的作品和第一章正文,生成十章细纲。视频中提到,细纲生成会先梳理前文核心总结,指出未解决的核心冲突,并提供人物锚点分析和伏笔清单。
角色卡与知识库联动
一个比较关键的细节是角色一致性管理。UP主先将章纲中的人物锚点信息复制到角色库,通过智能识别自动导入角色性格和背景设定。在后续章节生成时,勾选对应的角色卡并关联备忘录中的章纲,模型就能保持人设的连贯性。
第二章生成实测中,由于配置了幽默人设,男主回答问题时出现了"几百万年没刷牙了口臭这么重还到处扬威能不能讲点公共卫生,然后视天魔地发怒"这样的桥段,前文铺垫的"绝对平手"规则也直接给出了爽点,单章生成字数达到3918字。
角色卡(Character Card) 与 知识库(Knowledge Base / RAG) 解决的是长文本生成中的"人设漂移"问题。大语言模型没有跨会话的持久记忆,上下文窗口之外的信息它一律看不见,所以写到第十章时,模型很可能已经忘了第三章交代过主角不能吃辣。角色卡把人物的姓名、外貌、性格、口头禅、禁忌等打包成固定条目,每次生成时随提示词一起注入;知识库则把章纲、设定集、前文摘要向量化存储,按相关度检索后拼进上下文。这套机制的技术名称是检索增强生成(Retrieval-Augmented Generation, RAG)。它的边界也很清楚:检索命中率取决于切分粒度和嵌入模型质量,条目太多还会挤占本就不宽裕的上下文预算,导致"记得住人设,记不住剧情"。
章纲续写与循环迭代
当十章大纲用完后,可以使用AI续写章纲功能,基于前文继续发散后续三章的剧情点。视频中新增了"呆萌剑灵小楼地"这个角色,展示了章纲→正文→新章纲的循环迭代流程。
章纲流(有的团队叫"细纲驱动"或"从大纲到正文的瀑布式生成")是当前网文 AI 写作的主流范式,核心思路是分层降维:先用一句话脑洞定方向,再扩成章节梗概,再扩成包含冲突点、情绪曲线、钩子的细纲,最后才落成正文。这样做的好处是每一层都可以人工干预和回滚,出错时改的是纲而不是几万字正文;同时细纲本身构成一份压缩上下文,缓解了长篇小说"越写越忘"的问题。代价则是层级越多,创意在逐级展开中越容易被磨平,最终产出偏于工整但缺乏意外之喜——这也是很多读者反映 AI 文"套路感强"的原因之一。判断一套章纲流工具好不好用,关键看它能否在续写章纲时主动引入新变量,而不是把已有冲突反复翻炒。
冷静看待:几个需要注意的问题
UP主的评价相当高,但有几个方面需要创作者保持清醒。
模型输出的稳定性问题。 UP主自己也提到"所有模型刚出来的时候生成效果是最惊艳的,过一段时间可能算力就有所下降",这是AI模型服务中确实存在的现象。
工具绑定。 整个实测都是在星月协作这个特定工具中完成的,模型能力的展现很大程度上依赖于工具侧的提示词工程和知识库配置。脱离这套工具链,纯API调用能否达到同样效果,视频并未展示。
自评自审的局限性。 AI审稿功能虽然实用,但模型给自己打分存在天然偏差,创作者不应完全依赖评分来判断内容质量。
样本量。 视频展示了第一章和第二章的生成效果,对于长篇小说而言,人物弧光、伏笔回收、中后期节奏把控等更复杂的能力,短期测试很难充分验证。
对AI写作工具市场的意味
抛开"碾压所有模型"的结论是否成立不谈,这次实测至少说明一个趋势:AI写网文已经从"能不能写"进入到了"工作流怎么搭"的阶段。
单纯的模型生成能力在提升,但真正影响创作者效率的,是脑洞筛选、章纲管理、角色卡联动、知识库关联这一整套工程化流程。Gemini 4 Argon在文本质量和网感上的表现确实有进步,而围绕它构建的工具链,才是决定实际创作体验的关键变量。
对AI写作感兴趣的创作者,值得亲自上手测试,但建议同时保持对模型输出质量和稳定性的持续观察。
相关推荐

WorkBuddy全流程教程:从零搭建AI办公自动化智能体
WorkBuddy 全流程教程精讲:从下载安装、三种工作模式到多模态绘本视频实战,再到专家团搭建智能体与工作流配置,帮你用低成本 AI Agent 实现办公自动化。

WorkBuddy智能体全攻略:7天从入门到自动化实战
基于B站256集WorkBuddy全套精讲课程,系统拆解腾讯AI办公工作台的核心能力:Agent原理、Skill封装、连接器跨平台、定时自动化、知识库与零代码开发,附学习路径建议。

8个AI账号翻车7个:我用AI干活的真实复盘
B站8个AI运营账号仅1个跑通。本文拆解"演AI"与"用AI干活"的本质区别,分析5条视频217万播放背后的产能控制、评论区运营和交付节奏策略。