Gemini 4 Argon vs GPT-6 Astra:视觉任务全面对比

Gemini 4 Argon在多数视觉基准领先且成本仅为Astra的1/4-1/6,但OCR推理与速度仍是短板。
Roboflow的Peter基于自建基准测试了Google Gemini 4 Argon与OpenAI GPT-6 Astra在目标检测、分割、OCR和视频任务上的表现。Argon在目标检测中重夺第一,但需特定的0-1000坐标归一化与y在前提示格式,并支持框提示及正负样本;它是首个能分割带孔洞和分离部分对象的模型,但每图约需2分钟。OCR细分任务中,Google模型在单字符串提取上领先,机械电表等需推理案例仍会出错,结构化JSON提取约90%,文本定位识别准确率60-80%。成本上Argon实际运行比Astra低4-6倍。通过提示工程与插值,Argon可实现视频球员重识别,但关键点检测尚不稳定。
在Roboflow的直播中,Peter详细测试了Google新发布的Gemini 4 Argon与OpenAI的GPT-6 Astra在目标检测、分割、OCR等视觉任务上的表现。基于多个来源的测试数据,Argon在多数基准测试中领先,但在某些OCR任务中Astra和Soul表现更佳。
目标检测:Argon登顶,但Gemini需专用提示
Peter团队长期维护一个目标检测基准,此前Gemini模型曾领先,但近期OpenAI和Anthropic的模型表现提升,Gemini排名下滑。Argon发布后,它重新夺回第一,并在几乎所有基准测试中领先。
Argon对提示格式有特定要求:坐标需从0到1000归一化,且y坐标在前。团队尝试了20-30种提示组合才找到最优解。测试图像包括重叠的胡萝卜、卫星香蕉树、乐高积木和棋盘等,Argon均能较好处理。
框提示与正负样本
除了文本提示,Argon还支持框提示(box prompting),即通过绘制边界框来指示目标。与Astra和Qwen不同,Argon对文本和框提示均能良好响应。此外,用户可提供正样本和负样本框,帮助模型区分特定类别。例如,在足球场中仅标注穿深色球衣的球员,Argon能理解负样本并排除其他人员。
框提示(box prompting) 是视觉语言模型的一种交互方式:用户直接在图像上绘制边界框,而非仅用文字描述目标,模型据此定位或分割。与文本提示相比,框提示能更精确地传达空间位置与目标范围,尤其适用于文字难以描述的形状或密集场景。正样本框标出希望模型识别的目标实例,负样本框则标出应被排除的相似干扰物(如不同颜色的球衣),模型通过对比学习区分二者。这种机制让模型在少样本条件下快速适配特定类别,无需重新训练,是通用视觉模型走向实用化的重要能力。
图像分割:支持孔洞与分离掩码
Argon是首个能处理带孔洞对象和分离部分的分割模型。例如,对于带孔的甜甜圈或分离的胡萝卜,Argon能生成包含内部孔洞的掩码,而Astra则生成实心掩码。此外,Argon能识别分离的掩码部分,如堆叠包裹中的独立部分。
然而,分割任务耗时较长,每张图像约需2分钟,而传统模型如Soul可在亚秒级完成。Peter认为,当前分割技术类似一两年前的目标检测,预计一年内将大幅提速。
掩码(mask) 是图像分割的输出形式,为每个像素赋予类别或实例标签,从而精确勾勒目标轮廓。传统分割模型常输出实心掩码,即把目标内部全部填充,难以表达中空结构(如甜甜圈、带孔零件)或由多个不相连部分组成的对象(如堆叠包裹中的独立个体)。能生成带孔洞的掩码和分离掩码,意味着模型理解了目标的拓扑结构,而非仅做区域填充。这对工业质检、医学影像和遥感等需要精确边界的场景尤为关键,也是评估分割模型精细度的重要维度。
OCR:细分任务表现各异
Roboflow更新了OCR基准,分为四个子任务:单字符串提取、转录、结构化JSON提取和文本定位与识别。
单字符串提取
Google模型在此任务上表现突出,Argon能处理低分辨率、反光、小字体等困难场景。但面对需推理的案例(如机械式电表),Argon仍会出错,例如将5读成9。
结构化JSON提取
模型在收据、营养标签等任务上得分较高(约90%),但手写医疗处方和支票仍错误较多。若将表格作为单张图像输入,Argon准确率约85%。
文本定位与识别
该任务要求定位并读取图像中的文本,如平面图尺寸、地图标签、PCB板文字。Argon在困难案例上的准确率约60-80%,是目前最佳选择,但可能仍不足以解决某些业务问题。
效率与成本:Argon比Astra便宜4-6倍
Argon处理单张图像约需20秒,速度较慢但能力强大。按token单价计算,Astra是Argon的两倍,但实际运行中,由于Astra消耗更多token(可能因思考链),完成相同任务的成本是Argon的4-6倍。
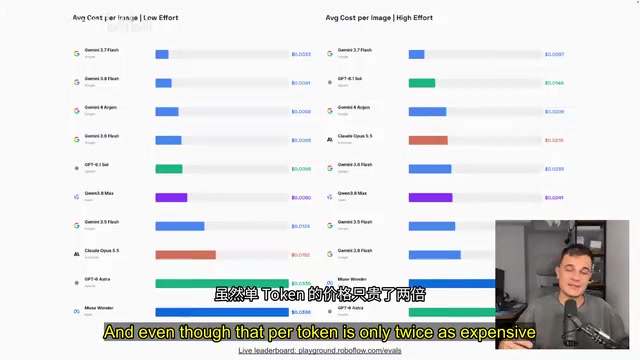
Token 是大模型处理文本与图像的基本计量单位,API 按输入和输出 token 数量计费。视觉任务中,图像会被编码为大量视觉 token,模型推理时还会产生输出 token。部分模型(如 Astra)采用思考链(chain-of-thought) 式推理,在给出答案前生成大量中间推理 token,导致单次任务的实际 token 消耗远高于标称单价所反映的水平。因此,比较模型成本时不能只看每 token 单价,还需结合实际 token 用量,这也是 Astra 单 token 价格为 Argon 两倍、但实际任务成本高达 4-6 倍的原因。
视频与重识别:跨帧追踪可行
Argon虽非视频模型,但通过巧妙提示工程可处理视频任务。在篮球比赛重识别测试中,Argon能跨帧匹配球员ID,即使球员被遮挡也能保持一致性。Peter每半秒运行一次提示,并在关键帧之间插值边界框,实现了平滑追踪。该方法在多个比赛中验证有效。
关键点检测与自动标注
Argon能根据参考图像检测关键点,如手部姿势或人体姿态,但用于篮球场关键点自动标注时结果仍不稳定,存在抖动和精度不足的问题。Peter认为该方向有前景,但尚未成熟。
重识别(re-identification) 指在视频不同帧或不同摄像头画面中,判断某个目标是否为同一实体,常用于球员追踪、客流分析等场景。由于遮挡、姿态变化和光照差异,重识别需要模型具备稳定的身份特征提取能力。Argon 并非原生视频模型,但通过提示工程——每半秒对关键帧运行一次检测提示,再在关键帧之间插值边界框——可模拟连续追踪效果。插值即根据前后两帧的位置线性推算中间帧的框坐标,从而在不逐帧推理的情况下获得平滑轨迹,兼顾效果与计算成本。
总结与展望
Gemini 4 Argon在多数视觉基准测试中表现最佳,尤其在目标检测和分割任务上,且成本效益显著。然而,OCR的某些子任务(如单字符串提取)上Google模型仍面临挑战,而Astra和Soul在特定场景下表现更优。随着模型迭代,视觉任务的准确性和效率有望进一步提升,为自动标注和业务应用带来新可能。
相关推荐

一句提示词引发的全球PHP安全风暴:AI是救星还是隐患?
一句AI提示词竟引发全球PHP安全危机,维基百科、互联网档案馆受波及。本文梳理事件脉络,解析OpenAI与亚马逊的争议,探讨AI时代漏洞发现门槛降低带来的安全悖论与开发者应对策略。

当AI被拿走:依赖捷径如何削弱你的解题韧性
一项涉及1,222人的研究发现:使用AI答题后,一旦AI被移除,人们放弃解题的比例高于从未使用AI的对照组。文章分析AI依赖对学习韧性和元认知的影响,并探讨AI学习工具的设计启示。

Carta联手NewView:让创业公司员工提前套现股权
Carta 与 NewView Capital 合作推出新计划,简化创业公司 tender offer 流程,帮助员工提前出售股权套现。本文分析该合作的核心机制、员工股权流动性痛点及对创业公司股权激励的影响。