Gemini 4 Argon vs Opus 5.5与GPT-6.1 Sol:12道题实测,3道打开即崩

Gemini 4 Argon 在同题对决中垫底,症结不在能力而在无法自我验证。
谷歌 Gemini 4 Argon 与 Claude Opus 5.5、GPT-6.1 Sol 同答 12 道题,分别以 0 胜 5 平 7 负和 2 胜 4 平 6 负排名垫底。更值得拆解的是输法:三道题打开即崩,根源都是小错误——变量作用域失误、代码少一个空格、引用不存在的网址,而 Argon 在 App 内无法自行打开页面检查改错,Opus 和 GPT 则借助命令行 Agent 形成自我验证闭环。细节题上 Argon 也频繁露馅:蝴蝶连杆方向反了、折纸天鹅从中缝裂开、封面凭空多出纸飞机、西瓜过曝成白片。但它并非全面落败:读图五连测五道全对与 Opus 持平,原创游戏与 Opus 打平并明确赢 GPT。额度上 14 次 High 档生成仅用掉 Pro 时段额度 40%、周额度 2%。核心结论是 Argon 能力不弱,短板在无法自我验证,拿其产出务必先实跑。
谷歌在 Gemini 3.1 Pro 之后沉寂了相当长一段时间,终于端出了 Gemini 4 Argon。B站UP主「回到Axton」把它和 Claude Opus 5.5、GPT-6.1 Sol 放在同一张考卷前——12 道题,涵盖看图答题、3D 动画、交互工具和小游戏,提示词完全一致,全程不追加任何补充说明。结果颇具戏剧性:Argon 对 Opus 5.5 是 0 胜 5 平 7 负,对 GPT-6.1 Sol 是 2 胜 4 平 6 负,三家里排名垫底。
但比输赢更值得拆解的,是输的方式。
三道「打开就坏」的题:小错误,大崩塌
铁路调度:一行变量作用域毁掉整页
第一道题要求做一个模型铁路沙盘:至少三列火车共用一套轨道,有岔道、有信号灯,火车自动变道、红灯停车,全程无人干预且永不相撞。
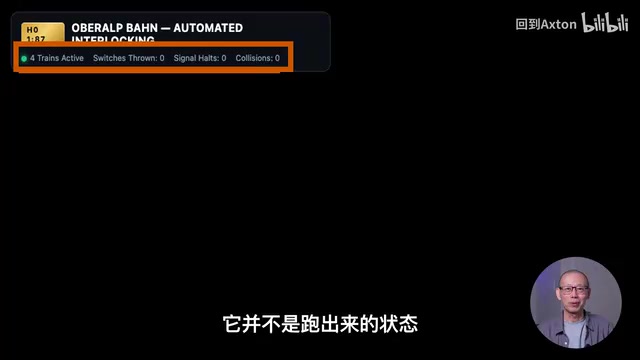
Opus 5.5 放了五列车,轨道有交叉道口,跑满五分钟零碰撞;GPT-6.1 Sol 三列车绕圈,同样稳定。Argon 这边却是一片纯黑,屏幕上只写着一行「4 Train Active, Collision 0」——看着像在跑,其实那只是写死的文字,并非实时状态。
翻代码就找到了病根:一个变量定义在另一个函数内部,调用时根本找不到,整个脚本直接停摆。同样的 12 道题里,Opus 和 GPT 用的是命令行 Agent,能自己打开页面检查、自己改错;而 Axton 测试 Argon 时只能在 Gemini App 里跑,Pro 账号当时还没开放 Anti-Gravity 命令行终端权限,思考档位开到 High,也只能一次写完直接交卷——没有自我验证的余地。
据 Axton 的不计分实验,把那个作用域问题补上,四列车立刻能跑满五分钟;把咖啡店代码里漏掉的一个空格补回,五页数据也瞬间联动。这两道题都属于「一行代码可救」的范畴。
变量作用域(Variable Scope) 是编程语言里的基础机制,它规定了某个变量在代码的哪些位置能被访问到。大多数语言采用块级或函数级作用域:定义在一个函数内部的变量,函数外部或其他函数默认看不见。当代码在另一个函数里引用这个变量时,运行时就会抛出「未定义」错误,脚本随即停止执行。这类错误往往不会让页面白屏报错,而是让后面的逻辑全部卡死,屏幕上只留下此前渲染出的静态文字。对 AI 生成代码而言,作用域问题尤其隐蔽——模型凭「记忆」写出调用关系,却无法在生成时真正执行验证,因此一个跨函数的引用失误就能让整份交互作品变成一张静止的截图。这也是「能写」与「能跑」之间最典型的鸿沟。
咖啡店季报:少一个空格,五页全废
题目是给老板做一份咖啡店季度汇报,五页涵盖收入、成本、利润和下季度建议。给定日均杯数、客单价、成本率、房租等数据,还要配一个滑块——拖动后所有数字和结论必须实时重算。
第一页算得一分不差,销量往下拖到亏损时结论也会改口。但翻到第二页就彻底不动了,第五页数字完全不更新,利润页不管怎么拖都停在 289080。原因是代码里两个词之间少打了一个空格,粘成了同一个标识符。Opus 和 GPT 在这道题上五页全部实时联动,Opus 拖到 150 杯标题会立刻改成「已逼近保本线」,GPT 转亏时利润卡从绿变红。
命令行 Agent(CLI Agent) 指能在本地终端里直接调用工具、执行命令、读写文件并观察结果的 AI 智能体。与网页版聊天窗口相比,它多出一个关键能力:自我验证闭环——生成代码后可自行运行、看到报错、定位问题、再修改,循环直到通过。这恰好解释了文中三款模型的差距来源。Opus 5.5 和 GPT-6.1 Sol 在测试中走的是命令行 Agent 路径,能自己打开页面检查、发现「第二页不动」后回改代码;而 Argon 当时只能在 Gemini App 对话框里一次成稿,没有执行与回看的权限,错误一旦写进去便无人纠正。因此同样的 12 道题,比的其实不只是模型智力,还有是否被允许自己检查作业。
四季成因:一个不存在的网址
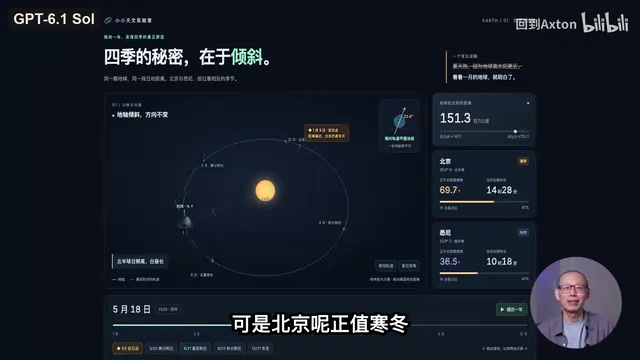
这道题是做一个 3D 讲解,纠正「夏天热是因为地球离太阳更近」的误解,拖动日期时地球沿轨道运行,实时显示日地距离、北京和悉尼的正午太阳高度与昼长。
Argon 引用了一个根本不存在的网址,3D 画面加载不出来,滑块拖不动,日期和数字永远停在 6 月 21 日。Opus 和 GPT 都做对了:拖到 1 月 3 日,Opus 在屏幕正上方弹出橙色横幅——「离太阳最近,可北京正值寒冬」,GPT 则在左下角给出小字提示。
幻觉引用(Hallucinated Reference) 是大模型常见的一种错误:模型在需要外部资源时,会生成一个格式正确、看起来合理、但实际并不存在的 URL、库名或 API。它并非故意撒谎,而是语言模型按概率续写文本的副产品——「像网址的字符串」比「确认存在的网址」更容易被生成。在纯文本问答里,这种错误顶多让人点开一个 404;但在需要加载 3D 模型、贴图或第三方脚本的交互网页中,一个假链接会直接让渲染管线断掉:画面加载不出来,绑定其上的滑块、日期、数值全部失去联动,停在初始状态。文中「3D 讲解停在 6 月 21 日」正是这一链条的末端表现,也说明对生成式代码做联网资源核验有多重要。
蝴蝶、折纸与封面:细节里的胜负手
机械蝴蝶是三家差距最有意思的一道。要求 3D 建模一只镂空金属玻璃翅膀的蝴蝶,齿轮连杆带动翅膀,还要有拆解按钮。Opus 的蓝色玻璃翅膀、GPT 的玻璃配金线标本都相当精致,Argon 的金色齿轮蝴蝶第一眼最惊艳——齿轮真的按齿数在啮合转动。但盯着连杆看就露馅了:Opus 和 GPT 的连杆长度固定,是连杆推着翅膀动;Argon 的连杆每一帧都在自己伸缩去「够」翅膀,方向反了。
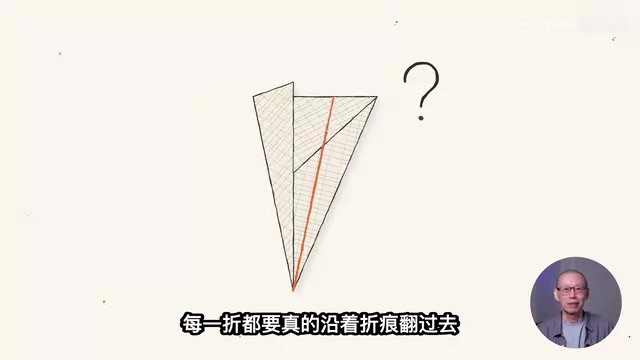
折纸题让一张纸逐步折成作品并回展循环。Argon 折了九步天鹅,功能最全——换纸色、慢放、跳步都有;Opus 折 18 步千纸鹤,但约一半概率在第 22 秒黑屏;GPT 折八步纸飞机。可惜 Argon 在折天鹅脖子时整张纸从中缝裂成两半。
书籍封面重构要求把封面改成宋刻本、木刻、瑞士国际主义、八十年代霓虹等风格,文字不能丢、不能贴原图。三家都没写错字,Opus 的宋刻本最像真古籍。但 Argon 三个版本里每一版都多画了一架原封面根本没有的纸飞机,立方体裂缝里还自己脑补了一块金色补块。
西瓜勒橡皮筋小游戏,Opus 和 GPT 都是绿皮红瓤、勒成沙漏、炸开满地碎瓤瓜子;Argon 的变形交互全做到了,端上来的西瓜却过曝成一片薄荷白。
Axton 的观察很精准:第一眼最精致、功能堆得最多的常常是 Argon,可一旦让它动起来、或者停下来抠细节,差距就出来了。
Argon 赢在哪:读图五连测与原创游戏
Argon 也有明确的高光。看图五连测——读钟表时间、数鸡蛋、找两张图的不同、抄手写信里的一行字——Argon 五道全对,和 Opus 持平,GPT 对四道。看钟表那道题尤其典型:GPT 在写依据时已经读出 28 到 29 分,最后却交了个「看不清」;Argon 毫不犹豫报出 10:29。
原创游戏大题要求设计一款能展示能力的原创游戏,三分钟一局,要有开始界面、难度递进和结算画面。Opus 做了暴风雨夜里的灯塔,用光束引小船绕开暗礁进港,两分半一局,结算还告诉你差多少分升级;GPT 的星空画圈收星星 30 秒就能通关;Argon 做了一款带首领战、三套升级流派、中途可选技能的完整游戏,乱画一分钟左右就会输。这道题 Argon 和 Opus 打平,明确赢了 GPT。
刻舟求剑和画图标两道题三家全部打平,三家都没犯成语寓意的错,距离测算都在合理误差内。
额度实测与使用建议
12 道大题加上中途被 App 丢弃重跑两次,共 14 次 High 档生成,单题耗时两到九分钟。跑完这 14 次,Pro 账号的时段额度用掉 40%,周额度只用了 2%。对 Pro 用户在 App 里写这个规模的代码来说,额度是充足的。
真正需要记住的是开场那一幕:屏幕上写着零碰撞、回复里写着「已经验证」,但 App 里的 Argon 根本没法打开页面自己检查。拿它产出的东西干活,无论如何先自己在浏览器里跑一遍。等 Argon 将来能像 Opus、GPT 那样在命令行终端里获得权限、能自己打开检查改错时,这 12 道题值得原样重跑一次,看它在完全同等条件下到底有多强。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。