Gemini 4 Argon登顶Text Arena,Anthropic称AI攻克数学难题
Gemini 4 Argon登顶评测榜,Anthropic宣布AI完成数十年悬置的渗流理论猜想证明,AI安全与监管攻防同步升级。
本期AI动态以模型发布、产品更新、数学突破与安全治理四条主线并行推进。Google发布的Gemini 4 Argon在DeepStore测试中以77.9%得分超越GPT-6 Astra,并以约0.62美元的单任务成本登顶Text Arena,体现出性能与成本兼顾的竞争力。Anthropic则宣布其AI给出了渗流理论一项悬置数十年、被认为具菲尔兹奖级分量的猜想完整证明,若经同行验证属实,将标志着AI从数学辅助工具向独立证明者的实质跨越。产品侧,Runway Ads、ComfyAPI、Cloudflare AutoRouter等工具密集落地,WebGPU内核开源进一步降低浏览器端AI部署门槛。与此同时,美国FTC启动对OpenAI、Anthropic及METR的调查,OpenAI拦截针对模型推理内容的大规模提取行动,高级网络攻击能力向开源生态扩散的隐忧也随之浮现。
模型发布与评测:Gemini 4 Argon高调登场
Google发布了面向复杂任务的新模型 Gemini 4 Argon,瞄准软件工程、法律、金融和网络防御等专业场景。在 DeepStore 测试中,该模型拿下 77.9% 的得分,超过了 GPT-6 Astra,并将率先向付费 API 客户和 Google AI Ultra 订阅者开放。
从第三方评测来看,Artificial Analysis 的数据显示 Gemini 4 Argon 的智能指数得分为 53,与 GPT-6 Astra 最高档持平,比 GPT-6.1 Solo 最高档高出一分。更值得关注的是它在竞技场排名上的表现:High 版本登顶 Text Arena,在 Agent Arena 排名第八,净提升分为 7.92%,而每项任务成本约 0.62 美元——这种性能与成本兼顾的表现,正是当下大模型竞争的关键落脚点。
评测方法论本身也在进化。Meta AI 推出 Auto Benchmark,让研究智能体自动生成评测基准,再用这些基准反过来检验模型自身能力。测试发现,智能体生成的难题对新模型同样具有挑战性;而当自动研究陷入停滞时,针对性的人类介入能够改善效果。腾讯会员则联合复旦大学、清华大学发布了探索能力评测工具 Exploration Bench,它构建了一个与常识冲突、规则可验证的"外星世界",要求 AI 通过四轮实验修正假设,检验其从未知规则中学习的能力。
一则值得警惕的监测结果是:某项每日监测发现,DeepSeek广告 Reasoner 自 9 月 10 日起处理相同题目的思考用量升至此前约 10 到 12 倍。这并不代表模型能力下降,但可能显著增加响应耗时和使用成本。被监测的其余 33 个模型暂未发现类似的静默能力变化。
AI产品密集更新:从广告引擎到浏览器端推理
产品层面的动作同样密集。Runway 推出自动广告引擎 Runway Ads,可生成视频和图片广告并直接投放至多个平台,Runway 称内部试用时单订阅获客成本下降了 41%,目前仅向部分企业开放。X 则宣布即将允许用户在 XChat 群聊中加入 Grok,用于回答问题、总结对话等,不过加入期间 X 和 SpaceX AI 将能访问群聊全部消息,群聊会明确标明消息访问权限——这在隐私层面值得用户留意。
Google 已面向全球用户推出 Gemini Skills,帮助处理重复性任务,未来数周还将扩展至更多机构客户。另有报道称,Gemini Gems 计划于 11 月 17 日停用,由 Skills 取代,意味着 Google 正在整合其智能体化功能入口。开源生态也有亮点:Zenova 在 Hugging Face 开源了覆盖 200 多个常见机器学习算子的 WebGPU 内核,支持 AI 模型在浏览器本地运行、无需服务器,有望大幅降低部署门槛。
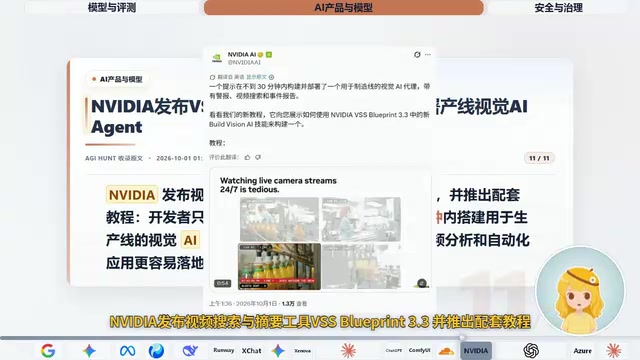
开发者工具链持续完善。ComfyUI 正式推出 ComfyAPI,开发者提交工作流文件后即可一键部署为能自动扩缩容的推理端点,系统会自动打包自定义节点、模型及相关依赖,方便工作流从原型走向实际应用。Cloudflare 在 AI Gateway 推出 AutoRouter 公测版,可按请求需求自动选择够用的模型,用户无需每次手动挑选,官方称这能节省约三成 Token 开支。NVIDIA 则发布视频搜索与摘要工具 VSS Blueprint 3.3 并配套教程,按教程输入一个提示词,开发者约半小时即可搭建产线级视觉 AI 智能体,减少复杂编码。
ChatGPT 个人资料页新增热门插件和网站展示板块,用户可自行设置展示的网站并选择公开显示,且非 Pro 用户也能使用这一功能。
WebGPU 是由 W3C 制定的新一代 Web 图形与计算 API 标准,允许网页直接调用用户设备的 GPU 进行通用并行计算,而无需依赖原生应用或服务器。与此前的 WebGL 相比,WebGPU 提供了更接近底层的计算着色器能力,使在浏览器内运行神经网络推理成为可能。Zenova 开源的 200 多个机器学习算子内核,覆盖了卷积、矩阵乘法、激活函数等模型推理的核心计算原语,意味着开发者可以将经过量化压缩的中小型模型完全部署在客户端浏览器中,数据不离开用户设备,同时消除了服务器算力成本,对隐私敏感或低延迟要求的应用场景具有重要价值。
Anthropic:AI完成渗流理论关键猜想证明
本期最具分量的消息,来自 Anthropic 宣布其 AI 给出了渗流理论一项悬置数十年的关键猜想的完整证明。渗流理论研究的是随机网络在什么条件下会形成大规模贯通结构,这一难题此前被认为具有菲尔兹奖级别的分量。
如果这一成果经同行验证属实,将标志着 AI 在前沿数学研究中从"辅助工具"向"独立证明者"角色的实质跨越。不过,此类重大声明往往需要数学界的严格复核,读者宜保持审慎乐观的态度。
渗流理论(Percolation Theory)是概率论与统计物理的交叉领域,核心问题是:在一个随机网格或网络中,当节点或边以某一概率存在时,整个系统是否会出现一个贯穿全局的连通分量(即"渗流"现象)。经典例子包括液体渗过多孔介质、森林火灾蔓延、疾病在网络中传播等。该理论存在一个"临界阈值",低于阈值时系统呈孤立碎块,超过阈值后大规模连通结构会突然涌现,这种相变行为在数学上极难精确刻画。
菲尔兹奖是数学界最高荣誉之一,每四年颁发一次,授予40岁以下做出突破性贡献的数学家。渗流理论中的若干核心猜想因其证明难度极高,长期被视为与菲尔兹奖级工作相当的挑战。若 Anthropic 的声明经同行评审证实,将是 AI 首次被认定为数学定理的独立证明者,而非辅助工具,其意义远超单纯的解题能力展示。
AI安全与治理:监管收紧,攻击能力外溢
治理层面的信号趋于紧张。据报道,美国联邦贸易委员会计划调查 OpenAI、Anthropic 及安全评估机构 METR,重点关注 AI 智能体失控是否会伤害消费者,委员会拟在未来数周索取具有法律约束力的信息,并要求相关高管宣誓作证,审查范围还将延伸至风险评估环节。
模型安全攻防也在升级。OpenAI 称已拦截针对模型隐藏推理内容的大规模提取行动,并指认有与月之暗面相关的人员参与——该行动从 7 月 1 日开始,两天内涉及 4000 多名用户、约 1.6 万次尝试,OpenAI 已封禁相关账号并加强防护,Anthropic 也称观察到类似行为。安全研究者进一步披露,OpenAI 和 Anthropic 的官方接口已封堵输出重放提取漏洞,但 9 月 13 日的审计发现,经 Azure 调用的同款 OpenAI 模型仍可被攻击,Anthropic Opus 4.8 也存在类似风险。
更深层的隐忧在于开源生态。Anthropic 于 9 月 30 日报告称,某开源模型 GLM5.3 的漏洞利用能力接近 Cloud Mythos Preview,且安全限制容易被绕过,报告认为高级网络攻击能力正向开源生态扩散。不过,该报告的研究方法和发布动机也受到了一些质疑,这场关于开源模型安全边界的讨论恐将持续。
所谓"隐藏推理内容提取"攻击,针对的是链式思维(Chain-of-Thought)模型在生成最终答案前产生的中间推理步骤。部分模型会对用户隐藏这些内部思考过程,但攻击者可通过大量精心构造的提示,诱导模型在输出中泄露或重放被屏蔽的推理片段,从而窃取模型的"思考方式"乃至其中可能包含的敏感信息。OpenAI 和 Anthropic 在官方接口层面修复了此类漏洞,但通过 Azure 等第三方云服务调用同款模型时,防护层并未同步生效,暴露出"同源模型、多渠道部署"架构下安全一致性难以保证的系统性问题。
小结
从 Gemini 4 Argon 的性能—成本平衡,到 Anthropic 声称的数学突破,再到监管与安全攻防的双线升级,本期信息密度极高。模型竞赛已不只是跑分之争,评测方法、部署门槛、安全治理正共同构成更完整的产业图景。
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。