Gemini 4 Argon全面评测:谷歌旗舰模型能否碾压Opus 5.5?

谷歌Gemini 4 Argon发布,跑分领先Opus 5.5,主打多步推理与专业场景落地。
谷歌正式发布旗舰AI模型Gemini 4 Argon(代号R2),据B站UP主评测,其在BOSS INDEX经济领域榜单排名第一,Artificial Analysis智能指数得分53,跑分全面领先竞品Opus 5.5。文章从跑分、能力、应用场景三个维度拆解该模型:升级重点从聊天体验转向复杂推理与深度工作,在编程、金融、法律、网络安全及科学等专业任务中表现突出,可完成单HTML文件《我的世界》克隆版等复杂工程任务;同时谷歌将其定位延伸至机器人控制,体现跨领域泛化能力。不过评测以跑分和单点案例为主,长上下文稳定性、指令遵循一致性等实际体验仍需更多独立验证。
谷歌昨晚正式发布旗舰AI模型Gemini 4 Argon(代号R2),跑分数据全面领先竞品Opus 5.5。据B站UP主评测视频显示,该模型在编程、金融、法律、网络安全及科学等现实任务中表现突出,多步推理的深度与精准度使其在跨领域基础测试中优于其他前沿模型。本文基于公开评测信息,从跑分、能力、应用场景三个维度拆解这款「杀疯了」的新模型。
跑分登顶:BOSS INDEX与Artificial Analysis双榜领先
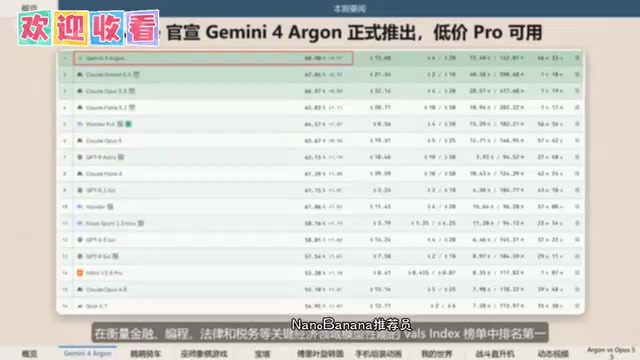
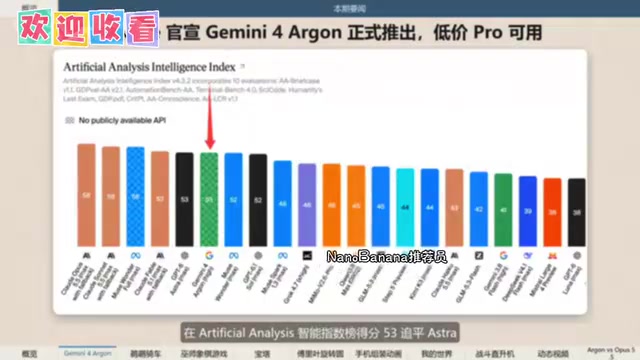
据B站UP主分享的截图,Gemini 4 Argon在衡量金融、编程、法律和税务等关键经济领域模型性能的BOSS INDEX榜单中排名第一。在Artificial Analysis智能指数榜上,该模型得分53,与Astra持平。跑分数据「遥遥领先OPUS 5.5」,成为本次发布最直观的卖点。
提一嘴,跑分领先并不等同于实际体验全面占优。BOSS INDEX聚焦经济领域任务,而Artificial Analysis指数更偏综合智能评估,两个榜单的权重差异意味着Gemini 4 Argon的优势集中在专业场景,而非通用对话。
BOSS INDEX 是一个聚焦模型在金融、编程、法律、税务等经济价值较高领域任务表现的基准榜单,其评测题目通常模拟真实专业工作流,强调模型能否产出可直接用于业务的结果。与通用能力榜单不同,BOSS INDEX 更关注任务完成度与专业准确性,因此得分高低对判断模型能否落地专业场景具有较强参考意义,但也难以反映日常对话、创意写作等非专业任务的表现。
Artificial Analysis 智能指数 则是一个综合性模型能力评分体系,通过聚合多个公开基准测试的结果,对模型的推理、知识、编程等能力进行加权汇总,输出单一分数以便横向比较。其优势在于覆盖面广、更新较快,但权重设计会影响最终排名,不同指数之间的分数不宜直接等同看待。
多步推理深度:从聊天模型到「深度工作」工具
谷歌此次的升级重点不在聊天体验,而是复杂推理与专业知识处理。评测提到,Gemini 4 Argon在多步轴任务中展现出深度与精准度,能够高效完成深度工作。这一定位与当前AI模型从「对话助手」向「生产力工具」演进的趋势一致。
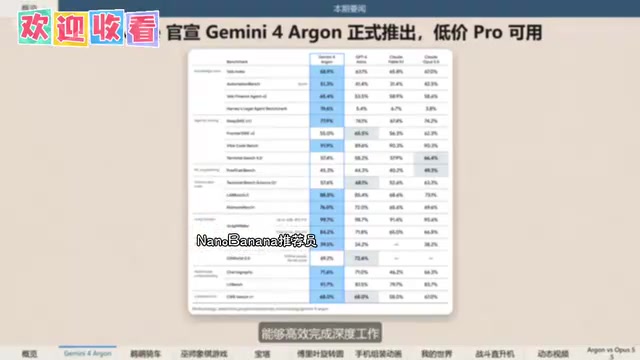
多步任务的难点在于中间步骤的误差累积,模型需要在长链条推理中保持一致性。Gemini 4 Argon在这一维度的提升,直接对应金融分析、法律文书审查、网络安全审计等需要严谨流程的场景。
多步推理(multi-step reasoning) 指模型需要连续完成多个推理步骤才能得到最终答案的任务形式,例如先提取条件、再进行计算、最后校验结论。与单步问答相比,多步推理的难点在于误差会沿推理链累积:中间某一步出现偏差,后续步骤可能被放大,导致最终结果偏离。因此评测多步任务时,通常更关注模型在长链条中保持逻辑一致性和自我纠错的能力,这也是判断模型能否胜任金融分析、法律审查等严谨流程的关键指标。
专业领域实测:金融、法律、编程全面覆盖
在关键经济领域模型性能对比中,Gemini 4 Argon覆盖金融、编程、法律和税务等多个方向。评测者特别提到编程开发能力的增强,并给出一个具体案例:构建一个单HTML文件的《我的世界》克隆版,且要求「制作精美并添加原版游戏的所有功能」。
这类任务考验的是模型对复杂需求的拆解能力、代码组织能力以及对游戏机制的完整理解。单文件约束进一步增加了难度,要求模型在有限结构内实现完整功能。从评测描述看,Gemini 4 Argon在这类任务中表现出了较强的工程落地能力。
机器人控制与跨领域泛化
除了软件层面的能力,谷歌此次还将目标瞄准了真实世界中的机器人控制。这意味着Gemini 4 Argon的定位不只是一个聊天模型或编程助手,而是向具身智能方向延伸。跨领域基础测试中的全面领先,说明模型具备较强的泛化能力,能够在不同任务类型间迁移推理能力。
从评测信息看,Gemini 4 Argon的升级路径清晰:以复杂推理为底座,向专业知识、编程开发、机器人控制三个方向扩展。这种「一底座多场景」的策略,与当前头部AI厂商的竞争逻辑一致。
具身智能(embodied intelligence) 指智能体通过物理身体与环境交互来感知、决策和行动的能力,机器人控制是其典型应用。与传统纯软件模型不同,具身智能要求模型将语言理解、空间推理和动作规划结合起来,把抽象指令转化为具体的运动控制序列。将大模型能力延伸至机器人控制,意味着模型需要具备跨模态的泛化能力,但真实环境的噪声、实时性约束和安全要求,也使这类能力从演示走向实用仍面临较多工程挑战。
评测结论:优势明显,但需理性看待
综合B站UP主的评测信息,Gemini 4 Argon在跑分和专业任务上确实展现出对Opus 5.5的压制力,尤其在金融、法律、编程等经济价值高的领域。但评测内容以跑分和单点案例为主,缺乏大规模实际使用反馈,模型在长上下文稳定性、指令遵循一致性等方面的表现仍有待更多独立验证。
对于开发者和专业用户而言,Gemini 4 Argon值得关注的核心在于多步推理与专业场景落地能力。如果后续开放API并保持定价竞争力,它有望成为深度工作场景的有力候选。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。