Gemini 4 Argon实测:100万Token输出有多强?
Gemini 4 Argon 实测:超长输出与速度突出,前端设计是短板。
谷歌新一代旗舰模型 Gemini 4 Argon 已向 Google AI Pro 订阅用户开放。B站 UP 主“程序员小辉”用俄罗斯方块豪华版和个人番茄钟两个开发任务,将其与 GPT-6 Astra 对比。Argon 定位复杂长链路任务,支持 100 万 Token 输出,官方 19 项测试拿下 13 项第一,Google 内部已用它完成 80 万行 Zircon 内核的 C/C++ 到 Rust 迁移。实测中 Argon 约 5 分钟一次写完俄罗斯方块,速度约为 Astra 的两倍,证明超长输出并非纸面参数;但番茄钟任务中 UI 完成度明显落后。选型上,长文本与代码迁移选 Argon,精细前端选 Astra,终端编程仍可考虑 Claude Opus 5.5。
谷歌新一代旗舰模型 Gemini 4 Argon 已向普通用户开放,只要订阅 Google AI Pro 就能在网页版直接使用。B站UP主“程序员小辉”第一时间做了实测,用两个真实开发任务把它和 GPT-6 Astra 放在一起对比。这篇文章基于他的第一手测试,结合官方公布的数据,梳理 Argon 的真实能力边界。
定位:专攻复杂长链路任务
Argon 是 Google 七个多月以来第一次发布 Flash 级别以上的新模型,核心定位很明确——解决步骤多、链路长的复杂任务。官方划定的重点方向包括软件工程、企业知识工作、网络安全和创意写作。
最能说明问题的是 Google 内部的实际用法:用 Argon 做大型代码迁移,把 C 和 C++ 代码迁到 Rust,其中包括超过 80 万行的 Zircon 内核。这不是跑分,是生产环境的真实工程。
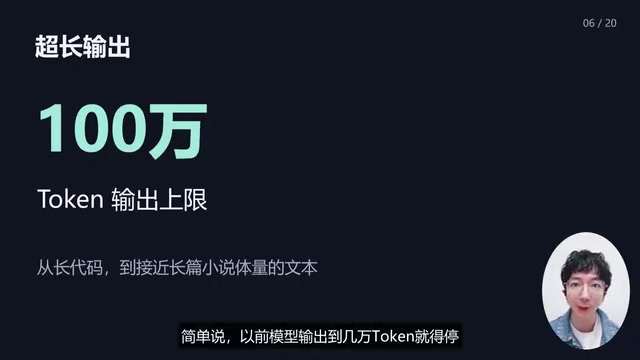
参数层面最夸张的是 100 万 Token 输出上限。以往模型输出到几万 Token 就得停,Argon 理论上能一次生成几十万 Token,体量接近一部长篇小说。官方公布的 19 项测试中,Argon 拿下 13 项第一。
价格方面,11 月 30 日前限时 5 折:输入每百万 Token 2 美元、输出 10 美元;优惠结束后恢复到 4 美元到 20 美元。折扣期内的性价比相当突出。
Token 与输出上限:Token 是模型处理文本的最小单位,大致相当于一个英文单词或半个汉字。模型的“上下文窗口”决定单次能读入多少内容,“最大输出长度”则决定一次能写出多少。早期模型输出通常限制在几千到几万 Token,超出就会被截断。Argon 将输出上限拉到 100 万 Token,意味着它可以在一次生成中完成数十万字的代码或文档,不必分段续写,这对大型代码迁移、整本书稿撰写这类任务意义重大。
Zircon 内核:Zircon 是 Google 为 Fuchsia 操作系统开发的微内核,用 C/C++ 编写,代码量超过 80 万行。将如此规模的底层系统代码迁移到 Rust,涉及内存安全模型的重写、跨语言接口的适配和大量并发逻辑的校验,是公认的高难度工程。Google 内部用 Argon 承担这类迁移,说明其能力已进入生产级验证阶段,而非仅停留在基准测试。
实测一:俄罗斯方块豪华版,速度是Astra的两倍
第一个任务是从零开发一个俄罗斯方块豪华版,要求覆盖 7 种方块旋转、硬降、计分、联机、等级加速、下一方块预览,且所有代码必须写进一个 HTML 文件。
Argon 大约 5 分钟交卷,一次输出 7.4 万字符。成品是像素风格的俄罗斯方块,左右移动、旋转、硬降、联机、下一方块预览全部正常,甚至还有幽灵落点。GPT-6 Astra 用了约 13 分钟、输出 5 万字符,功能同样完整,额外做了双方块预览、本局用时、升级进度条和最高分保存。
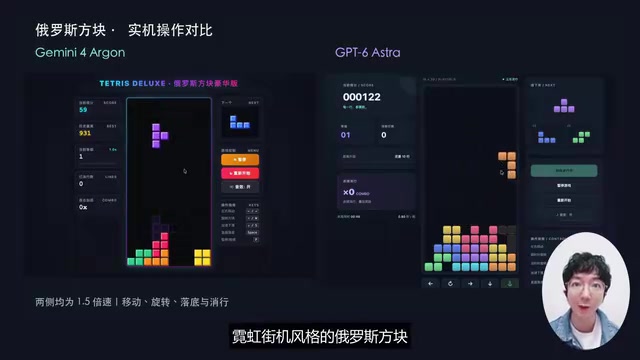
双方都是一次写完,没有截断,也没有明显 bug。差距在速度:Argon 5 分钟,Astra 13 分钟,快了一倍多。这场测试至少证明,100 万 Token 的超长输出不是纸面参数。
幽灵落点(Ghost Piece):这是俄罗斯方块类游戏中的常见辅助功能,会在方块当前下落列的底部显示一个半透明轮廓,预示方块最终落地的位置,帮助玩家判断落点。实现它需要实时计算当前方块与已堆叠方块之间的碰撞距离,并在渲染层额外绘制一个不参与碰撞的虚拟方块。能否正确实现幽灵落点,常被用来检验模型对游戏状态管理和渲染逻辑的理解是否到位。
实测二:个人番茄钟,前端设计是短板
第二个任务开发一个个人番茄钟,重点考察前端设计。GPT-6 Astra 约 4 分钟完成,页面像清新设计的产品落地页:品牌 logo、大标题、圆形计时器、统计卡片、语录卡,整体完成度很高。Argon 约 5 分钟完成,功能全部正常——25 分钟专注、5 分钟休息、开始暂停重置、今日统计、键盘快捷键都有,但 UI 明显弱一截:页面顶部出现一条无法消失的黑色提示条,整体只是简单的居中卡片,视觉层次不如 Astra。
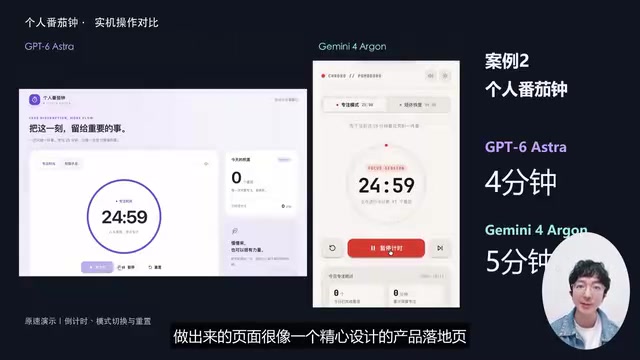
小辉的总结是三点:硬实力强、幻觉率低;超长代码一次写完的能力是真的,速度也快;前端设计不是它最擅长的地方。
番茄钟:番茄工作法是一种时间管理方法,将工作拆分为 25 分钟专注加 5 分钟休息的循环,每个循环称为一个“番茄”。番茄钟应用需要实现倒计时、开始/暂停/重置、专注与休息阶段切换、每日完成统计等状态逻辑,同时往往要求一定的视觉设计。它常被用作前端开发的入门测试题,因为代码量不大,但能同时考察状态管理、计时精度和 UI 完成度。
怎么选:按任务类型分流
根据这轮实测,选型建议可以归纳为:
- 大型代码迁移、深度研究、超长文本写作:Gemini 4 Argon 更值得尝试,输出长度和速度优势明显。
- 精细前端和 UI 设计:GPT-6 Astra 这轮表现更好,视觉完成度和细节处理更到位。
- 命令行、终端类编程任务:Claude Opus 5.5 依然有竞争力。
- 普通问答和查资料:几款模型都够用,差异不构成决策依据。
需要说明的是,以上结论来自单一 UP 主的两个测试任务,样本量有限,前端设计的评价尤其受任务复杂度影响。更稳妥的做法是拿自己的真实工作流跑一轮对照,再决定主用哪个模型。Argon 在折扣期内的价格窗口,倒是提供了一个低成本试错的机会。
相关推荐
双Agent架构破解医疗对话合成难题:患者人设与临床工作流解耦
CoRPS-Dial用双Agent架构解耦患者人设与临床工作流,在冠心病场景下生成更真实、更合规的预问诊对话,下游微调实验验证合成数据实用价值。

可解释歌声情感识别:声学与声乐技巧特征的新框架
一项新研究提出可解释歌声情感识别框架,利用韵律、频谱、语音学与声乐技巧等歌声专属特征,结合SHAP与GRAD-CAM解码模型决策,发现颤音与咽音是情感表达的核心线索,颤音作用还受发音速率调节。

LGMT:用蜕变关系检测大模型逻辑推理的一致性漏洞
LGMT 是一款开源工具,通过基于一阶逻辑的蜕变关系检测大语言模型的推理不一致性,无需真实标签。在六款主流 LLM 上实测,不一致率达 20.84% 至 29.44%,支持 CLI、Web Studio 与离线模式。