Gemini 4 Argon实测:谷歌重回前沿,3D能力略逊Claude

Gemini 4 Argon实测显示谷歌重回前沿第一梯队,知识工作与编码表现亮眼,但3D能力仍逊于Claude Opus和Astra。
一位提前获得访问权限的开发者对谷歌 Gemini 4 Argon 进行了多轮真实项目测试,涵盖赛博朋克 3D 场景、鲁布·戈德堡机械、Excel 克隆和 Fall Guys 游戏克隆。结果显示,Argon 在知识工作基准上较前代提升 14%(71%→85%),Vibe Code Bench 以 91.9% 排名第一,能用简单提示词在 20-30 分钟内生成可运行的复杂项目。但它的 3D 图形能力明显弱于 Claude Opus 和 Astra,超写实渲染始终无法达标,Terminal Bench 也仅 57%,落后 Opus 5.5 的 66.4%。总体而言,谷歌已重回前沿竞争中心,但没有任何模型能通吃所有维度。
Gemini 4 Argon实测:谷歌重回前沿,3D能力略逊Claude
谷歌的 Gemini 4 Argon 终于来了。一位提前一周拿到访问权限的开发者,用一系列真实项目测试了这款模型的实际能力——从赛博朋克3D动画到Excel克隆,从Fall Guys游戏到鲁布·戈德堡机械模拟。结论很明确:谷歌确实回到了前沿模型的第一梯队,但在3D图形领域,它还不是最强的那个。
实测表现:简单提示词下的复杂产出
这位开发者(来自 YouTube 频道)用一组极具挑战性的任务测试了 Argon 的真实上限。
赛博朋克 3D 场景
第一个测试是用 Three.js 构建一个超写实的赛博朋克 3D CD 场景,包含霓虹色彩、飞行汽车和高楼动画,要求至少 30 FPS(最好 60 FPS)。
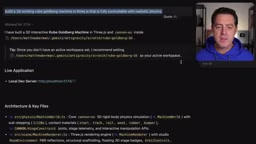
结果令人印象深刻。场景在浏览器中轻松跑到 60 FPS,包含大量 3D 建筑和动画。模型甚至自动提供了主题切换功能——2049琥珀色调、生物合成绿色、红色辛迪加等不同视觉风格,还可以调节霓虹光晕强度、切换超高画质、控制天空交通密度和摄像机模式(自动导演、座舱HUD等)。
用开发者的话说,这来自“一个非常简单的提示词”,耗时约 30 分钟。
Three.js 是目前最主流的 WebGL(Web Graphics Library)封装库,运行在浏览器环境中,用 JavaScript 直接调用 GPU 进行 3D 渲染,无需安装额外插件。它提供了场景图、相机、光照、材质、着色器等完整抽象,使开发者可以只写少量代码就构建出复杂的三维交互场景。文中提到的 60 FPS(每秒帧数)是衡量渲染流畅度的核心指标:人眼在 30 FPS 以上会感知为连续动画,而 60 FPS 则是多数浏览器动画的目标帧率。由于 Three.js 的光照模型以实时光栅化为主,缺乏光线追踪级别的物理精确计算,因此模型生成的内容很难达到照片级真实感——这正是文中 Argon 在“超写实化”提示下仍受限的技术根源。理解这一背景,有助于判断评测中 3D 表现的真正边界:更多是受限于运行环境而非模型本身。
鲁布·戈德堡机械模拟
第二个测试是构建一个完全可控、具有真实物理效果的 3D 鲁布·戈德堡机械。Argon 不仅完成了,还内置了多个主题关卡——客厅、大峡谷、拉斯维加斯、钟表实验室、京都寺庙。
物理模拟的表现相当出色:多米诺骨牌连锁倒下、弹球效果触发、小球滚动带动整个系统。虽然存在一些画面穿模问题,但整体物理逻辑令人满意。开发者指出,模型在收到“让它更复杂”“添加更多真实关卡”的追加提示后,都能准确理解和执行。
但他也坦承一个关键限制:无论怎么提示模型“超写实化”,Argon 都无法达到照片级真实感。这可能受限于浏览器中 Three.js 的能力边界——如果换用 Unreal Engine 或 Blender,效果可能大不相同。
代码能力与基准测试
知识工作基准:大幅跃升
在合作伙伴 Box 提供的知识工作基准测试中,Argon 相较前代 Gemini 3.1 实现了14% 的综合跃升,总分从 71% 提升到 85%。这一测试覆盖数据提取、跨文档关联、法律、生命科学、医疗健康等真实场景。
具体而言,电子表格评估、PDF 提取、演示文稿与图像处理等细分行业基准上,都出现了显著提升。
知识工作基准(Knowledge Work Benchmark)由云内容管理平台 Box 构建,专门用于评估 AI 模型在真实企业场景中的综合能力,而非传统学术问答。其测试任务包括从非结构化 PDF 中抽取关键字段、跨多份文档比对与关联信息、理解法律条款中的条件逻辑、解析生命科学与医疗健康领域的专业文献,以及在电子表格中执行数据清洗、公式推导和图表生成等操作。这类任务的难点在于:文档往往格式混乱、信息分散在多个来源、需要多步推理才能得出正确结论,与纯粹的知识回忆截然不同。Box 引入该基准的背景在于,企业客户最关心的并非模型能否答对考题,而是能否可靠地替代人工完成文档密集型工作。因此,14% 的综合跃升不仅是数字进步,更意味着模型在实际办公自动化场景中的可用性出现了实质提升。
编码基准:稳居第一梯队
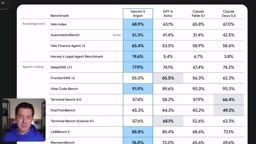
在开发者整理的对比图表中(包含 Astra、Fable 5.1、Opus 5.5 以及后来的 Muse Wonder 和 GPT 6.1 Sol),Argon 的表现如下:
- Deep Sweep:77.9%,仅次于 Muse Wonder Full 的 79%,位居第二
- Vibe Code Bench:91.9%,排名第一
- Terminal Bench:57%,落后于 Opus 5.5 的 66.4%,也低于 Muse 和 Astra
- OS World(计算机控制能力):69%,与 GPT 6.1 Sol 的 71.4% 接近
- Agent's Last Exam:39%,略高于 Opus 的 38%
这些数据显示,Argon 在多数关键基准上稳稳站在前沿,但并非每个维度都是第一。
Excel 克隆:20 分钟的可运行成果
一个颇有说服力的测试是让 Argon 克隆 Excel。由于没有设置循环目标,模型仅运行了约 20 分钟。
结果是一个浏览器端的 Excel 界面,UI 和 UX 都相当完整。双击单元格输入公式=1+2能正确计算,拖动填充、高亮行、求和函数等操作基本可用。开发者评价:“考虑到只有 20 分钟,这运行得相当好,想想都觉得疯狂。”
他由此提出了一个更宏观的判断:软件的未来成本将趋近于零。如果一家公司的护城河仅仅是代码行数,那将非常危险——你需要提供无法被最新模型轻易复制的东西。
Fall Guys 克隆与游戏开发测试
在游戏开发测试中,Argon 用“构建一个 Fall Guys 克隆的完整 parody”这样简单的提示词,就生成了一个可玩的游戏。
开发者表示,他迭代了几次,并设置了“持续迭代直到有 10 个复杂关卡且游戏真正有趣”的目标。最终版本包含完整的关卡设计、角色碰撞、物理效果,甚至结算动画都做得不错。测试过程中他拿到了第一名。
不过他也指出了问题:早期版本存在画面闪烁,部分碰撞检测不够准确(如球体滚动时的碰撞计算)。但随着测试推进,模型自身在迭代中也有所改进。
3D 能力横向对比:不是最强,但已不错
这是整篇评测中最关键的判断。
开发者明确表示:Argon 在 3D 方面比 Meta 新发布的 Muse Wonder 强,但不如 Claude 的 Opus 和 Astra。
以 Unreal Engine 渲染的海洋场景为例,Argon 生成的船只和波浪细节“看起来不错”,但海洋有重复感,且无法潜入水下——而他测试过的其他模型可以做到。
作为对比,Meta 的 Alexander Wang(AI 负责人)曾公开承认,团队“忘记或没有对模型进行 3D 方面的强化学习训练”,事后看来是个错误。但在其他方面(如编码),Muse Wonder 依然很强。
这一对比揭示了一个事实:前沿模型之间的能力差异正在从“谁更强”转向“谁在哪个领域更强”。
Unreal Engine(虚幻引擎)是 Epic Games 开发的专业级实时 3D 创作平台,广泛用于 3A 游戏、影视虚拟制片和建筑可视化。与 Three.js 相比,UE 内置了基于物理的渲染(PBR)、动态全局光照(Lumen)、纳米级几何细节(Nanite)以及复杂的水体与粒子系统,能够实现接近电影级的画面质量。文中用作对比的“Unreal Engine 渲染的海洋场景”正是利用了这些高级特性,因此对模型的 3D 空间理解与代码生成能力提出了更高要求——模型需要生成正确的材质参数、光照配置和波浪模拟逻辑,而不仅仅是摆放几何体。开发者指出 Argon 无法“潜入水下”,很可能是因为模型未能正确生成水面以下的相机穿透与体积雾逻辑。这也解释了为何同一模型在 Three.js 与 Unreal 环境中的表现差异巨大:环境能力越强,对模型空间推理的考验就越严格。
发布节奏与行业格局
Argon 的发布方式有些不同寻常。谷歌提前几周就公布了基准测试和模型信息,但并未立即开放访问,而是先让早期测试者和安全研究人员试用。
从竞争格局看,Google、Meta、OpenAI、Anthropic 现在都已拥有各自的前沿模型。正如开发者所言:“当竞争充分时,赢家是消费者——我们得到更好的模型、更便宜的模型、更快的模型。”
总结:谷歌回到了牌桌上
Gemini 4 Argon 证明谷歌已经重新回到前沿模型的竞争中心。它在知识工作基准上大幅领先前代,在编码任务上稳居第一梯队,能够用简单提示词生成令人印象深刻的 3D 场景和可玩游戏。
但它的 3D 能力与 Opus、Astra 仍有差距,在 Terminal Bench 等关键编码指标上也不是冠军。这不影响它成为一款优秀的前沿模型,但也说明——没有任何一家能通吃所有维度。
对开发者而言,这或许是最好的时代:选择更多,成本更低,能力边界持续被推高。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。